Är din AI-chatt krypterad? ChatGPT, Lumo och DentroChat
För en tid sedan hörde en DentroChat-användare av sig till oss:
Lumo säger att de krypterar alla konversationer. Gör DentroChat samma sak, eller har ni ett annat upplägg?
Frågan fick mig att tänka till, eftersom jag skrev mitt kandidatarbete om kryptografi för några år sedan, och jag ville äntligen skriva ner mina tankar ordentligt. Mitt svar blev ganska långt och tekniskt. Om något blir för tätt kanske du bäst klistrar in den här artikeln i Lumo eller DentroChat och låter en AI förklara det med enklare ord :-)
För att ge ett ordentligt svar på hur krypterad AI-chatt fungerar, tittar vi först på hur Protons kryptering fungerar, sedan på Lumo, och därefter på hur DentroChat och ChatGPT gör.
Så fungerar Protons zero-knowledge-kryptering
Vi är stora fans av Proton-ekosystemet och har använt det aktivt i flera år för VPN, e-post, videosamtal och mycket mer.
Det stora värdet med Proton är deras zero-knowledge-upplägg. Publika och privata nyckelpar härleds från ditt kontolösenord och är unika för varje användare. Den privata nyckeln används för att kryptera våra e-postmeddelanden, Drive-innehåll och så vidare. Bara användaren, alltså vi, kan dekryptera våra egna data på vår lokala enhet. Proton-anställda kan inte dekryptera våra data eftersom de aldrig får tillgång till vår privata nyckel.
Fördelen är att även om NSA skulle ”sitta” inne på en Proton-server, kan de inte komma åt våra data (åtminstone så länge alla andra säkerhetsantaganden håller). Nackdelen är att om vi någon gång tappar bort vårt Proton-lösenord och återställningskoderna, och inte har någon återställningsmetod inställd, kan Proton inte återställa våra data.
Om du vill förstå hur kryptering med publika och privata nycklar fungerar från grunden är den här YouTube-videon om kryptografi med publika nycklar fantastisk. När jag såg den under mitt första år på universitetet blåste den verkligen omkull mig!
Lumo: varför en LLM ändrar bilden
Lumo skiljer sig i grunden från andra Proton-tjänster på grund av hur stora språkmodeller (LLM) fungerar. För att få ett svar från en AI- eller LLM-modell måste du mata in indatan i modellen i klartext, det vill säga dekrypterad. (Det finns sätt att göra detta på ett mer krypterat sätt, mer om det nedan.)
Om du körde en LLM lokalt på din egen dator skulle det klassiska Proton-upplägget ovan fortfarande fungera: dekryptera datan lokalt på din maskin, mata in den i din lokala LLM, få ett svar och kryptera datan igen lokalt. Så gör man när man kör lokala modeller med verktyg som Ollama.
Problemet är att de bästa LLM:erna kräver mycket kraftfulla maskiner, vilket helt enkelt inte är möjligt på en vanlig konsumentdator. Därför måste LLM:en köras på en Proton-server, och dina data måste dekrypteras innan de matas in i Protons LLM.
Vad som händer när du skickar ett meddelande till Lumo
När du använder Lumo fungerar det så här (som beskrivs i Protons säkerhetsmodell för Lumo):
- Du dekrypterar din chatthistorik lokalt på din enhet.
- Du lägger till ett nytt användarmeddelande.
- Hela meddelandehistoriken, tillsammans med ditt nya meddelande, krypteras med den publika nyckeln för Proton-servern där LLM:en körs.
- Dina krypterade data kommer fram till Proton-servern och dekrypteras med serverns privata nyckel. De dekrypterade data matas in i LLM:en och ett svar genereras.
- Det genererade svaret krypteras igen och skickas tillbaka till dig.
- Du dekrypterar det på din enhet och läser svaret.
Givet förutsättningarna är detta ett mycket gediget upplägg.
Det enda är: under inferensen är upplägget inte längre zero-knowledge. Om den schweiziska polisen, NSA eller en skurkaktig Proton-anställd lyssnar inne på Proton-servern där dina data dekrypteras innan de matas in i LLM:en, kan de läsa dina data. Lumo använder inte End-to-End Encryption (E2EE) som de andra Proton-tjänsterna, utan något de kallar User-to-Lumo Encryption (U2L). Där Lumo fortfarande briljerar är att din sparade chatthistorik är krypterad med din nyckel i vila, så ingen på Proton kan läsa dina gamla konversationer i efterhand.
Så gör DentroChat
Vi försökte komma på ett sätt att säkerställa verklig End-to-End Encryption för DentroChat, och vi kom fram till en arkitektur som ligger mycket nära. Men tyvärr var den ekonomiskt inte genomförbar för oss att bygga (ännu).
Vårt nuvarande upplägg är den klassiska krypteringen som används av de flesta moderna appar: kryptering under överföring och kryptering i vila:
- När vi skickar dig dina data, eller du skickar dina data till DentroChat, krypteras trafiken under överföringen med TLS (som använder publika och privata nycklar för att etablera den krypterade anslutningen).
- När dina data lagras på våra servrar i Tyskland krypteras de i vila (vilket vi konfigurerar och hanterar själva, eftersom vanliga hostingleverantörer inte krypterar diskar i vila som standard). Om en angripare kopierar hårddisken på våra servrar får de bara krypterad data.
Vi valde detta upplägg eftersom AI:n, i det ögonblick den svarar på din prompt, har samma kärnförutsättning för förtroende som Lumo: användaren måste lita på att vi inte läser deras data när vi bearbetar den. Vårt nuvarande upplägg var mycket enklare att sätta upp, medan Protons upplägg är mer sofistikerat och lägger fler hinder i vägen för potentiella angripare när det gäller sparad chatthistorik. Vi kanske också går deras väg någon gång om vi ser en tydlig fördel. Just nu är DentroChats upplägg säkert, gediget och har testats under många år av många applikationer.
Så krypterar ChatGPT dina konversationer (och var haken sitter)
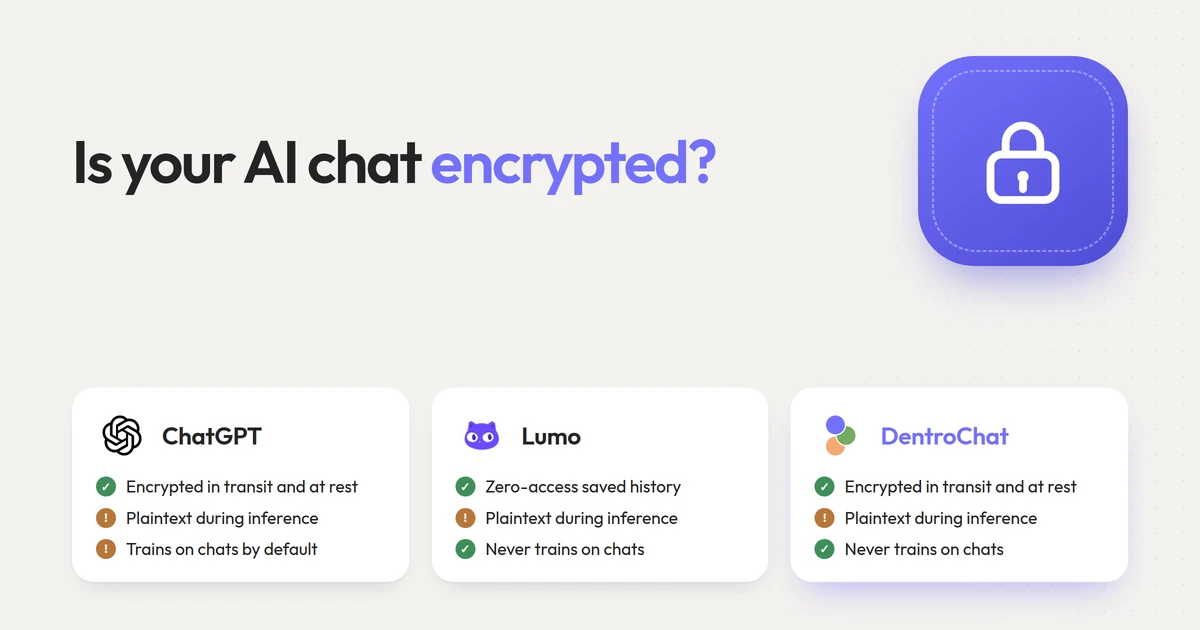
På papper använder ChatGPT exakt samma kryptografiska byggstenar som DentroChat och de flesta molntjänster: kryptering under överföring (TLS) mellan din webbläsare och OpenAI:s servrar, och kryptering i vila (AES-256) på deras diskar. ChatGPT använder inte heller end-to-end-kryptering, eftersom OpenAI:s GPU:er också behöver din prompt i klartext för att generera ett svar.
Skillnaden med ChatGPT handlar om vem som har nycklarna och vad OpenAI tillåts göra med dina data när de dekrypterat dem:
- Modellträning och mänsklig granskning: På ChatGPT Free och Plus används dina dekrypterade konversationer som standard för att träna framtida OpenAI-modeller, och slumpmässigt utvalda chattar kan läsas av mänskliga granskare om du inte manuellt avstår i dina inställningar. Varken Lumo eller DentroChat tränar någonsin på dina chattar.
- Lagring efter radering: Även om du raderar en chatt eller använder ChatGPT:s läge ”Tillfällig chatt” behåller OpenAI en kopia på sina servrar i upp till 30 dagar (vi har gått igenom alla detaljer här).
- Exponering för US CLOUD Act: Eftersom OpenAI har dekrypteringsnycklarna för dina sparade chattar och är ett amerikanskt företag kan amerikanska myndigheter tvinga fram åtkomst enligt US CLOUD Act. Även om din arbetsyta är inställd på EU-datalagring!
| ChatGPT | Proton Lumo | DentroChat | |
|---|---|---|---|
| Krypterad under överföring (TLS) | Ja | Ja | Ja |
| Krypterad i vila | Ja (OpenAI har nycklarna) | Ja (Zero-access, du har nycklarna) | Ja (DentroChat har nycklarna) |
| End-to-end-krypterad under AI-inferens | Nej (klartext på servern) | Nej (klartext på servern, U2L) | Nej (klartext på servern) |
| Tränar AI-modeller på dina chattar | Ja som standard (kan avstås) | Aldrig | Aldrig |
| Omfattas av US CLOUD Act | Ja | Nej för chattar (USA för fakturering/support) | Nej (100 % EU- och schweizisk stack) |
Två sätt att få (nästan) verklig end-to-end-kryptering för AI
Så kan du någonsin köra en LLM i molnet utan att serveroperatören ser din prompt i klartext? Det finns två metoder för riktig E2EE.
1. Homomorf kryptering
Homomorf kryptering är ett fantastiskt forskningsområde. Det gör det möjligt att utföra beräkningar direkt på krypterad data.
Tänk dig att du krypterar talet 12, och en annan användare krypterar talet 17. Båda krypterade talen adderas via en krypterad additionsberäkning. Resultatet är det krypterade talet 29, och bara du och den andra användaren kan faktiskt dekryptera det och se att resultatet är 29. Servern som gjorde uträkningen fick aldrig veta att talen var 12, 17 eller 29.
Exemplet är enkelt, men det kan också fungera för LLM:er. I så fall matar du in krypterad data i LLM:en, LLM:en producerar ett krypterat svar, och bara användaren kan dekryptera svaret. Det pågår seriös akademisk forskning här, till exempel den här nya artikeln om krypterad LLM-inferens (Cachemir).
Problemet med homomorf kryptering är att den är beräkningsmässigt mycket dyr och därför väldigt långsam. Även med de senaste förbättringarna pratar vi om cirka 100 sekunder GPU-tid per genererad token. Det innebär att du skulle få vänta i 30 minuter på ett enkelt svar på „Vad är huvudstaden i Spanien?”
2. NVIDIA H100/H200 Confidential Computing-GPU:er (TEE)
Det andra sättet är att använda NVIDIA H100/H200 Confidential Computing-GPU:er med en Trusted Execution Environment (TEE).
Så här fungerar det: GPU:n har ett eget privat-publikt nyckelpar inbyggt direkt i sin hårdvara. Det skapas en gång när GPU:n tillverkas, och när den väl skapats kan den privata nyckeln inte hämtas utifrån, inte ens av den person som äger serverskåpet.
Detta är bra, eftersom du nu kan kryptera dina data med GPU:ns publika nyckel och skicka dem till servern. GPU:n dekrypterar dem inne i sin egen hårdvaruenklav med sin privata nyckel, matar in dem i LLM:en som körs inne i GPU:n, krypterar svaret igen och skickar tillbaka det till dig.
På så sätt får vi nästan verklig E2EE. Den enda återstående attackvägen i hårdvaran ligger i tillverkningssteget: om NSA registrerade alla privata nycklar när dessa NVIDIA-GPU:er tillverkades i fabriken skulle de teoretiskt sett fortfarande kunna avlyssna och dekryptera trafiken senare, när GPU:n tagits i bruk. En NVIDIA-GPU med en TEE är dock ett mycket starkt säkerhetsantagande.
Vi hade två alternativ för DentroChat: köpa sådana GPU:er själva, eller hitta en europeisk leverantör som erbjuder dem. Det första var för dyrt för oss: en enda H100 kostar cirka 40 000 euro, och för att köra stora öppna modeller med öppna vikter, som de vi har i DentroChat, skulle vi behöva 8 stycken. Som ett självfinansierat företag var det inte möjligt vid den tiden. Att hitta en europeisk leverantör som använder confidential computing-GPU:er var inte heller möjligt för ett halvår sedan. Det här är dock den mest realistiska vägen framåt, och vi letar ständigt efter europeiska AI-infrastrukturleverantörer som stöder det.
Varför vi tycker att DentroChat är ett starkt val vid sidan av Lumo
Även utan zero-access-kryptering för sparad historik (ännu) finns det några skäl till varför många användare väljer DentroChat framför Lumo:
- Bättre AI-modeller: Förra gången vi testade Lumo var svarskvaliteten ganska medioker och långsam. Med DentroChat får du tillgång till de bästa modellerna med öppen källkod och ett skräddarsytt agentramverk under huven.
- Noll amerikanska underleverantörer i hela stacken: Både Lumo och DentroChat kör sin AI-inferens på europeiska och schweiziska servrar. Lumo låter dock fortfarande fakturering och kundsupport gå via amerikanska företag (som Stripe och Zendesk). På DentroChat använder vi inga amerikanska underleverantörer någonstans. Du kan kontrollera hela vår stack på vår sida för underleverantörer.
Om du vill jämföra de två mer i detalj kan du kolla in vårt fullständiga test av Lumo-alternativ, vår guide till privat AI-chatt eller hur europeiska ChatGPT-alternativ står sig. Och om du någon gång har en teknisk fråga som den här, tveka inte att höra av dig via feedbackknappen i DentroChat!
Vanliga frågor
Är ChatGPT end-to-end-krypterat?
Nej. OpenAI krypterar dina konversationer under överföring (TLS) och i vila på sina servrar, vilket är standardnivån för molnappar. Eftersom LLM:en behöver klartext för att generera ett svar dekrypterar OpenAI:s servrar din prompt för att kunna bearbeta den. Om du inte har ett företagsabonnemang eller uttryckligen avstår kan konsumentkonversationer dessutom användas för modellträning.
Är Proton Lumo end-to-end-krypterat?
Inte end-to-end. Lumo använder det Proton kallar User-to-Lumo (U2L)-kryptering: din sparade chatthistorik låses med zero-access-kryptering så att Proton inte kan läsa dina gamla chattar, och din prompt krypteras hela vägen fram till inferensservern. Proton-GPU-servern måste dock fortfarande dekryptera ditt meddelande i minnet för att kunna mata in det i LLM:en.
Hur krypterar DentroChat mina konversationer?
DentroChat krypterar all trafik under överföring med TLS och lagrar dina konversationer och filer med egenhanterad kryptering i vila på europeiska servrar i Tyskland och Frankrike. Precis som Lumo och ChatGPT måste prompter dekrypteras i serverns minne under inferensen så att AI-modellen kan svara på dem, och vi tränar aldrig på dina data.
Kan en AI-chatt någonsin vara verkligt end-to-end-krypterad?
Ja, antingen genom att köra en liten modell lokalt på din egen dator, eller i molnet med homomorf kryptering eller NVIDIA Confidential Computing-GPU:er (TEE). Idag är homomorf kryptering fortfarande alldeles för långsam för interaktiv chatt, medan confidential computing-GPU:er är den mest lovande vägen framåt när europeiska hostingleverantörer gör dem allmänt tillgängliga.