Quanta energia consome um prompt de IA?
Os utilizadores do DentroChat, o nosso assistente de IA da UE, perguntam-nos por vezes quanta eletricidade as suas mensagens gastam. É uma pergunta legítima. Gostaríamos de te mostrar um número no produto, mas as empresas que correm os modelos na cloud na maior parte dos casos ainda não indicam a energia de um pedido. Por isso aproximámo-la o melhor que pudemos com investigação pública.
Isto não são medições de laboratório do DentroChat. Percorremos os estudos que encontrámos e confrontámo-los entre si; os números abaixo são onde convergem. Se tiveres uma fonte melhor, diz-nos.
Eletricidade para um prompt normal
Um prompt típico: fazes uma pergunta e o modelo responde com algumas centenas de tokens. Um token é um pedaço de palavra, ou uma palavra inteira se for curta.
A Google mediu isto. Em maio de 2025, o prompt de texto mediano nas apps Gemini era 0,24 vatios-hora. Isso inclui chip e arrefecimento de toda a nave do data center. Para o prompt mediano, a Google calculou 0,03 gramas de CO2 (com a eletricidade da Google).
A Epoch AI estimou uma resposta típica no ChatGPT em fevereiro de 2025 em cerca de 0,3 vatios-hora, para uma resposta de uns 500 tokens. Dizem que a estimativa fica um pouco alta.
Um artigo na Joule de abril de 2026, com dados de deployments de 2025, estima a mediana num modelo grande em 0,31 vatios-hora. Sam Altman publicou em junho de 2025 que a consulta média no ChatGPT ronda ~0,34 vatios-hora.
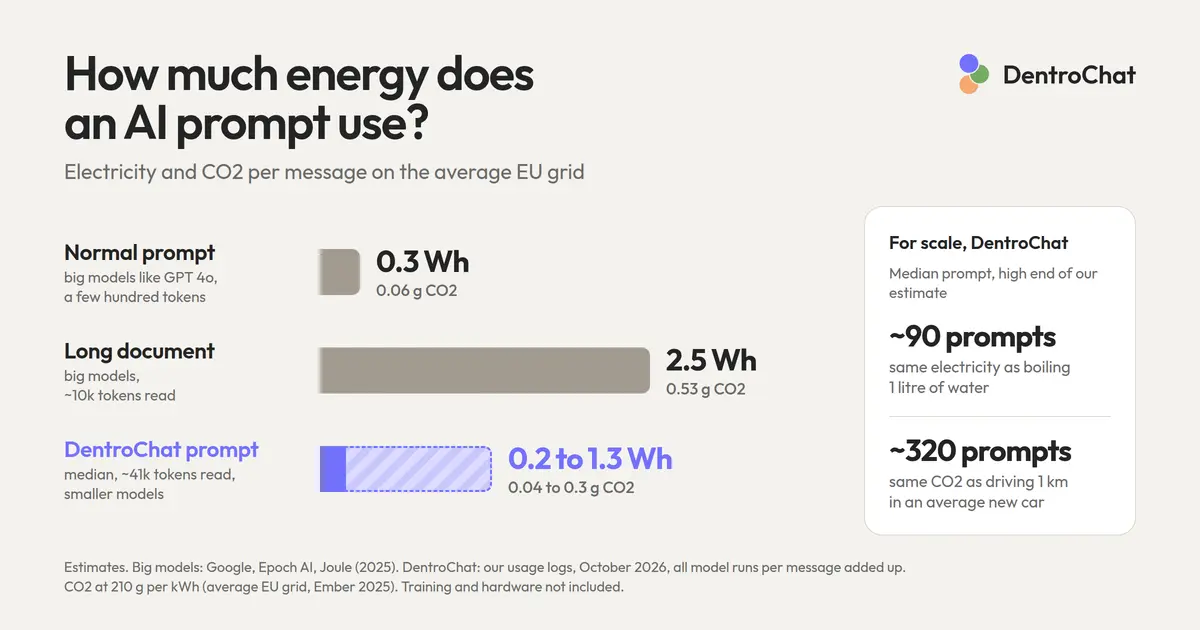
Para um prompt típico diríamos 0,3 vatios-hora. Medição e estimativas caem no mesmo sítio.
Eletricidade para um prompt mais longo
Um documento longo é mais trabalho porque há muito a ler.
A Epoch AI estimou que cerca de 10k tokens de entrada levam a cerca de 2,5 vatios-hora para esse tipo de consulta. Para ver o que isso significa em palavras, contamos tokens nas nossas próprias páginas. Os números aqui usam o tokenizador GPT 4o: cerca de 7.700 palavras em inglês e cerca de 5.800 em alemão, ou seja, um artigo longo ou um chat com muitas mensagens. Mais abaixo passámos as mesmas páginas por outros cinco tokenizadores, e a tabela mostra o quanto se afastam do GPT 4o.
Jegham et al. fizeram a sua estimativa para um prompt assim: 10k de entrada, 1.500 de saída. Entre ~1,4 e 2,9 vatios-hora consoante o modelo. A mesma ordem de grandeza que a Epoch.
Se o modelo pensa muito e escreve milhares de tokens antes de a resposta aparecer, gasta-se mais eletricidade. No artigo Joule colocam uma resposta de cerca de 5k tokens em ~4 vatios-hora. É uma resposta de estilo «reasoning», em que o modelo raciocina muito.
Aqui está tudo numa tabela. São modelos grandes como GPT 4o e Gemini:
| Tipo de prompt | Tokens, aprox. | Eletricidade | Fonte |
|---|---|---|---|
| Prompt normal | pergunta curta, algumas centenas de tokens de volta | ~0,3 Wh | Google, Epoch AI, artigo Joule, Altman |
| Documento longo | ~10k entrada, 500 a 1.500 saída | ~2,5 Wh (1,4 a 2,9) | Epoch AI, Jegham et al. |
| Resposta reasoning | ~5k saída | ~4 Wh | Artigo Joule |
Em resumo: um prompt normal usa cerca de 0,3 vatios-hora. Um documento longo de cerca de 10k tokens usa cerca de 2,5 vatios-hora, entre 1,4 e 2,9 consoante o modelo. Uma resposta reasoning longa de cerca de 5k tokens usa cerca de 4 vatios-hora.
A CO2 depende da rede elétrica
A eletricidade para o mesmo modelo é mais ou menos a mesma onde quer que estejam os servidores. Mas a CO2 depende da rede local.
Tomámos os números da Ember, 2025, visíveis em « Our World in Data ». São números de ciclo de vida: incluem a cadeia de abastecimento elétrico além das emissões da central, em gramas de equivalente CO2 por quilovatio-hora.
Multiplicámos isso pelos nossos dois números, 0,3 Wh para um prompt normal e 2,5 Wh para um documento longo:
| Rede | g CO2e por kWh | Prompt normal | Documento longo |
|---|---|---|---|
| Noruega | 28 | 0,01 g | 0,07 g |
| Suécia | 35 | 0,01 g | 0,09 g |
| França | 41 | 0,01 g | 0,10 g |
| Finlândia | 57 | 0,02 g | 0,14 g |
| Dinamarca | 114 | 0,03 g | 0,29 g |
| Áustria | 117 | 0,04 g | 0,29 g |
| Espanha | 154 | 0,05 g | 0,38 g |
| Média UE | 210 | 0,06 g | 0,53 g |
| Países Baixos | 254 | 0,08 g | 0,63 g |
| Itália | 285 | 0,09 g | 0,71 g |
| Estónia | 319 | 0,10 g | 0,80 g |
| Alemanha | 330 | 0,10 g | 0,82 g |
| Estados Unidos | 384 | 0,12 g | 0,96 g |
| Polónia | 589 | 0,18 g | 1,47 g |
Em resumo: na Suécia (35 g por kWh) e França (41 g), um prompt normal são cerca de 0,01 gramas de CO2 e um documento longo cerca de 0,1 gramas. Na média UE (210 g), um prompt normal cerca de 0,06 gramas e um documento longo cerca de 0,5 gramas. Na Alemanha (330 g), um prompt normal cerca de 0,1 gramas e um documento longo cerca de 0,8 gramas. A Polónia é a mais alta na tabela com 589 g, por isso um prompt normal cerca de 0,18 gramas e um documento longo cerca de 1,5 gramas. Os Estados Unidos estão incluídos porque muitos números do ChatGPT vêm de lá. A 384 g, cerca de 0,12 gramas para um prompt normal e cerca de 1 grama para um documento longo.
Na Alemanha, a agência ambiental diz coisas semelhantes para 2025: 344 g CO2 por kWh da geração e 406 g de equivalente CO2 com a cadeia de abastecimento. Electricity Maps indica para o consumo real de eletricidade na Alemanha 335 g em 2025. Horas isoladas podem ir de ~100 g a ~600 g.
E o DentroChat?
Todos os números até aqui são para modelos grandes como GPT 4o. A Epoch assumia que cerca de 100 mil milhões de parâmetros trabalham em cada token, mas o DentroChat usa muitas vezes modelos mais pequenos. São modelos «mixture of experts»: o modelo é grande, mas só uma parte trabalha em cada token. DeepSeek V4 Flash usa cerca de 13 mil milhões de parâmetros por token, GLM 5.3 Flash cerca de 18 mil milhões e Qwen 3.8 Flash Next cerca de 6 mil milhões.
Menos parâmetros ativos significa menos eletricidade por token e portanto menos CO2 por token. O ranking ML.ENERGY mediu isto nas suas GPU. Um modelo Qwen com 22 mil milhões de parâmetros ativos precisava de cerca de 0,12 Wh por 1.000 tokens escritos. DeepSeek V3.1 com 37 mil milhões cerca de 0,37 Wh. Isso é só as placas gráficas, por isso acrescentámos arrefecimento e o resto dos servidores. Os nossos modelos são mais pequenos que ambos, daí a nossa estimativa:
| Por 1.000 tokens | Parâmetros ativos por token | Escritos | Lidos, frescos | Lidos, em cache | CO2 por 1.000 escritos, média UE |
|---|---|---|---|---|---|
| GPT 4o (suposição Epoch) | ~100 mil milhões | ~0,6 Wh | ~0,2 Wh | ~0,13 g | |
| Modelos DentroChat (nossa estimativa) | 6 a 18 mil milhões | 0,05 a 0,4 Wh | 0,01 a 0,07 Wh | 0,001 a 0,007 Wh | 0,01 a 0,08 g |
Em resumo: para GPT 4o, os números da Epoch dão cerca de 0,6 vatios-hora por cada 1.000 tokens que o modelo escreve e cerca de 0,2 por cada 1.000 que lê. Para os modelos no DentroChat estimamos 0,05 a 0,4 vatios-hora por 1.000 tokens escritos e 0,01 a 0,07 por 1.000 lidos. Se o texto já foi lido há uns minutos, está em cache e custa aproximadamente um décimo. Na rede média UE, 1.000 tokens escritos são cerca de 0,13 gramas de CO2 para GPT 4o e 0,01 a 0,08 gramas para os nossos modelos.
Mas os nossos prompts são maiores que o « prompt normal » nos estudos. Cada mensagem também envia ao modelo as suas instruções e as descrições das ferramentas, já cerca de 3k tokens. Por cima vêm a tua memória, o chat até aqui e ficheiros ou resultados de pesquisa web. Quando o modelo usa uma ferramenta, relê tudo. Por exemplo, decide primeiro pesquisar na web e depois relê todo o chat com os resultados para escrever a resposta. Uma mensagem tua pode significar várias passagens do modelo.
Todos os números na tabela abaixo são por mensagem que envias. Se uma mensagem fez correr o modelo várias vezes, somámos essas passagens numa linha.
Por isso olhámos para os nossos registos de utilização e contamos tokens (o que escreves, claro, não lemos). A tabela usa 606 prompts de um dia de outubro de 2026. Também verificámos os 21.700 prompts dos 30 dias anteriores, e a mediana era muito parecida:
| Prompt DentroChat | Tokens lidos | dos quais em cache | Tokens escritos | Eletricidade (nossa estimativa) | CO2, média UE | CO2, Alemanha |
|---|---|---|---|---|---|---|
| Mediana | ~41k | ~30k | ~900 | 0,2 a 1,3 Wh | 0,04 a 0,3 g | 0,06 a 0,4 g |
| Top 10 % | ~131k | ~66k | ~4.600 | 1 a 7 Wh | 0,2 a 1,4 g | 0,3 a 2,3 g |
Em resumo: o prompt mediano DentroChat lê cerca de 41k tokens, dos quais cerca de 30k em cache porque foram enviados uns minutos antes. Escreve cerca de 900 tokens. Estimamos isso em 0,2 a 1,3 vatios-hora, cerca de 0,04 a 0,3 gramas de CO2 na rede média UE e 0,06 a 0,4 gramas na Alemanha. Os 10 % superiores leem 131k tokens ou mais e escrevem 4.600 ou mais. São cerca de 1 a 7 vatios-hora, ou 0,2 a 1,4 gramas de CO2 na média UE e 0,3 a 2,3 gramas na Alemanha.
Para a linha top 10 % tomámos cada coluna à parte. Um prompt real raramente atinge tudo ao mesmo tempo, por isso a linha fica de propósito do lado pesado.
Há também trabalho em segundo plano, como atualizar a tua memória ou resumir chats longos. Por vezes um modelo é lento e mudamos para um backup a meio. Essas passagens não estão na tabela. Repartidas por todos os prompts, o prompt médio lê cerca de 76k tokens (50k em cache) e escreve cerca de 2k. Isso fica em cerca de 0,4 a 3 vatios-hora.
Um prompt DentroChat lê portanto muito mais que o prompt normal dos estudos. Cada token é mais barato. A mediana DentroChat (0,2 a 1,3 Wh) fica perto do prompt normal dos modelos grandes (0,3 Wh) em baixo e cerca de metade do documento longo deles (2,5 Wh) em cima.
Em comparação: uma chaleira e um trajeto curto
São precisos grosso modo 100 vatios-hora de calor para aquecer um litro de água da torneira até ferver. Parte não chega à água, por isso na tomada são mais 110-125 vatios-hora.
Um prompt mediano DentroChat é uma pequena fração disso. Usamos o extremo alto da nossa estimativa, 1,3 vatios-hora, para a comparação ficar do lado pesado. A esse ritmo precisarias de cerca de 90 prompts DentroChat para igualar um litro.
Para o carro tomamos a média de carros novos em 2025 da Agência Europeia do Ambiente: 96,7 g CO2 por km segundo testes de laboratório. A média inclui elétricos contados a zero no escape, por isso uma gasolina na estrada gastará um pouco mais.
Por cada quilómetro que conduzires nesse carro novo médio podias enviar cerca de 240 prompts medianos DentroChat na Alemanha. Outra vez o extremo alto: 0,4 gramas de CO2 por prompt. Na rede média UE o mesmo prompt são 0,3 gramas, cerca de 320 prompts por quilómetro.
Idioma e tokens
Idiomas diferentes usam números diferentes de tokens para tokenizar a mesma página. Passámos os nossos artigos por tokenizadores das 17 línguas que o DentroChat suporta.
Usámos 22 posts do blog, que existem em cada língua, por isso é o mesmo texto de cada vez. O número principal é o tokenizador GPT 4o. O intervalo é o mínimo e máximo em seis tokenizadores (GPT 4o, GPT 4, Mistral, Llama 3, Qwen 2.5 e DeepSeek V3).
| Língua | Tokens por palavra | Intervalo | Palavras em 10k tokens |
|---|---|---|---|
| Inglês | 1,3 | 1,3 a 1,4 | ~7.700 |
| Espanhol | 1,4 | 1,4 a 1,7 | ~7.200 |
| Português | 1,4 | 1,4 a 1,7 | ~7.000 |
| Francês | 1,4 | 1,4 a 1,7 | ~6.900 |
| Neerlandês | 1,6 | 1,6 a 2,1 | ~6.300 |
| Italiano | 1,7 | 1,7 a 1,9 | ~6.000 |
| Alemão | 1,7 | 1,7 a 2,1 | ~5.800 |
| Norueguês | 1,9 | 1,9 a 2,2 | ~5.400 |
| Sueco | 1,9 | 1,9 a 2,3 | ~5.300 |
| Dinamarquês | 1,9 | 1,9 a 2,3 | ~5.300 |
| Romeno | 1,9 | 1,9 a 2,2 | ~5.300 |
| Croata | 2,1 | 2,1 a 2,6 | ~4.800 |
| Polaco | 2,2 | 2,2 a 2,6 | ~4.500 |
| Grego | 2,4 | 2,4 a 5,9 | ~4.200 |
| Estónio | 2,5 | 2,5 a 3,1 | ~4.000 |
| Húngaro | 2,6 | 2,5 a 3,1 | ~3.900 |
| Finlandês | 2,8 | 2,8 a 3,5 | ~3.600 |
Em resumo: no tokenizador GPT 4o o inglês ronda 1,3 tokens por palavra, por isso 10k tokens são cerca de 7.700 palavras em inglês. Espanhol, português e francês ficam logo atrás com cerca de 1,4. Neerlandês cerca de 1,6, alemão e italiano cerca de 1,7, por isso 10k tokens são cerca de 5.800 palavras em alemão. As línguas nórdicas exceto finlandês rondam 1,9. Estónio cerca de 2,5 e finlandês o mais alto com cerca de 2,8, por isso 10k tokens são só cerca de 3.600 palavras em finlandês.
Muitas vezes se diz que uma palavra alemã são 3 tokens. Em tokenizadores modernos medimos mais 2. O grego tem o intervalo grande porque tokenizadores antigos tratam mal o alfabeto grego.
O documento finlandês, para o mesmo comprimento, usa mais tokens e portanto mais eletricidade. Os g CO2/Wh da rede mantêm-se os da tabela acima.
O que não abordámos
Isto é a eletricidade de uma resposta a uma mensagem.
O treino do modelo foi feito antes de uma vez e partilha-se entre todos os que o usam. Atribuir o custo de treino ao teu prompt seria adivinhar, por isso deixámos de fora.
Há o custo de fabricar as placas gráficas. O breakdown da Nvidia para uma placa H100: 1.312 kg de equivalente CO2 para 8 GPU, ao longo de uns anos de operação. Num prompt só carregas uma fração minúscula, bem abaixo de 1 g. Numa rede limpa como a Suécia, essa fração pode aproximar-se da CO2 da própria eletricidade. Na rede alemã a eletricidade pesa muito mais.
Depois há a água. A afirmação viral de que a IA bebe uma garrafa de água vem de uma estimativa de 2023 para GPT 3: cerca de 500 ml para 20 a 50 respostas, em data centers quentes dos EUA com arrefecimento por evaporação. A Google mediu 0,26 ml para um prompt de texto Gemini mediano (~cinco gotas). Mas muitos data centers europeus arrefecem com ar exterior e usam quase nenhuma água !! Isso inclui a Hetzner na Alemanha, onde o DentroChat está alojado, e os data centers suecos onde correm parte dos nossos modelos. Escrevemos mais em A IA desperdiça água? e com mais pormenor em Consumo de água da IA: porque os números virais enganam.
Há também este ponto prático. Se permaneceres no mesmo chat, o documento longo fica em geral em memória uns minutos. A mensagem seguinte processa sobretudo o texto novo. OpenAI e Anthropic falam ambos de caches que expiram após, tipo, 5-10 minutos de inatividade. Essa é a coluna « em cache » da nossa tabela DentroChat. Também ajuda quando o modelo corre várias vezes por mensagem, porque a segunda passagem pode reutilizar o que a primeira já leu.
Ainda gostaríamos de te mostrar um vatios-hora real por cada mensagem no DentroChat, o melhor EU AI Chat. Para isso, quem corre os modelos teria de nos dar a energia de cada pedido, e a maioria ainda não o faz.
Até lá, esta é a nossa melhor aproximação. Em modelos grandes como GPT 4o, um prompt normal usa cerca de 0,3 vatios-hora e um documento longo cerca de 2,5. Um prompt mediano DentroChat nos nossos modelos mais pequenos usa cerca de 0,2 a 1,3 vatios-hora. Na rede média UE isso é no máximo cerca de 0,3 gramas de CO2.