Czy twój czat z AI jest szyfrowany? ChatGPT, Lumo i DentroChat
Jakiś czas temu skontaktował się z nami użytkownik DentroChat:
Lumo twierdzi, że szyfruje wszystkie rozmowy. Czy DentroChat robi to samo, czy ma inne podejście?
To pytanie trochę mnie sprowokowało, bo kiedyś pisałem pracę licencjacką z kryptografii i w końcu chciałem porządnie spisać swoje przemyślenia. Moja odpowiedź wyszła dość długa i techniczna, więc jeśli coś będzie zbyt gęste, może najlepiej wklej ten artykuł do Lumo albo do DentroChat i pozwól AI wyjaśnić to prościej :-)
Żeby porządnie odpowiedzieć na pytanie, jak działa szyfrowany czat AI, przyjrzyjmy się najpierw szyfrowaniu Protona, potem Lumo, a na końcu temu, jak robią to DentroChat i ChatGPT.
Jak działa szyfrowanie zero-knowledge w Protonie
Jesteśmy wielkimi fanami ekosystemu Protona i od lat aktywnie z niego korzystamy do VPN, poczty, połączeń wideo i nie tylko.
Dużym atutem Protona jest jego architektura zero-knowledge. Pary kluczy publiczny-prywatny są wyprowadzane z hasła do konta i są unikalne dla każdego użytkownika. Klucz prywatny służy do szyfrowania naszych e-maili, plików na Drive itd. Tylko użytkownik, czyli my, może odszyfrować nasze dane na swoim lokalnym urządzeniu. Pracownicy Protona nie mogą odszyfrować naszych danych, bo nigdy nie mają dostępu do naszego klucza prywatnego.
Zaletą jest to, że nawet jeśli NSA „siedzi” w serwerze Protona, nie dostanie naszych danych (przynajmniej dopóki wszystkie pozostałe założenia bezpieczeństwa są spełnione). Wadą jest to, że jeśli kiedykolwiek stracimy hasło do Protona i kody zapasowe, a nie będziemy mieli skonfigurowanej metody odzyskiwania, Proton nie będzie w stanie przywrócić naszych danych.
Jeśli chcesz zrozumieć od podstaw, jak działa szyfrowanie z kluczem publicznym i prywatnym, ten film na YouTube o kryptografii klucza publicznego jest świetny. Kiedy go oglądałem na pierwszym roku studiów, totalnie mnie zmiótł z nóg!
Lumo: dlaczego LLM zmienia obraz
Lumo jest zasadniczo inne niż pozostałe usługi Protona, ze względu na sposób działania dużych modeli językowych (LLM). Żeby dostać odpowiedź od modelu AI/LLM, trzeba wprowadzić dane do modelu w postaci jawnej, czyli odszyfrowanej. (Istnieją sposoby, by robić to w bardziej zaszyfrowany sposób, o tym więcej poniżej).
Gdybyś uruchomił LLM lokalnie na swoim komputerze, klasyczne podejście szyfrowania Protona nadal by działało: odszyfrowujesz dane lokalnie na swoim urządzeniu, wprowadzasz je do lokalnego LLM, dostajesz odpowiedź i ponownie szyfrujesz dane lokalnie. Tak właśnie działa się przy lokalnych modelach uruchamianych za pomocą narzędzi takich jak Ollama.
Problem polega na tym, że najlepsze LLM-y wymagają bardzo mocnych maszyn, co po prostu nie jest realne na przeciętnym komputerze konsumenckim. Dlatego LLM musi działać na serwerze Protona, a twoje dane muszą zostać odszyfrowane, zanim trafią do LLM Protona.
Co się dzieje, gdy wysyłasz wiadomość do Lumo
Kiedy korzystasz z Lumo, działa to tak (zgodnie z dokumentacją w modelu bezpieczeństwa Lumo od Protona):
- Odszyfrowujesz historię swoich czatów lokalnie na swoim urządzeniu.
- Dodajesz nową wiadomość użytkownika.
- Cała historia wiadomości wraz z nową wiadomością zostaje zaszyfrowana kluczem publicznym serwera Protona, na którym działa LLM.
- Twoje zaszyfrowane dane docierają do serwera Protona i zostają odszyfrowane kluczem prywatnym tego serwera. Odszyfrowane dane trafiają do LLM, który generuje odpowiedź.
- Wygenerowana odpowiedź zostaje ponownie zaszyfrowana i wysłana z powrotem do ciebie.
- Odszyfrowujesz ją na swoim urządzeniu i czytasz odpowiedź.
Jest to bardzo solidne podejście, biorąc pod uwagę ograniczenia.
Jedno jest jednak pewne: to podejście nie jest już zero-knowledge podczas wnioskowania (inference). Jeśli szwajcarska policja, NSA albo nieuczciwy pracownik Protona podsłuchuje w serwerze Protona, gdzie twoje dane są odszyfrowywane przed podaniem do LLM, może je odczytać. Lumo nie używa szyfrowania end-to-end (E2EE) tak jak pozostałe usługi Protona, lecz czegoś, co nazwali User-to-Lumo Encryption (U2L). Mocną stroną Lumo jest to, że twoja zapisana historia czatów jest szyfrowana twoim kluczem w spoczynku, więc nikt w Protonie nie przeczyta później twoich starych rozmów.
Jak robi to DentroChat
Próbowaliśmy wymyślić sposób na prawdziwe szyfrowanie end-to-end dla DentroChat i wypracowaliśmy architekturę, która jest bardzo bliska temu celowi. Niestety jej zbudowanie nie było (jeszcze) finansowo wykonalne dla nas.
Nasze obecne podejście to klasyczne szyfrowanie stosowane przez większość nowoczesnych aplikacji: szyfrowanie w transmisji i szyfrowanie w spoczynku:
- Kiedy wysyłamy ci twoje dane albo ty wysyłasz swoje dane do DentroChat, ruch jest szyfrowany w transmisji przy użyciu TLS (który wykorzystuje klucze publiczne i prywatne do nawiązania zaszyfrowanego połączenia).
- Kiedy twoje dane są przechowywane na naszych serwerach w Niemczech, są szyfrowane w spoczynku (co konfigurujemy i zarządzamy sami, bo standardowi dostawcy hostingu domyślnie nie szyfrują dysków w spoczynku). Jeśli atakujący skopiuje dysk twardy naszych serwerów, dostanie tylko zaszyfrowane dane.
Wybraliśmy to podejście, bo w momencie, gdy AI odpowiada na twój prompt, opiera się na tym samym podstawowym założeniu zaufania co Lumo: użytkownik musi zaufać, że nie czytamy jego danych podczas ich przetwarzania. Nasze obecne podejście było dużo łatwiejsze do wdrożenia, a rozwiązanie Protona jest bardziej zaawansowane i stawia więcej przeszkód przed potencjalnymi atakującymi, jeśli chodzi o przechowywaną historię czatów. Być może kiedyś też pójdziemy tą drogą, jeśli zobaczymy wyraźną korzyść. Na razie podejście DentroChat jest bezpieczne, solidne i sprawdzone przez lata w wielu aplikacjach.
Jak ChatGPT szyfruje twoje rozmowy (i gdzie jest haczyk)
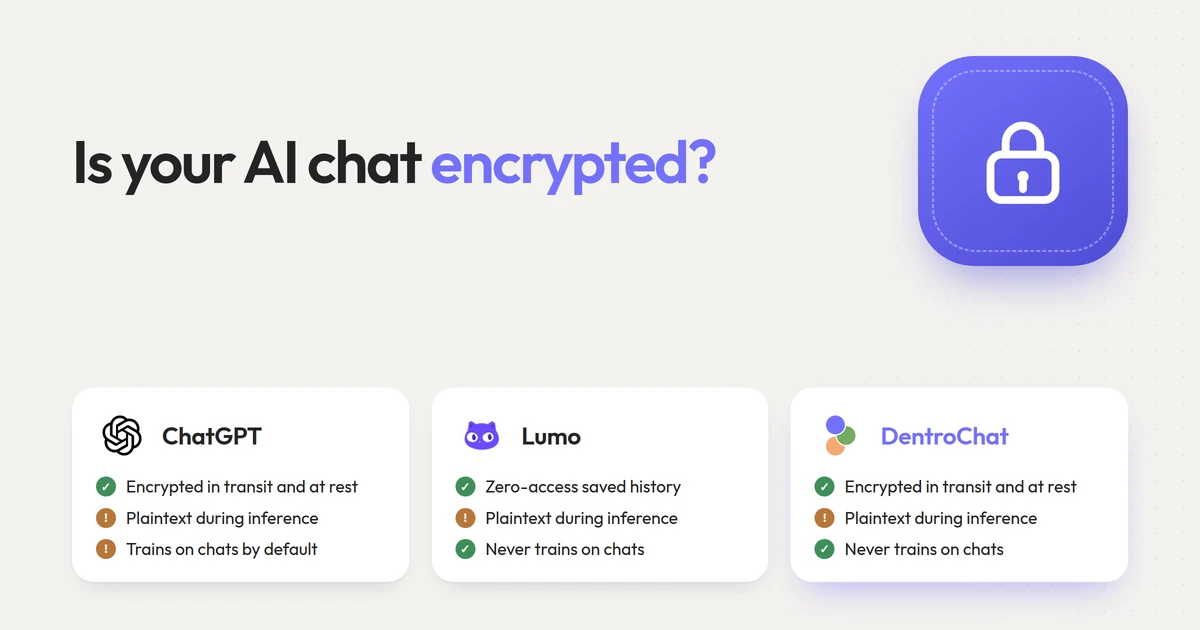
Na papierze ChatGPT używa dokładnie tych samych kryptograficznych podstaw co DentroChat i większość oprogramowania chmurowego: szyfrowania w transmisji (TLS) między przeglądarką a serwerami OpenAI oraz szyfrowania w spoczynku (AES-256) na ich dyskach. ChatGPT również nie używa szyfrowania end-to-end, bo procesory graficzne OpenAI także potrzebują twojego promptu w postaci jawnej, żeby wygenerować odpowiedź.
Różnica w przypadku ChatGPT nie tkwi w tym, kto trzyma klucze i co OpenAI może zrobić z twoimi danymi, kiedy je odszyfruje:
- Trenowanie modeli i ręczna weryfikacja: W ChatGPT Free i Plus twoje odszyfrowane rozmowy są domyślnie używane do trenowania przyszłych modeli OpenAI, a losowo wybrane czaty mogą być czytane przez ludzkich recenzentów, chyba że ręcznie zrezygnujesz w ustawieniach. Ani Lumo, ani DentroChat nigdy nie trenują na twoich czatach.
- Przechowywanie po usunięciu: Nawet jeśli usuniesz czat albo użyjesz trybu „Czat tymczasowy” w ChatGPT, OpenAI zachowuje kopię na swoich serwerach przez maksymalnie 30 dni (szczegółowo opisaliśmy to tutaj).
- Narażenie na US CLOUD Act: Ponieważ OpenAI posiada klucze deszyfrujące do twoich zapisanych czatów i jest amerykańską firmą, amerykańskie władze mogą wymusić dostęp na podstawie US CLOUD Act. Nawet jeśli twoja przestrzeń robocza jest ustawiona na przechowywanie danych w UE!
| ChatGPT | Proton Lumo | DentroChat | |
|---|---|---|---|
| Szyfrowane w transmisji (TLS) | Tak | Tak | Tak |
| Szyfrowane w spoczynku | Tak (OpenAI trzyma klucze) | Tak (Zero-access, ty trzymasz klucze) | Tak (DentroChat trzyma klucze) |
| Szyfrowane end-to-end podczas wnioskowania AI | Nie (dane jawne na serwerze) | Nie (dane jawne na serwerze, U2L) | Nie (dane jawne na serwerze) |
| Trenowanie modeli AI na twoich czatach | Tak domyślnie (rezygnacja) | Nigdy | Nigdy |
| Podlega US CLOUD Act | Tak | Nie w przypadku czatów (USA w przypadku płatności/wsparcia) | Nie (100% stos z UE/Szwajcarii) |
Dwa sposoby na (prawie) prawdziwe szyfrowanie end-to-end dla AI
Czy w ogóle da się uruchomić LLM w chmurze tak, żeby operator serwera nie widział twojego jawnego promptu? Istnieją dwa podejścia do prawdziwego E2EE.
1. Szyfrowanie homomorficzne
Szyfrowanie homomorficzne to niesamowita dziedzina badań. Pozwala wykonywać obliczenia bezpośrednio na zaszyfrowanych danych.
Na przykład: ty szyfrujesz liczbę 12, a inny użytkownik szyfruje liczbę 17. Obie zaszyfrowane liczby są dodawane za pomocą zaszyfrowanego działania dodawania. Wynikiem jest zaszyfrowana liczba 29, a odszyfrować ją i sprawdzić, że wynik to 29, możecie tylko wy oboje. Serwer, który wykonał obliczenia, nigdy nie wiedział, że chodziło o 12, 17 ani 29.
Ten przykład jest prosty, ale może działać także w przypadku LLM. W takim wypadku wprowadzasz zaszyfrowane dane do LLM, LLM zwraca zaszyfrowaną odpowiedź, a tylko użytkownik może ją odszyfrować. Trwają tu poważne badania akademickie, na przykład ten nowy artykuł o szyfrowanym wnioskowaniu LLM (Cachemir).
Problem z szyfrowaniem homomorficznym polega na tym, że jest ono bardzo kosztowne obliczeniowo, a więc bardzo wolne. Nawet przy ostatnich przyspieszeniach mówimy o około 100 sekundach czasu GPU na każdy wygenerowany token, co oznaczałoby, że na prostą odpowiedź na pytanie „Jaka jest stolica Hiszpanii?” musiałbyś czekać 30 minut.
2. Procesory graficzne NVIDIA H100/H200 Confidential Computing (TEE)
Drugie podejście to użycie procesorów graficznych NVIDIA H100/H200 Confidential Computing z zaufanym środowiskiem wykonawczym (TEE).
Działa to tak: procesor graficzny ma własną parę kluczy prywatny-publiczny wbudowaną bezpośrednio w sprzęt. Jest tworzona raz, podczas produkcji GPU, i po jej utworzeniu klucza prywatnego nie da się odczytać z zewnątrz, nawet przez osobę, która jest właścicielem szafy serwerowej.
To świetne, bo teraz możesz zaszyfrować dane kluczem publicznym GPU i wysłać je na serwer. GPU odszyfrowuje je wewnątrz własnej sprzętowej enklawy przy użyciu klucza prywatnego, przekazuje do LLM działającego wewnątrz GPU, ponownie szyfruje odpowiedź i wysyła ją z powrotem do ciebie.
W ten sposób uzyskujemy niemal prawdziwe E2EE. Jedynym pozostałym wektorem ataku sprzętowego jest etap produkcji: gdyby NSA zapisała wszystkie klucze prywatne w trakcie tworzenia tych procesorów NVIDIA w fabryce, teoretycznie mogłaby później przechwytywać i odszyfrowywać ruch, gdy GPU jest już wdrożony. Jednak procesor graficzny NVIDIA z TEE to bardzo mocne założenie dotyczące bezpieczeństwa.
Mieliśmy dwie opcje dla DentroChat: kupić takie GPU samodzielnie albo znaleźć europejskiego dostawcę, który je oferuje. Pierwsza była dla nas za droga: pojedynczy H100 kosztuje około 40 000 €, a żeby uruchomić duże modele o otwartych wagach, takie jak te, które mamy w DentroChat, potrzebowalibyśmy ich 8. Jako firma rozwijająca się z własnych środków nie było to wtedy możliwe. Znalezienie europejskiego dostawcy korzystającego z procesorów Confidential Computing nie było możliwe także pół roku temu. Jednak to najbardziej realistyczna droga naprzód i stale szukamy europejskich dostawców infrastruktury AI, którzy to wspierają.
Dlaczego uważamy, że DentroChat to mocny wybór obok Lumo
Nawet bez zero-access dla zapisanej historii, jest kilka powodów, dla których wielu użytkowników wybiera DentroChat zamiast Lumo:
- Lepsze modele AI: Kiedy ostatnio testowaliśmy Lumo, jakość odpowiedzi była raczej słaba i wolna. W DentroChat masz dostęp do najlepszych modeli open source i dopasowanego do nich środowiska agenta pod maską.
- Zero amerykańskich podwykonawców w całym stosie: Zarówno Lumo, jak i DentroChat uruchamiają wnioskowanie AI na serwerach w Europie i Szwajcarii. Jednak Lumo nadal kieruje płatności i obsługę klienta przez amerykańskie firmy (takie jak Stripe i Zendesk). W DentroChat nie korzystamy z amerykańskich podwykonawców nigdzie. Pełny stos możesz zweryfikować na naszej stronie z podwykonawcami.
Jeśli chcesz porównać te dwa rozwiązania bardziej szczegółowo, zajrzyj do naszego pełnego testu alternatyw dla Lumo, przewodnika po prywatnym czacie AI albo sprawdź, jak wypadają europejskie alternatywy dla ChatGPT. A jeśli kiedykolwiek będziesz mieć techniczne pytanie takie jak to, nie wahaj się napisać do nas przez przycisk opinii w DentroChat!
Często zadawane pytania
Czy ChatGPT jest szyfrowany end-to-end?
Nie. OpenAI szyfruje twoje rozmowy w transmisji (TLS) i w spoczynku na swoich serwerach, co jest standardową podstawą aplikacji chmurowych. Ponieważ LLM potrzebuje danych jawnych, żeby wygenerować odpowiedź, serwery OpenAI odszyfrowują twój prompt, aby go przetworzyć. Chyba że korzystasz z planu biznesowego lub wyraźnie zrezygnujesz, rozmowy konsumenckie mogą być również wykorzystywane do trenowania modeli.
Czy Proton Lumo jest szyfrowany end-to-end?
Nie end-to-end. Lumo używa tego, co Proton nazywa szyfrowaniem User-to-Lumo (U2L): twoja zapisana historia czatów jest zablokowana szyfrowaniem zero-access, więc Proton nie może odczytać starych czatów, a twój prompt jest szyfrowany aż do serwera wnioskowania. Mimo to serwer GPU Protona musi odszyfrować twoją wiadomość w pamięci, żeby przekazać ją do LLM.
Jak DentroChat szyfruje moje rozmowy?
DentroChat szyfruje cały ruch w transmisji przy użyciu TLS, a twoje rozmowy i pliki przechowuje z samodzielnie zarządzanym szyfrowaniem w spoczynku na europejskich serwerach w Niemczech i we Francji. Tak jak Lumo i ChatGPT, prompty muszą zostać odszyfrowane w pamięci serwera podczas wnioskowania, żeby model AI mógł na nie odpowiedzieć, a my nigdy nie trenujemy na twoich danych.
Czy czat z AI może być kiedykolwiek naprawdę szyfrowany end-to-end?
Tak, albo przez uruchomienie małego modelu lokalnie na własnym komputerze, albo w chmurze przy użyciu szyfrowania homomorficznego lub procesorów graficznych NVIDIA Confidential Computing (TEE). Obecnie szyfrowanie homomorficzne jest wciąż zdecydowanie za wolne do interaktywnego czatu, podczas gdy procesory Confidential Computing to najbardziej obiecująca droga naprzód, gdy europejscy dostawcy hostingu udostępnią je szeroko.