Combien d'énergie consomme un prompt IA ?
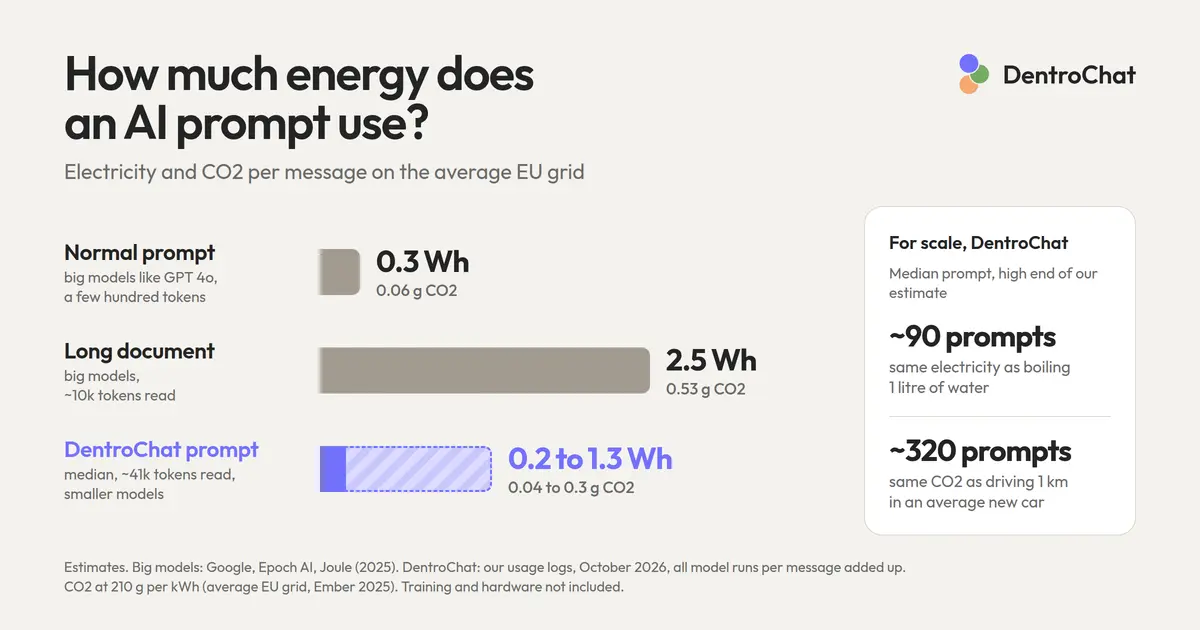
Les utilisateurs de DentroChat, notre assistant IA UE, nous demandent parfois combien d’électricité leurs messages consomment. C’est une question légitime. On aimerait afficher un chiffre dans le produit, mais les entreprises qui font tourner les modèles dans le cloud ne donnent pour la plupart pas encore l’énergie d’une requête. On s’est donc rapproché du mieux possible avec la recherche publique.
Ce ne sont pas des mesures en labo de DentroChat. On a parcouru les études qu’on a trouvées et on les a confrontées entre elles ; les chiffres ci-dessous, c’est là où elles convergent. Si tu as une meilleure source, dis-le nous.
L’électricité pour un prompt normal
Un prompt typique : tu poses une question, le modèle répond en quelques centaines de tokens. Un token, c’est un morceau de mot, ou un mot entier si c’est un mot court.
Google l’a mesuré. En mai 2025, le prompt texte médian dans leurs apps Gemini était de 0,24 watt-heure. Ça inclut puce et refroidissement pour toute la salle du data center. Pour le prompt médian, Google calculait 0,03 gramme de CO2 (sur l’électricité de Google).
Epoch AI a estimé une réponse typique dans ChatGPT en février 2025 à environ 0,3 watt-heure, pour une réponse d’environ 500 tokens. Ils disent que leur estimation est un peu haute.
Un article dans Joule daté d’avril 2026, avec des données de déploiements 2025, estime la médiane pour un grand modèle à 0,31 watt-heure. Sam Altman a écrit en juin 2025 qu’une requête moyenne sur ChatGPT, c’est ~0,34 watt-heure.
Pour un prompt typique, on dirait 0,3 watt-heure. Mesures et estimations tombent au même endroit.
L’électricité pour un prompt plus long
Un long document, c’est plus de travail parce qu’il faut beaucoup lire.
Epoch AI a estimé qu’environ 10k tokens en entrée mènent à environ 2,5 watt-heure pour ce type de requête. Pour voir ce que ça représente en mots, on a compté les tokens sur nos propres pages. Les chiffres ici utilisent le tokenizer GPT 4o : environ 7 700 mots anglais et environ 5 800 mots allemands, donc un long article ou un chat avec beaucoup de messages. Plus bas, on a aussi fait passer les mêmes pages dans cinq autres tokenizers, et le tableau montre à quelle distance ils se situent de GPT 4o.
Jegham et al. ont fait leur propre estimation pour un tel prompt : 10k en entrée, 1 500 en sortie. Entre ~1,4 et 2,9 watt-heure selon le modèle. Donc le même ordre de grandeur qu’Epoch.
Si le modèle réfléchit longtemps et écrit des milliers de tokens avant que la réponse apparaisse, ça consomme plus. Dans l’article Joule, une réponse d’environ 5k tokens est à ~4 watt-heures. C’est une réponse de type « reasoning », où le modèle réfléchit beaucoup.
Voici tout ça dans un tableau. Il s’agit de grands modèles comme GPT 4o et Gemini :
| Type de prompt | Tokens, approx. | Électricité | Source |
|---|---|---|---|
| Prompt normal | question courte, quelques centaines de tokens en retour | ~0,3 Wh | Google, Epoch AI, article Joule, Altman |
| Long document | ~10k en entrée, 500 à 1 500 en sortie | ~2,5 Wh (1,4 à 2,9) | Epoch AI, Jegham et al. |
| Réponse reasoning | ~5k en sortie | ~4 Wh | Article Joule |
En bref : un prompt normal consomme environ 0,3 watt-heure. Un long document d’environ 10k tokens consomme environ 2,5 watt-heures, entre 1,4 et 2,9 selon le modèle. Une longue réponse reasoning d’environ 5k tokens consomme environ 4 watt-heures.
Le CO2 dépend du réseau
L’électricité pour le même modèle est à peu près la même où que soient les serveurs. En revanche, le CO2 dépend du réseau électrique local.
On a pris les chiffres d’Ember, 2025, visibles sur « Our World in Data ». Ce sont des chiffres cycle de vie : ils ajoutent la chaîne d’approvisionnement de l’électricité aux émissions de la centrale, en grammes d’équivalent CO2 par kilowatt-heure.
On a multiplié ça par nos deux chiffres, 0,3 Wh pour un prompt normal et 2,5 Wh pour un long document :
| Réseau | g CO2e par kWh | Prompt normal | Long document |
|---|---|---|---|
| Norvège | 28 | 0,01 g | 0,07 g |
| Suède | 35 | 0,01 g | 0,09 g |
| France | 41 | 0,01 g | 0,10 g |
| Finlande | 57 | 0,02 g | 0,14 g |
| Danemark | 114 | 0,03 g | 0,29 g |
| Autriche | 117 | 0,04 g | 0,29 g |
| Espagne | 154 | 0,05 g | 0,38 g |
| Moyenne UE | 210 | 0,06 g | 0,53 g |
| Pays-Bas | 254 | 0,08 g | 0,63 g |
| Italie | 285 | 0,09 g | 0,71 g |
| Estonie | 319 | 0,10 g | 0,80 g |
| Allemagne | 330 | 0,10 g | 0,82 g |
| États-Unis | 384 | 0,12 g | 0,96 g |
| Pologne | 589 | 0,18 g | 1,47 g |
En bref : en Suède (35 g par kWh) et en France (41 g), un prompt normal, c’est environ 0,01 gramme de CO2 et un long document environ 0,1 gramme. Sur la moyenne UE (210 g), un prompt normal environ 0,06 gramme et un long document environ 0,5 gramme. En Allemagne (330 g), un prompt normal environ 0,1 gramme et un long document environ 0,8 gramme. La Pologne est la plus haute du tableau à 589 g, donc un prompt normal environ 0,18 gramme et un long document environ 1,5 gramme. Les États-Unis sont là parce qu’une bonne partie des chiffres ChatGPT viennent de là. À 384 g, c’est environ 0,12 gramme pour un prompt normal et environ 1 gramme pour un long document.
En Allemagne, l’agence environnementale dit des choses similaires pour 2025 : 344 g CO2 par kWh à la production et 406 g d’équivalent CO2 avec la chaîne d’approvisionnement. Electricity Maps indique pour la consommation réelle d’électricité en Allemagne 335 g en 2025. Une heure isolée peut aller d’environ 100 g à ~600 g.
Et DentroChat ?
Tous les chiffres jusqu’ici concernent les grands modèles comme GPT 4o. Epoch partait du principe qu’environ 100 milliards de paramètres travaillent à chaque token, mais DentroChat utilise souvent des modèles plus petits. Ce sont des modèles « mixture of experts » : le modèle est grand, mais seule une petite partie travaille pour chaque token. DeepSeek V4 Flash utilise environ 13 milliards de paramètres par token, GLM 5.3 Flash environ 18 milliards et Qwen 3.8 Flash Next environ 6 milliards.
Moins de paramètres actifs, c’est moins d’électricité par token, donc moins de CO2 par token. Le classement ML.ENERGY l’a mesuré sur leurs GPU. Un modèle Qwen avec 22 milliards de paramètres actifs demandait environ 0,12 Wh par 1 000 tokens écrits. DeepSeek V3.1 avec 37 milliards environ 0,37 Wh. C’est les cartes graphiques seulement, donc on a ajouté refroidissement et le reste des serveurs. Nos modèles sont plus petits que les deux, d’où notre estimation :
| Par 1 000 tokens | Paramètres actifs par token | Écrits | Lus, frais | Lus, en cache | CO2 pour 1 000 écrits, moyenne UE |
|---|---|---|---|---|---|
| GPT 4o (hypothèse Epoch) | ~100 milliards | ~0,6 Wh | ~0,2 Wh | ~0,13 g | |
| Modèles DentroChat (notre estimation) | 6 à 18 milliards | 0,05 à 0,4 Wh | 0,01 à 0,07 Wh | 0,001 à 0,007 Wh | 0,01 à 0,08 g |
En bref : pour GPT 4o, les chiffres d’Epoch donnent environ 0,6 watt-heure pour chaque 1 000 tokens que le modèle écrit, et environ 0,2 pour chaque 1 000 tokens lus. Pour les modèles dans DentroChat, on estime 0,05 à 0,4 watt-heure par 1 000 tokens écrits et 0,01 à 0,07 par 1 000 tokens lus. Si le texte a déjà été lu quelques minutes avant, il est en cache, et là c’est environ un dixième de plus. Sur le réseau moyen UE, 1 000 tokens écrits, c’est environ 0,13 gramme de CO2 pour GPT 4o et 0,01 à 0,08 gramme pour nos modèles.
Mais nos prompts sont plus gros que le « prompt normal » des études. Chaque message envoie aussi au modèle ses instructions et les descriptions de ses outils, déjà environ 3k tokens. En plus viennent ta mémoire, le chat jusqu’ici, et d’éventuels fichiers ou résultats de recherche web. Quand le modèle utilise un outil, il relit tout ça. Par exemple, il décide d’abord de chercher sur le web, puis il relit tout le chat avec les résultats pour écrire la réponse. Un message de ta part peut donc déclencher plusieurs passages du modèle.
Tous les chiffres du tableau ci-dessous sont par message que tu envoies. Si un message a fait tourner le modèle plusieurs fois, on a additionné ces passages sur une ligne.
On a donc regardé nos propres logs d’usage et compté les tokens (on ne lit évidemment pas ce que tu écris). Le tableau repose sur 606 prompts d’un jour d’octobre 2026. On a aussi vérifié les 21 700 prompts des 30 jours précédents, et la médiane était très proche :
| Prompt DentroChat | Tokens lus | dont en cache | Tokens écrits | Électricité (notre estimation) | CO2, moyenne UE | CO2, Allemagne |
|---|---|---|---|---|---|---|
| Médiane | ~41k | ~30k | ~900 | 0,2 à 1,3 Wh | 0,04 à 0,3 g | 0,06 à 0,4 g |
| Top 10 % | ~131k | ~66k | ~4 600 | 1 à 7 Wh | 0,2 à 1,4 g | 0,3 à 2,3 g |
En bref : le prompt DentroChat médian lit environ 41k tokens, dont environ 30k en cache parce qu’ils avaient été envoyés quelques minutes avant. Il écrit environ 900 tokens. On estime ça à 0,2 à 1,3 watt-heure, soit environ 0,04 à 0,3 gramme de CO2 sur le réseau moyen UE, et 0,06 à 0,4 gramme en Allemagne. Les 10 % les plus lourds lisent 131k tokens ou plus et écrivent 4 600 ou plus. C’est environ 1 à 7 watt-heures, ou 0,2 à 1,4 gramme de CO2 sur la moyenne UE et 0,3 à 2,3 grammes en Allemagne.
Pour la ligne top 10 %, on a pris chaque colonne séparément. Un vrai prompt atteint rarement tout en même temps, donc cette ligne est volontairement du côté lourd.
Il y a aussi du travail en arrière-plan, comme mettre à jour ta mémoire ou résumer de longs chats. Parfois un modèle est trop lent et on bascule à mi-chemin sur un modèle de secours. Ces passages ne sont pas dans le tableau. Répartis sur tous les prompts, le prompt moyen lit environ 76k tokens (50k en cache) et écrit environ 2k. Ça tombe à environ 0,4 à 3 watt-heures.
Un prompt DentroChat lit donc beaucoup plus que le prompt normal des études. Chaque token coûte moins cher. La médiane DentroChat (0,2 à 1,3 Wh) se rapproche du prompt normal des grands modèles (0,3 Wh) en bas, et d’environ la moitié de leur long document (2,5 Wh) en haut.
En comparaison : une bouilloire et un petit trajet
Il faut grosso modo 100 watt-heures de chaleur pour chauffer un litre d’eau du robinet jusqu’à l’ébullition. Une partie ne finit pas dans l’eau, donc à la prise c’est plutôt 110 à 125 watt-heures.
Un prompt DentroChat médian, c’est une petite fraction de ça. On prend le haut de notre estimation, 1,3 watt-heure, pour que la comparaison reste du côté lourd. À ce rythme, il faudrait environ 90 prompts DentroChat pour égaler un litre.
Pour la voiture, on prend la moyenne des voitures neuves en 2025 de l’Agence européenne de l’environnement : 96,7 g CO2 par km selon les tests labo. La moyenne inclut les électriques, comptées à zéro à l’échappement, donc une essence sur la route consommera un peu plus.
Pour chaque kilomètre parcouru dans cette voiture neuve moyenne, tu pourrais envoyer environ 240 prompts DentroChat médians en Allemagne. Encore le haut de la fourchette : 0,4 gramme de CO2 par prompt. Sur le réseau moyen UE, le même prompt fait 0,3 gramme, donc environ 320 prompts par kilomètre.
La langue et les tokens
Les langues n’utilisent pas le même nombre de tokens pour tokeniser la même page. On a passé nos propres articles dans des tokenizers pour les 17 langues que DentroChat prend en charge.
On a utilisé 22 de nos billets de blog, présents dans chaque langue, donc le même texte à chaque fois. Le chiffre principal vient du tokenizer GPT 4o. La plage, c’est le minimum et le maximum sur six tokenizers (GPT 4o, GPT 4, Mistral, Llama 3, Qwen 2.5 et DeepSeek V3).
| Langue | Tokens par mot | Plage | Mots dans 10k tokens |
|---|---|---|---|
| Anglais | 1,3 | 1,3 à 1,4 | ~7 700 |
| Espagnol | 1,4 | 1,4 à 1,7 | ~7 200 |
| Portugais | 1,4 | 1,4 à 1,7 | ~7 000 |
| Français | 1,4 | 1,4 à 1,7 | ~6 900 |
| Néerlandais | 1,6 | 1,6 à 2,1 | ~6 300 |
| Italien | 1,7 | 1,7 à 1,9 | ~6 000 |
| Allemand | 1,7 | 1,7 à 2,1 | ~5 800 |
| Norvégien | 1,9 | 1,9 à 2,2 | ~5 400 |
| Suédois | 1,9 | 1,9 à 2,3 | ~5 300 |
| Danois | 1,9 | 1,9 à 2,3 | ~5 300 |
| Roumain | 1,9 | 1,9 à 2,2 | ~5 300 |
| Croate | 2,1 | 2,1 à 2,6 | ~4 800 |
| Polonais | 2,2 | 2,2 à 2,6 | ~4 500 |
| Grec | 2,4 | 2,4 à 5,9 | ~4 200 |
| Estonien | 2,5 | 2,5 à 3,1 | ~4 000 |
| Hongrois | 2,6 | 2,5 à 3,1 | ~3 900 |
| Finnois | 2,8 | 2,8 à 3,5 | ~3 600 |
En bref : sur le tokenizer GPT 4o, l’anglais, c’est environ 1,3 token par mot, donc 10k tokens valent environ 7 700 mots anglais. L’espagnol, le portugais et le français suivent de près à environ 1,4. Le néerlandais environ 1,6, l’allemand et l’italien environ 1,7, donc 10k tokens valent environ 5 800 mots allemands. Les langues nordiques sauf le finnois tournent autour de 1,9. L’estonien environ 2,5 et le finnois le plus haut à environ 2,8, donc 10k tokens, ce n’est qu’environ 3 600 mots finnois.
On entend souvent qu’un mot allemand fait 3 tokens. Sur les tokenizers modernes, on mesure plutôt 2. Le grec a la grande plage parce que les vieux tokenizers gèrent mal l’alphabet grec.
Le document finnois, pour la même longueur, consomme donc plus de tokens, donc plus d’électricité. Les g CO2/Wh du réseau restent ceux du tableau plus haut.
Ce qu’on n’a pas couvert
Il s’agit ici de l’électricité pour une réponse à un message.
L’entraînement du modèle a eu lieu une fois avant et est partagé entre tous ceux qui l’utilisent. Attribuer le coût d’entraînement à ton prompt, ce serait deviner, donc on l’a laissé de côté.
Il y a le coût de fabrication des cartes graphiques. La fiche Nvidia pour une carte H100 : 1 312 kg d’équivalent CO2 pour 8 GPU, sur quelques années d’exploitation. Pour un prompt, tu ne portes qu’une infime fraction, bien en dessous de 1 g. Sur un réseau propre comme la Suède, cette fraction peut frôler le CO2 de l’électricité elle-même. Sur le réseau allemand, l’électricité pèse beaucoup plus.
Et l’eau. L’affirmation virale selon laquelle l’IA boit une bouteille d’eau vient d’une estimation 2023 pour GPT 3 : environ 500 ml pour 20 à 50 réponses, dans des data centers américains chauds refroidis par évaporation. Google a mesuré 0,26 ml pour un prompt texte Gemini médian (~cinq gouttes). Mais beaucoup de data centers européens refroidissent à l’air extérieur et consomment presque pas d’eau !! Ça inclut Hetzner en Allemagne, où DentroChat est hébergé, et les data centers suédois où tournent une partie de nos modèles. On en dit plus dans L’IA gaspille-t-elle de l’eau ? et plus en détail dans Consommation d’eau de l’IA : pourquoi les chiffres viraux sont trompeurs.
Il y a aussi ce point pratique. Si tu restes dans le même chat, le long document reste en général en mémoire quelques minutes. Le message suivant traite surtout le nouveau texte. OpenAI et Anthropic parlent tous deux de caches qui expirent après, disons, 5 à 10 minutes d’inactivité. C’est la colonne « en cache » de notre tableau DentroChat. Ça aide aussi quand le modèle tourne plusieurs fois pour un message, parce que le second passage peut réutiliser ce que le premier a déjà lu.
On aimerait toujours te montrer un vrai chiffre en watt-heures pour chaque message dans DentroChat, le meilleur chat IA UE. Pour ça, les hébergeurs des modèles devraient nous donner l’énergie de chaque requête, et la plupart ne le font pas encore.
En attendant, c’est notre meilleure approximation. Sur les grands modèles comme GPT 4o, un prompt normal consomme environ 0,3 watt-heure et un long document environ 2,5. Un prompt DentroChat médian sur nos modèles plus petits consomme environ 0,2 à 1,3 watt-heure. Sur le réseau moyen UE, c’est au maximum environ 0,3 gramme de CO2.