Ton chat IA est-il chiffré ? ChatGPT, Lumo et DentroChat
Il y a quelque temps, un utilisateur de DentroChat nous a écrit :
Lumo affirme chiffrer toutes les conversations. DentroChat fait-il la même chose, ou a-t-il une approche différente ?
Cette question m’a un peu interpellé, parce que j’ai rédigé mon mémoire de licence sur la cryptographie à l’époque, et je voulais enfin mettre mes réflexions par écrit correctement. Ma réponse est devenue assez longue et technique. Donc si certains passages te semblent trop denses, colle peut-être cet article dans Lumo ou dans DentroChat et laisse une IA te l’expliquer plus simplement :-)
Pour bien répondre à la question de savoir comment fonctionne un chat IA chiffré, commençons par le chiffrement de Proton, puis celui de Lumo, avant d’examiner la façon dont DentroChat et ChatGPT procèdent.
Comment fonctionne le chiffrement zero-knowledge de Proton
Nous sommes de grands fans de l’écosystème Proton et nous l’utilisons activement depuis des années pour le VPN, les e-mails, les visioconférences et bien d’autres choses.
Le grand atout de Proton, c’est son fonctionnement zero-knowledge. Des paires de clés publique-privée sont dérivées du mot de passe de ton compte et sont propres à chaque utilisateur. Cette clé privée sert à chiffrer nos e-mails, nos fichiers Drive, etc. Seul l’utilisateur, c’est-à-dire nous, peut déchiffrer ses propres données sur son appareil local. Les employés de Proton ne peuvent pas déchiffrer nos données, car ils n’ont jamais accès à notre clé privée.
L’avantage, c’est que même si la NSA se trouve « planquée » dans un serveur Proton, elle ne pourra pas accéder à nos données (du moins tant que toutes les autres hypothèses de sécurité restent valables). L’inconvénient, c’est que si nous perdons un jour notre mot de passe Proton et nos codes de secours, sans méthode de récupération configurée, Proton ne pourra pas restaurer nos données.
Si tu veux comprendre le chiffrement par clés publique-privée depuis les bases, cette vidéo YouTube sur la cryptographie à clé publique est excellente. Quand je l’ai regardée pendant ma première année d’université, elle m’a complètement bluffé !
Lumo : pourquoi un LLM change la donne
Lumo se distingue fondamentalement des autres services Proton à cause du fonctionnement des grands modèles de langage (LLM). Pour obtenir une réponse d’un modèle d’IA, il faut lui transmettre la requête en clair, c’est-à-dire déchiffrée. (Il existe des approches permettant de faire cela de façon plus chiffrée, nous y reviendrons plus bas.)
Si tu faisais tourner un LLM localement sur ton propre ordinateur, l’approche classique de Proton décrite plus haut fonctionnerait toujours : les données sont déchiffrées localement sur ta machine, transmises à ton LLM local, la réponse est générée, puis les données sont à nouveau chiffrées localement. C’est ainsi que cela fonctionne lorsque tu utilises des modèles locaux avec des outils comme Ollama.
Le problème, c’est que les meilleurs LLM nécessitent des machines très puissantes, ce qui n’est tout simplement pas envisageable sur un ordinateur grand public. Le LLM doit donc tourner sur un serveur Proton, et tes données doivent être déchiffrées avant d’être transmises au LLM de Proton.
Ce qui se passe quand tu envoies un message à Lumo
Quand tu utilises Lumo, le processus se déroule ainsi (tel que documenté dans le modèle de sécurité de Lumo chez Proton) :
- Tu déchiffres l’historique de tes conversations localement sur ton appareil.
- Tu ajoutes un nouveau message utilisateur.
- L’ensemble de l’historique, avec ton nouveau message, est chiffré avec la clé publique du serveur Proton sur lequel tourne le LLM.
- Tes données chiffrées arrivent sur le serveur Proton, où elles sont déchiffrées avec la clé privée de ce serveur. Les données déchiffrées sont transmises au LLM, qui génère une réponse.
- La réponse générée est à nouveau chiffrée et renvoyée vers toi.
- Tu la déchiffres sur ton appareil et tu lis la réponse.
C’est une approche très solide compte tenu des contraintes.
Le seul bémol : l’approche n’est plus zero-knowledge pendant l’inférence. Si la police suisse, la NSA ou un employé de Proton malveillant écoute à l’intérieur du serveur où tes données sont déchiffrées avant d’être transmises au LLM, il peut lire tes données. Lumo n’utilise pas le chiffrement de bout en bout (E2EE) comme les autres services Proton, mais ce que Proton appelle le chiffrement User-to-Lumo (U2L). Là où Lumo brille encore, c’est que ton historique de conversations enregistré est chiffré au repos avec ta clé, si bien que personne chez Proton ne peut lire tes anciennes conversations plus tard.
Comment fonctionne DentroChat
Nous avons essayé de concevoir un vrai chiffrement de bout en bout pour DentroChat, et nous sommes arrivés à une architecture très proche de cet objectif. Mais malheureusement, sa construction n’était pas financièrement envisageable pour nous (pour l’instant).
Notre approche actuelle est le chiffrement classique utilisé par la plupart des applications modernes : le chiffrement en transit et le chiffrement au repos :
- Lorsque nous t’envoyons tes données, ou que tu envoies tes données à DentroChat, ce trafic est chiffré en transit grâce à TLS (qui utilise des paires de clés publique-privée pour établir la connexion chiffrée).
- Lorsque tes données sont stockées sur nos serveurs en Allemagne, elles sont chiffrées au repos (une configuration que nous gérons nous-mêmes, car les hébergeurs standard ne chiffrent pas les disques au repos par défaut). Si un attaquant copie le disque dur de nos serveurs, il n’obtient que des données chiffrées.
Nous avons choisi cette approche parce que, au moment où l’IA répond à ta requête, elle repose sur la même hypothèse de confiance fondamentale que Lumo : tu dois nous faire confiance pour ne pas lire tes données pendant leur traitement. Notre approche actuelle était beaucoup plus simple à mettre en place, tandis que celle de Proton est plus sophistiquée et place davantage d’obstacles face aux attaquants qui visent l’historique stocké. Nous pourrions aussi emprunter cette voie un jour, si nous y voyons un avantage clair. Pour le moment, l’approche de DentroChat est sûre, solide et éprouvée depuis des années par de nombreuses applications.
Comment ChatGPT chiffre tes conversations (et où est le piège)
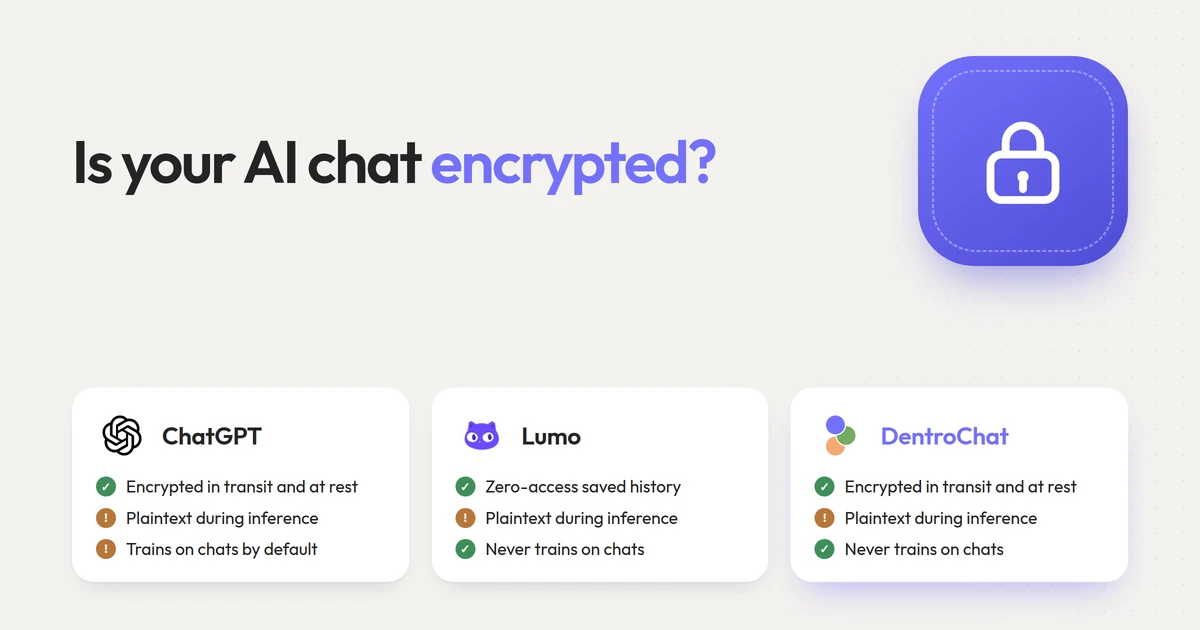
Sur le papier, ChatGPT utilise exactement les mêmes briques cryptographiques que DentroChat et la plupart des logiciels cloud : le chiffrement en transit (TLS) entre ton navigateur et les serveurs d’OpenAI, et le chiffrement au repos (AES-256) sur leurs disques. ChatGPT n’utilise pas non plus le chiffrement de bout en bout, car les GPU d’OpenAI ont eux aussi besoin de ta requête en clair pour générer une réponse.
La différence avec ChatGPT tient à qui détient les clés et ce qu’OpenAI a le droit de faire de tes données une fois déchiffrées :
- Entraînement des modèles et relecture humaine : Avec ChatGPT Free et Plus, tes conversations déchiffrées servent par défaut à entraîner les futurs modèles d’OpenAI, et des conversations sélectionnées au hasard peuvent être lues par des relecteurs humains, sauf si tu te désinscris manuellement dans les paramètres. Ni Lumo ni DentroChat ne s’entraînent jamais sur tes conversations.
- Conservation après suppression : Même si tu supprimes une conversation ou utilises le mode « Chat temporaire » de ChatGPT, OpenAI conserve une copie sur ses serveurs pendant 30 jours au maximum (nous avons détaillé tous les aspects ici).
- Exposition au US CLOUD Act : Comme OpenAI détient les clés de déchiffrement de tes conversations enregistrées et qu’il s’agit d’une entreprise américaine, les autorités américaines peuvent exiger l’accès en vertu du US CLOUD Act. Même si ton espace de travail est configuré pour la résidence des données dans l’UE !
| ChatGPT | Proton Lumo | DentroChat | |
|---|---|---|---|
| Chiffré en transit (TLS) | Oui | Oui | Oui |
| Chiffré au repos | Oui (OpenAI détient les clés) | Oui (Zero-access, tu détiens les clés) | Oui (DentroChat détient les clés) |
| Chiffré de bout en bout pendant l’inférence IA | Non (en clair sur le serveur) | Non (en clair sur le serveur, U2L) | Non (en clair sur le serveur) |
| Entraîne les modèles IA sur tes conversations | Oui par défaut (désactivable) | Jamais | Jamais |
| Soumis au US CLOUD Act | Oui | Non pour les conversations (US pour la facturation et le support) | Non (pile 100 % UE / Suisse) |
Deux façons d’obtenir un chiffrement de bout en bout (presque) réel pour l’IA
Peut-on vraiment faire tourner un LLM dans le cloud sans que l’opérateur du serveur voie ta requête en clair ? Il existe deux approches pour un véritable E2EE.
1. Le chiffrement homomorphe
Le chiffrement homomorphe est un domaine de recherche passionnant. Il permet d’effectuer des calculs directement sur des données chiffrées.
Par exemple : tu chiffres le nombre 12, et un autre utilisateur chiffre le nombre 17. Les deux nombres chiffrés sont additionnés grâce à un calcul d’addition sur données chiffrées. Le résultat est le nombre chiffré 29, et seuls toi et l’autre utilisateur pouvez le déchiffrer pour découvrir que le résultat est 29. Le serveur qui a effectué le calcul n’a jamais su que les nombres étaient 12, 17 ou 29.
Cet exemple est simple, mais il peut aussi fonctionner avec des LLM. Dans ce cas, tu transmets des données chiffrées au LLM, le LLM produit une réponse chiffrée, et seul l’utilisateur peut la déchiffrer. La recherche académique fait des progrès importants dans ce domaine, comme le montre cet article récent sur l’inférence LLM chiffrée (Cachemir).
Le problème du chiffrement homomorphe, c’est qu’il est très coûteux en calcul, donc très lent. Même avec les récentes accélérations, il faut compter environ 100 secondes de temps GPU par jeton généré, ce qui signifie qu’il faudrait patienter 30 minutes pour une réponse simple à « Quelle est la capitale de l’Espagne ? ».
2. Les GPU NVIDIA H100/H200 en informatique confidentielle (TEE)
La seconde approche consiste à utiliser les GPU NVIDIA H100/H200 en informatique confidentielle, avec un environnement d’exécution de confiance (TEE, Trusted Execution Environment).
Le fonctionnement est le suivant : le GPU possède sa propre paire de clés privée-publique, intégrée directement dans son matériel. Elle est créée une seule fois lors de la fabrication du GPU, et une fois créée, la clé privée ne peut pas être extraite de l’extérieur, pas même par la personne qui possède le rack serveur.
C’est formidable, car tu peux désormais chiffrer tes données avec la clé publique du GPU et les envoyer au serveur. Le GPU les déchiffre à l’intérieur de son enclave matérielle grâce à sa clé privée, les transmet au LLM qui tourne dans le GPU, chiffre à nouveau la réponse et te la renvoie.
De cette manière, nous obtenons un E2EE quasi réel. Le seul vecteur d’attaque matériel restant se situe à l’étape de fabrication : si la NSA a enregistré toutes les clés privées pendant que ces GPU NVIDIA étaient fabriqués en usine, elle pourrait théoriquement intercepter et déchiffrer le trafic plus tard, une fois le GPU déployé. Cependant, un GPU NVIDIA avec TEE repose sur une hypothèse de sécurité très forte.
Nous avions deux options pour DentroChat : acheter nous-mêmes de tels GPU, ou trouver un fournisseur européen qui en propose. La première était trop coûteuse pour nous : un seul H100 coûte environ 40 000 €, et pour faire tourner de grands modèles à poids ouverts comme ceux que nous utilisons dans DentroChat, il nous en faudrait 8. En tant qu’entreprise autofinancée, c’était impossible à l’époque. Trouver un fournisseur européen proposant des GPU en informatique confidentielle n’était pas non plus possible il y a six mois. Cependant, c’est la voie la plus réaliste pour l’avenir, et nous cherchons constamment des fournisseurs européens d’infrastructure IA qui la prennent en charge.
Pourquoi nous pensons que DentroChat est un excellent choix aux côtés de Lumo
Même sans chiffrement zero-access sur l’historique enregistré pour le moment, il y a plusieurs raisons pour lesquelles beaucoup d’utilisateurs choisissent DentroChat plutôt que Lumo :
- De meilleurs modèles IA : la dernière fois que nous avons testé Lumo, la qualité des réponses était plutôt décevante et lente. Avec DentroChat, tu accèdes aux meilleurs modèles open source et à un environnement d’agents sur mesure en coulisse.
- Aucun sous-traitant américain dans toute la pile : Lumo comme DentroChat exécutent leur inférence IA sur des serveurs européens et suisses. Cependant, Lumo fait encore passer la facturation et le support client par des entreprises américaines (comme Stripe et Zendesk). Chez DentroChat, nous n’utilisons aucun sous-traitant américain, nulle part. Tu peux vérifier l’ensemble de notre pile sur notre page sous-traitants.
Si tu veux comparer les deux en détail, consulte notre test complet des alternatives à Lumo, notre guide sur le chat IA privé, ou encore la comparaison des alternatives européennes à ChatGPT. Et si tu as une question technique comme celle-ci, n’hésite pas à nous écrire via le bouton de retour d’information dans DentroChat !
Questions fréquentes
ChatGPT est-il chiffré de bout en bout ?
Non. OpenAI chiffre tes conversations en transit (TLS) et au repos sur ses serveurs, ce qui constitue le socle standard des applications cloud. Comme le LLM a besoin du texte en clair pour générer une réponse, les serveurs d’OpenAI déchiffrent ta requête pour la traiter. Sauf si tu as un forfait professionnel ou que tu te désinscris explicitement, les conversations des particuliers peuvent aussi servir à l’entraînement des modèles.
Proton Lumo est-il chiffré de bout en bout ?
Pas de bout en bout. Lumo utilise ce que Proton appelle le chiffrement User-to-Lumo (U2L) : ton historique enregistré est protégé par un chiffrement zero-access, de sorte que Proton ne peut pas lire tes anciens chats, et ta requête est chiffrée jusqu’au serveur d’inférence. Cependant, le serveur GPU de Proton doit tout de même déchiffrer ton message en mémoire pour le transmettre au LLM.
Comment DentroChat chiffre-t-il mes conversations ?
DentroChat chiffre tout le trafic en transit grâce à TLS, et enregistre tes conversations et tes fichiers avec un chiffrement au repos géré par nos soins, sur des serveurs européens situés en Allemagne et en France. Comme pour Lumo et ChatGPT, les requêtes doivent être déchiffrées en mémoire serveur pendant l’inférence pour que le modèle IA puisse y répondre, et nous ne nous entraînons jamais sur tes données.
Un chat IA peut-il un jour être vraiment chiffré de bout en bout ?
Oui, soit en faisant tourner un petit modèle localement sur ton propre ordinateur, soit dans le cloud grâce au chiffrement homomorphe ou aux GPU NVIDIA en informatique confidentielle (TEE). Aujourd’hui, le chiffrement homomorphe est encore bien trop lent pour un chat interactif, tandis que les GPU en informatique confidentielle constituent la voie la plus prometteuse, dès que les hébergeurs européens les proposeront largement.