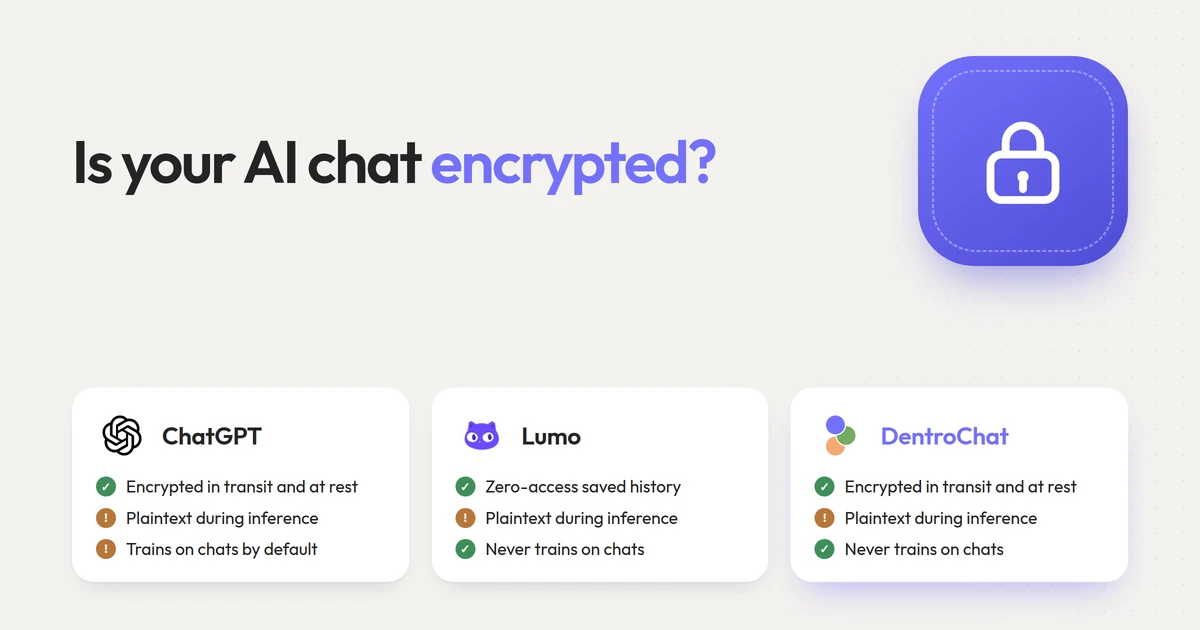
Onko AI-chatisi salattu? ChatGPT, Lumo ja DentroChat
Jokin aika sitten DentroChatin käyttäjä otti meihin yhteyttä:
Lumo sanoo salaavansa kaikki keskustelut. Tekeekö DentroChat saman, vai onko teillä jokin muu lähestymistapa?
Kysymys sai minut miettimään, sillä kirjoitin aikoinaan kandidaatintutkielmani kryptografiasta, ja halusin vihdoin kirjata ajatukseni kunnolla ylös. Vastauksestani tuli melko pitkä ja tekninen. Jos jokin kohta käy liian tiheäksi, voi olla parasta liittää tämä artikkeli Lumoon tai DentroChatiin ja pyytää tekoälyä selittämään se yksinkertaisemmin :-)
Jotta vastaus siihen, miten salattu AI-chat toimii, on kunnollinen, katsotaan ensin, miten Protonin salaus toimii, sitten Lumoa, ja lopuksi sitä, miten DentroChat ja ChatGPT tekevät asian.
Miten Protonin zero-knowledge-salaus toimii
Olemme suuria Proton-ekosysteemin fanejä, ja olemme käyttäneet sitä aktiivisesti vuosia VPN:ään, sähköpostiin, videopuheluihin ja muuhun.
Protonin suuri valttikortti on sen zero-knowledge-rakenne. Julkiset ja yksityiset avainparit johdetaan tilisi salasanasta, ja ne ovat jokaiselle käyttäjälle yksilölliset. Yksityistä avainta käytetään sähköpostiemme, Driven sisällön ja muun salaamiseen. Vain käyttäjä eli me voimme purkaa omat tietomme omalla laitteellamme. Protonin työntekijät eivät voi purkaa tietojamme, koska he eivät koskaan saa käsiinsä yksityistä avaintamme.
Hyvä puoli on, että vaikka NSA olisi ”istumassa” Protonin palvelimella, se ei pääse käsiksi tietoihimme (ainakaan niin kauan kuin muut turvaoletukset pitävät). Huono puoli on, että jos joskus menetämme Protonin salasanamme ja varmuuskoodit, eikä palautustapaa ole määritetty, Proton ei voi palauttaa tietojamme.
Jos haluat ymmärtää julkisen ja yksityisen avaimen salauksen alusta alkaen, tämä YouTube-video julkisen avaimen kryptografiasta on loistava. Kun katsoin sen yliopiston ensimmäisenä vuonna, se todella räjäytti pääni!
Lumo: miksi LLM muuttaa kuvaa
Lumo eroaa muista Proton-palveluista perustavanlaatuisesti siksi, miten suuret kielimallit (LLM) toimivat. Jotta tekoälymallilta saa vastauksen, syöte on syötettävä mallille selkokielisenä eli purettuna. (Tähän on tapoja tehdä se salatummin, lisää niistä alempana.)
Jos ajaisit LLM:n paikallisesti omalla tietokoneellasi, edellä kuvattu klassinen Proton-lähestymistapa toimisi edelleen: purat tiedot paikallisesti laitteellasi, syötät ne paikalliseen LLM:ääsi, saat vastauksen ja salaat tiedot uudelleen paikallisesti. Näin toimitaan, kun ajetaan paikallisia malleja työkaluilla kuten Ollama.
Ongelma on, että parhaat LLM:t tarvitsevat erittäin tehokkaita koneita, eikä niitä yksinkertaisesti voi ajaa tavallisella kuluttajatietokoneella. Siksi LLM:n täytyy toimia Protonin palvelimella, ja tietosi on purettava ennen kuin ne syötetään Protonin LLM:ään.
Mitä tapahtuu, kun lähetät viestin Lumolle
Kun käytät Lumoa, se toimii näin (kuten Protonin Lumo-turvamallissa kuvataan):
- Purat keskusteluhistoriasi paikallisesti laitteellasi.
- Lisäät uuden käyttäjäviestin.
- Koko viestihistoria uuden viestisi kanssa salataan sen Protonin palvelimen julkisella avaimella, jolla LLM toimii.
- Salatut tietosi saapuvat Protonin palvelimelle ja puretaan palvelimen yksityisellä avaimella. Puretut tiedot syötetään LLM:ään, ja siitä syntyy vastaus.
- Syntynyt vastaus salataan uudelleen ja lähetetään sinulle takaisin.
- Purat sen laitteellasi ja luet vastauksen.
Olosuhteet huomioon ottaen tämä on erittäin vankka lähestymistapa.
Yksi asia on kuitenkin: päättelyn aikana lähestymistapa ei ole enää zero-knowledge. Jos Sveitsin poliisi, NSA tai pahantahtoinen Protonin työntekijä kuuntelee Protonin palvelimella, jossa tietosi puretaan ennen kuin ne syötetään LLM:ään, he voivat lukea tietosi. Lumo ei käytä End-to-End Encryptionia (E2EE) kuten muut Protonin palvelut, vaan jotain, mitä he kutsuvat nimellä User-to-Lumo Encryption (U2L). Lumon vahvuus on kuitenkin siinä, että tallennettu keskusteluhistoriasi on salattu avaimellasi levylle tallennettuna, joten kukaan Protonilla ei voi myöhemmin lukea vanhoja keskustelujasi.
Miten DentroChat tekee sen
Yritimme keksiä tavan taata todellinen End-to-End Encryption DentroChatille, ja päädyimme arkkitehtuuriin, joka on hyvin lähellä sitä. Valitettavasti sen rakentaminen ei ollut taloudellisesti mahdollista meille (vielä).
Nykyinen lähestymistapamme on klassinen salaus, jota useimmat modernit sovellukset käyttävät: salaus siirron aikana ja salaus levyllä:
- Kun lähetämme sinulle tietosi tai lähetät tietosi DentroChatille, liikenne salataan siirron aikana TLS:llä (joka käyttää julkisia ja yksityisiä avaimia salatun yhteyden muodostamiseen).
- Kun tietosi tallennetaan palvelimillemme Saksaan, ne salataan levyllä (sen konfiguroimme ja hallinnoimme itse, koska tavalliset hostauspalvelut eivät oletuksena salaa levyjä). Jos hyökkääjä kopioi palvelimiemme kiintolevyn, hän saa vain salattua dataa.
Valitsimme tämän tavan, koska juuri sillä hetkellä, kun tekoäly vastaa kehotteeseesi, sillä on sama ydinluottamusoletus kuin Lumolla: käyttäjän täytyy luottaa siihen, ettemme lue hänen tietojaan niitä käsitellessämme. Nykyinen lähestymistapamme oli paljon yksinkertaisempi pystyttää, kun taas Protonin lähestymistapa on hienostuneempi ja asettaa tallennetun keskushistorian kanssa enemmän esteitä mahdollisille hyökkääjille. Saatamme myös joskus kulkea heidän tietään, jos näemme selvän hyödyn. Tällä hetkellä DentroChatin lähestymistapa on turvallinen, vankka ja monien sovellusten koetteleman vuosien testaama.
Miten ChatGPT salaa keskustelusi (ja missä kiikka on)
Paperilla ChatGPT käyttää täsmälleen samoja kryptografisia rakennuspalikoita kuin DentroChat ja useimmat pilvipalvelut: salaus siirron aikana (TLS) selaimesi ja OpenAI:n palvelimien välillä sekä salaus levyllä (AES-256) niiden levyillä. ChatGPT ei myöskään käytä end-to-end-salausta, koska OpenAI:n GPU:t tarvitsevat myös kehotteesi selkokielisenä, jotta ne voivat tuottaa vastauksen.
Erot ChatGPT:n kanssa koskevat sitä, kuka hallitsee avaimia ja mitä OpenAI saa tehdä tiedoillasi, kun se on purkanut ne:
- Mallien koulutus ja ihmisarviointi: ChatGPT Freessä ja Plussassa purettuja keskustelujasi käytetään oletuksena tulevien OpenAI-mallien koulutukseen, ja ihmisarvioijat voivat lukea satunnaisesti valittuja keskusteluja, ellet poista käytöstä asetuksissasi. Lumo ja DentroChat eivät koskaan kouluta malleja keskusteluillasi.
- Säilytys poiston jälkeen: Vaikka poistaisit keskustelun tai käyttäisit ChatGPT:n ”Väliaikaista keskustelua”, OpenAI säilyttää kopion palvelimillaan jopa 30 päivää (kävimme kaikki yksityiskohdat läpi täällä).
- Altistuminen US CLOUD Actille: Koska OpenAI hallitsee tallennettujen keskustelujesi purkuavaimia ja on yhdysvaltalainen yritys, Yhdysvaltain viranomaiset voivat pakottaa pääsyn US CLOUD Actin nojalla. Vaikka työtilasi olisi asetettu EU:n sisäiseen tietojen sijaintiin!
| ChatGPT | Proton Lumo | DentroChat | |
|---|---|---|---|
| Salattu siirron aikana (TLS) | Kyllä | Kyllä | Kyllä |
| Salattu levyllä | Kyllä (OpenAI hallitsee avaimia) | Kyllä (Zero-access, sinä hallitset avaimia) | Kyllä (DentroChat hallitsee avaimia) |
| End-to-end-salattu AI-päättelyn aikana | Ei (selkokielinen palvelimella) | Ei (selkokielinen palvelimella, U2L) | Ei (selkokielinen palvelimella) |
| Kouluttaa AI-malleja keskusteluillasi | Kyllä oletuksena (voi poistaa käytöstä) | Ei koskaan | Ei koskaan |
| Alainen US CLOUD Actille | Kyllä | Ei keskusteluille (USA laskutukselle ja tuelle) | Ei (100 % EU:n ja Sveitsin pino) |
Kaksi tapaa saada (lähes) todellinen end-to-end-salaus tekoälylle
Voiko pilvessä koskaan ajaa LLM:ää niin, ettei palvelimen ylläpitäjä näe kehotettasi selkokielisenä? On kaksi tapaa saada aikaan kunnollinen E2EE.
1. Homomorfinen salaus
Homomorfinen salaus on upea tutkimusala. Sen avulla voi suorittaa laskutoimituksia suoraan salatulla datalla.
Esimerkiksi: sinä salaat luvun 12, ja toinen käyttäjä salaa luvun 17. Molemmat salatut luvut lasketaan yhteen salatulla yhteenlaskulla. Tulos on salattu luku 29, ja vain sinä ja toinen käyttäjä voitte oikeasti purkaa sen ja todeta tuloksen olevan 29. Palvelin, joka laskun teki, ei koskaan tiennyt, että luvut olivat 12, 17 tai 29.
Tämä esimerkki on yksinkertainen, mutta se voi toimia myös LLM:ille. Silloin syötät salattua dataa LLM:ään, LLM tuottaa salatun vastauksen, ja vain käyttäjä voi purkaa vastauksen. Tällä alueella tehdään merkittävää akateemista tutkimusta, kuten tuoreessa artikkelissa salatusta LLM-päättelystä (Cachemir).
Homomorfisen salauksen ongelma on, että se on laskennallisesti erittäin raskasta ja siksi hyvin hidasta. Vaikka viimeaikaiset nopeutukset on tehty, puhutaan noin 100 sekunnista GPU-aikaa per generoitu token. Se tarkoittaisi, että joutuisit odottamaan 30 minuuttia yksinkertaiseen vastaukseen kysymykseen ”Mikä on Espanjan pääkaupunki?”
2. NVIDIA H100/H200 Confidential Computing -GPU:t (TEE)
Toinen tapa on käyttää NVIDIA H100/H200 Confidential Computing -GPU:ita luotetun suoritusympäristön (TEE) kanssa.
Se toimii näin: GPU:lla on oma yksityis-julkinen avainpari, joka on upotettu suoraan sen laitteistoon. Se luodaan kerran, kun GPU valmistetaan, eikä luotua yksityistä avainta voi kysyä ulkopuolelta, ei edes palvelinkaapin omistaja.
Tämä on hienoa, koska nyt voit salata tietosi GPU:n julkisella avaimella ja lähettää ne palvelimelle. GPU purkaa ne omassa laitteistoenklaavissaan yksityisellä avaimellaan, syöttää ne GPU:n sisällä toimivaan LLM:ään, salaa vastauksen uudelleen ja lähettää sen sinulle takaisin.
Näin saamme lähes todellisen E2EE:n. Ainoa jäljellä oleva laitteistohyökkäyspinta on valmistusvaiheessa: jos NSA tallensi kaikki yksityiset avaimet, kun nämä NVIDIA-GPU:t valmistettiin tehtaalla, se voisi teoriassa edelleen siepata ja purkaa liikenteen myöhemmin, kun GPU on otettu käyttöön. TEE:llä varustettu NVIDIA-GPU on kuitenkin erittäin vahva turvaoletus.
DentroChatille meillä oli kaksi vaihtoehtoa: ostaa tällaisia GPU:ita itse tai löytää eurooppalainen palveluntarjoaja, joka tarjoaa niitä. Ensimmäinen oli meille liian kallis: yksi H100 maksaa noin 40 000 euroa, ja jotta voisimme ajaa suuria avoimia painomalleja, kuten DentroChatissa käyttämämme, tarvitsisimme 8 kappaletta. Omarahoitteisena yrityksenä se ei silloin ollut mahdollista. Eurooppalaisen palveluntarjoajan löytäminen, joka käyttää confidential computing -GPU:ita, ei ollut mahdollista myöskään puoli vuotta sitten. Tämä on kuitenkin tulevaisuuden realistisin reitti, ja etsimme jatkuvasti eurooppalaisia tekoälyinfrastruktuurin tarjoajia, jotka tukevat sitä.
Miksi pidämme DentroChatia vahvana vaihtoehtona Lumon rinnalla
Vaikka tallennetulle historialle ei vielä ole zero-access-salausta, on useita syitä, miksi monet käyttäjät valitsevat DentroChatin Lumon sijaan:
- Paremmat AI-mallit: Kun viimeksi testasimme Lumoa, vastausten laatu oli melko vaatimatonta ja hidasta. DentroChatissa saat käyttöösi parhaat avoimen lähdekoodin mallit ja räätälöidyn agenttikehyksen taustalla.
- Nolla yhdysvaltalaista alihankkijaa koko pinossa: Sekä Lumo että DentroChat ajavat tekoälypäättelynsä eurooppalaisilla ja sveitsiläisillä palvelimilla. Lumo kuitenkin ohjaa edelleen laskutuksen ja asiakastuen yhdysvaltalaisten yritysten (kuten Stripen ja Zendeskin) kautta. DentroChatissa emme käytä yhdysvaltalaisia alihankkijoita missään. Voit tarkistaa koko pinomme alihankkijasivultamme.
Jos haluat verrata näitä kahta tarkemmin, katso täydellinen Lumo-vaihtoehtojen testimme, oppaamme yksityisestä AI-chatista tai miten eurooppalaiset ChatGPT-vaihtoehdot pärjäävät. Ja jos sinulla on joskus tämänkaltainen tekninen kysymys, älä epäröi ottaa meihin yhteyttä DentroChatin palautepainikkeen kautta!
Usein kysytyt kysymykset
Onko ChatGPT end-to-end-salattu?
Ei. OpenAI salaa keskustelusi siirron aikana (TLS) ja levyllä palvelimillaan, mikä on pilvisovellusten tavanomainen perustaso. Koska LLM tarvitsee selkokielisen tekstin vastauksen tuottamiseen, OpenAI:n palvelimet purkavat kehotteesi käsitelläkseen sen. Ellei sinulla ole yritystilausta tai et ole nimenomaisesti poistanut käytöstä, kuluttajakeskusteluja voidaan käyttää myös mallien koulutukseen.
Onko Proton Lumo end-to-end-salattu?
Ei end-to-end-salattu. Lumo käyttää sitä, mitä Proton kutsuu User-to-Lumo (U2L) -salaukseksi: tallennettu keskusteluhistoriasi lukitaan zero-access-salauksella, joten Proton ei voi lukea vanhoja keskustelujasi, ja kehotteesi salataan aina päättelypalvelimelle asti. Protonin GPU-palvelimen täytyy kuitenkin silti purkaa viestisi muistissa, jotta se voidaan syöttää LLM:ään.
Miten DentroChat salaa keskusteluni?
DentroChat salaa kaiken liikenteen siirron aikana TLS:llä, ja tallentaa keskustelusi ja tiedostosi itse hallitulla salauksella levyllä eurooppalaisilla palvelimilla Saksassa ja Ranskassa. Kuten Lumo ja ChatGPT, kehotteet on purettava palvelimen muistissa päättelyn aikana, jotta tekoälymalli voi vastata niihin, emmekä koskaan kouluta mallia tiedoillasi.
Voiko AI-chat koskaan olla todella end-to-end-salattu?
Kyllä, joko ajamalla pientä mallia paikallisesti omalla tietokoneellasi tai pilvessä homomorfisella salauksella tai NVIDIA Confidential Computing -GPU:illa (TEE:t). Tänään homomorfinen salaus on vielä aivan liian hidasta interaktiiviseen chattiin, kun taas confidential computing -GPU:t ovat lupaavin tulevaisuuden reitti, kunhan eurooppalaiset hostauspalvelut tekevät niistä laajasti saatavilla.