Hvor meget energi bruger en AI-prompt?
Brugere af DentroChat, vores EU AI-assistent, spørger os sommetider, hvor meget strøm der går til deres beskeder. Det er et fair spørgsmål. Vi ville gerne vise et tal i produktet, men dem der kører modellerne i skyen oplyser energien per request for det meste stadig ikke. Så vi har gjort vores bedste for at anslå det ud fra offentlig forskning.
Det her er ikke labmålinger af DentroChat. Vi har læst de studier, vi kunne finde, holdt dem op mod hinanden, og tallene herunder er hvor de lander. Kend du en bedre kilde, så skriv til os.
Strøm til en normal prompt
Typisk stiller du et spørgsmål og får et svar på et par hundrede tokens. Et token er en del af et ord, eller ved korte ord nogle gange et helt ord.
Google har målt det. I maj 2025 var den mediane tekstprompt i Gemini-apps 0,24 wattime. Det inkluderede chip og køling for hele hallen i deres datacenter. For den mediane prompt regnede Google med 0,03 gram CO2 (for Googles strøm).
Epoch AI estimerede i februar 2025 et typisk ChatGPT-svar til omkring 0,3 wattime, ud fra cirka 500 tokens svar. De siger selv, at estimatet ligger lidt højt.
I april 2026 kom et paper i Joule med data fra 2025-deployments. De estimerede medianen for en stor model til 0,31 wattime. Sam Altman skrev i juni 2025, at en gennemsnitlig ChatGPT-forespørgsel er omkring 0,34 wattime.
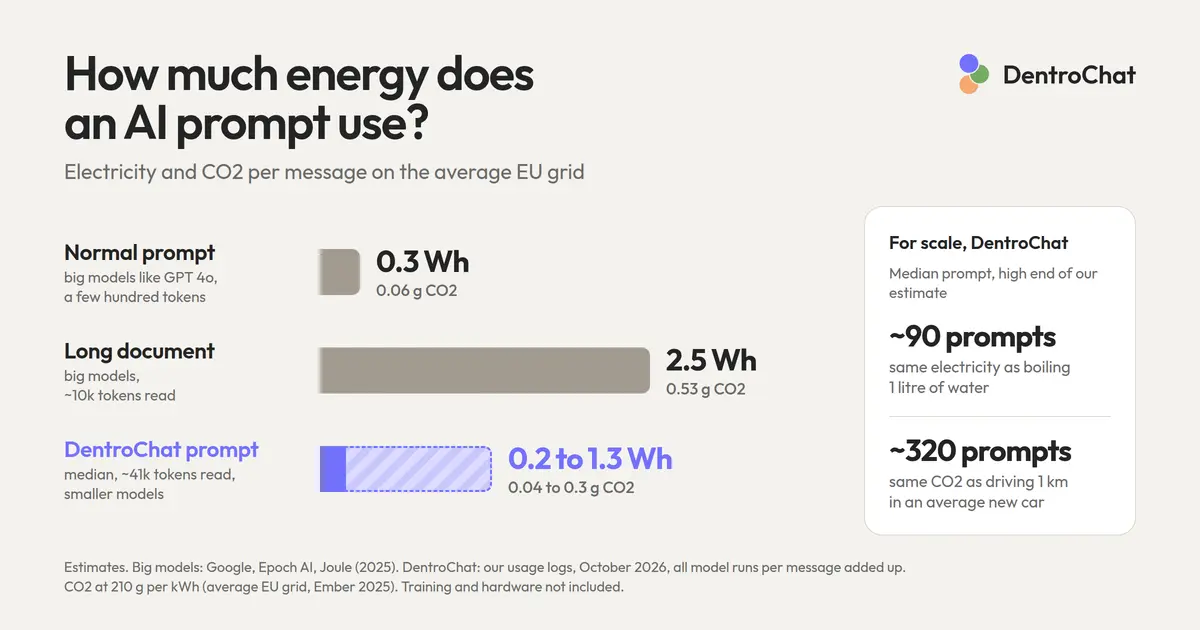
For en typisk prompt ville vi sige 0,3 wattime. Måling og estimater ender omtrent det samme sted.
Strøm til en længere prompt
Et langt dokument er mere arbejde, fordi der skal læses meget.
Epoch AI estimerede, at omkring 10k tokens input giver omkring 2,5 wattime for sådan en forespørgsel. For at vise, hvad det er i ord, har vi talt tokens på vores egne sider. Tallene her bruger GPT-4o-tokenizeren: omkring 7.700 engelske ord og omkring 5.800 tyske ord, altså en lang artikel eller en chat med mange beskeder. Længere nede har vi kørt de samme sider gennem fem andre tokenizers, og den tabel viser, hvor langt de er fra GPT-4o.
Jegham et al. lavede deres eget estimat for sådan en prompt med 10k ind og 1.500 ud. Det blev mellem omkring 1,4 og 2,9 wattime afhængigt af modellen, altså samme størrelsesorden som Epoch.
Tænker modellen længe og skriver tusindvis af tokens, før svaret kommer, bruges der mere strøm. I Joule-paperet ligger et svar på omkring 5k tokens omkring 4 wattime. Det er et reasoning-svar, hvor modellen regner meget.
Her er det hele i én tabel. Det er store modeller som GPT-4o og Gemini:
| Type prompt | Tokens, groft | Strøm | Kilde |
|---|---|---|---|
| Normal prompt | kort spørgsmål, et par hundrede tokens tilbage | ~0,3 Wh | Google, Epoch AI, Joule-paper, Altman |
| Langt dokument | ~10k ind, 500 til 1.500 ud | ~2,5 Wh (1,4 til 2,9) | Epoch AI, Jegham et al. |
| Reasoning-svar | ~5k ud | ~4 Wh | Joule-paper |
Kort sagt: en normal prompt bruger omkring 0,3 wattime. Et langt dokument på omkring 10k tokens bruger omkring 2,5 wattime, et sted mellem 1,4 og 2,9 afhængigt af modellen. Et langt reasoning-svar på omkring 5k tokens bruger omkring 4 wattime.
CO2 afhænger af nettet
Strømmen til samme model er omtrent den samme, uanset hvor serverne står. Men CO2 afhænger af det lokale elnet.
Vi tog tallene fra Ember, 2025, som du kan se hos Our World in Data. Det er livscyklustal. De inkluderer forsyningskæden oven på kraftværkets udledning, målt i gram CO2-ækvivalent per kilowattime.
Med dem gangede vi vores to tal: 0,3 Wh for en normal prompt og 2,5 Wh for et langt dokument:
| Net | g CO2e per kWh | Normal prompt | Langt dokument |
|---|---|---|---|
| Norge | 28 | 0,01 g | 0,07 g |
| Sverige | 35 | 0,01 g | 0,09 g |
| Frankrig | 41 | 0,01 g | 0,10 g |
| Finland | 57 | 0,02 g | 0,14 g |
| Danmark | 114 | 0,03 g | 0,29 g |
| Østrig | 117 | 0,04 g | 0,29 g |
| Spanien | 154 | 0,05 g | 0,38 g |
| EU-gennemsnit | 210 | 0,06 g | 0,53 g |
| Nederlandene | 254 | 0,08 g | 0,63 g |
| Italien | 285 | 0,09 g | 0,71 g |
| Estland | 319 | 0,10 g | 0,80 g |
| Tyskland | 330 | 0,10 g | 0,82 g |
| USA | 384 | 0,12 g | 0,96 g |
| Polen | 589 | 0,18 g | 1,47 g |
Kort sagt: i Sverige (35 g per kWh) og Frankrig (41 g) koster en normal prompt omkring 0,01 gram CO2 og et langt dokument omkring 0,1 gram. På EU-gennemsnittet (210 g) er en normal prompt omkring 0,06 gram og et langt dokument omkring 0,5 gram. I Tyskland (330 g) omkring 0,1 gram og 0,8 gram. Polen har med 589 g den højeste værdi i tabellen, omkring 0,18 gram for en normal prompt og omkring 1,5 gram for et langt dokument. USA er med, fordi mange ChatGPT-tal kommer derfra; ved 384 g er det omkring 0,12 gram for en normal prompt og omkring 1 gram for et langt dokument.
I Tyskland siger miljøagenturet noget lignende for 2025: 344 g CO2 per kilowattime fra produktion og 406 g CO2-ækvivalent med forsyningskæde. Electricity Maps sætter det faktiske elforbrug i Tyskland i 2025 til 335 g, hvor enkelte timer kan svinge mellem omkring 100 g og 600 g.
Hvad med DentroChat?
Alle tal indtil nu gælder store modeller som GPT-4o. Epoch antog, at omkring 100 milliarder parametre arbejder på hvert token, men DentroChat bruger ofte mindre modeller. Det er mixture-of-experts-modeller: modellen er stor, men kun en lille del arbejder per token. DeepSeek V4 Flash bruger omkring 13 milliarder parametre per token, GLM 5.3 Flash omkring 18 milliarder og Qwen 3.8 Flash Next omkring 6 milliarder.
Færre aktive parametre betyder mindre strøm per token og dermed mindre CO2 per token. ML.ENERGY-leaderboardet har målt det på rigtige GPU’er. En Qwen-model med 22 milliarder aktive parametre brugte omkring 0,12 Wh per 1.000 skrevne tokens. DeepSeek V3.1 med 37 milliarder omkring 0,37 Wh. Det er kun grafikkortene, så vi lagde køling og resten af serverne oveni. Vores modeller er mindre end begge, så her er vores estimat:
| Per 1.000 tokens | Aktive parametre per token | Skrevet | Læst, frisk | Læst, cachet | CO2 per 1.000 skrevet, EU-gennemsnit |
|---|---|---|---|---|---|
| GPT-4o (Epochs antagelse) | ~100 mia. | ~0,6 Wh | ~0,2 Wh | ~0,13 g | |
| DentroChat-modeller (vores estimat) | 6 til 18 mia. | 0,05 til 0,4 Wh | 0,01 til 0,07 Wh | 0,001 til 0,007 Wh | 0,01 til 0,08 g |
Kort sagt: for GPT-4o giver Epochs tal omkring 0,6 wattime per 1.000 tokens modellen skriver, og omkring 0,2 per 1.000 tokens den læser. For modellerne i DentroChat estimerer vi 0,05 til 0,4 wattime per 1.000 skrevne tokens og 0,01 til 0,07 per 1.000 læste tokens. Er teksten læst for et par minutter siden, ligger den i cache, og så koster det omkring en tiendedel igen. På EU-gennemsnitsnettet er 1.000 skrevne tokens omkring 0,13 gram CO2 for GPT-4o og 0,01 til 0,08 gram for vores modeller.
Vores prompts er større end den «normale prompt» i studierne. Hver besked sender også modellens instruktioner og tool-beskrivelser med, allerede omkring 3k tokens. Oveni kommer dit memory, chatten indtil nu, og eventuelle filer eller websøgeresultater. Bruger modellen et tool, læser den det hele igen. Den kan først beslutte at søge på nettet og derefter læse hele chatten plus søgeresultater for at skrive svaret. Én besked fra dig kan betyde flere modelkørsler.
Alle tal i tabellen herunder er per besked, du sender. Har én besked fået modellen til at køre flere gange, har vi lagt kørslerne sammen i én række.
Vi kiggede i vores brugslogs og talte tokens (hvad du skriver læser vi selvfølgelig ikke). Tabellen bruger 606 prompts fra én dag i oktober 2026. Vi tjekkede også de 21.700 prompts fra de 30 dage før, og medianen var meget lignende:
| DentroChat-prompt | Læst | heraf cachet | Skrevet | Strøm (vores estimat) | CO2, EU-gennemsnit | CO2, Tyskland |
|---|---|---|---|---|---|---|
| Median | ~41k | ~30k | ~900 | 0,2 til 1,3 Wh | 0,04 til 0,3 g | 0,06 til 0,4 g |
| Øverste 10 % | ~131k | ~66k | ~4.600 | 1 til 7 Wh | 0,2 til 1,4 g | 0,3 til 2,3 g |
Kort sagt: median-DentroChat-prompten læser omkring 41k tokens, hvoraf omkring 30k er cachet, fordi de blev sendt et par minutter før. Den skriver omkring 900 tokens. Vi estimerer det til 0,2 til 1,3 wattime, omkring 0,04 til 0,3 gram CO2 på EU-gennemsnitsnettet og 0,06 til 0,4 gram i Tyskland. De øverste 10 % læser 131k tokens eller mere og skriver 4.600 eller mere. Det er omkring 1 til 7 wattime, eller 0,2 til 1,4 gram CO2 på EU-gennemsnittet og 0,3 til 2,3 gram i Tyskland.
For rækken «Øverste 10 %» tog vi percentilværdien per kolonne for sig. En rigtig prompt rammer sjældent alle kolonner på én gang, så rækken er med vilje på den tunge side.
Der er også arbejde i baggrunden, som at opdatere dit memory og opsummere lange chats. Nogle gange er en model for langsom, og vi skifter midt i et svar til en backup-model. De kørsler er ikke i tabellen. Fordeler du dem over alle prompts, læser gennemsnitsprompten omkring 76k tokens (50k cachet) og skriver omkring 2k. Det lander omkring 0,4 til 3 wattime.
En DentroChat-prompt læser altså meget mere end den normale prompt i studierne. Per token er den billigere. Medianen (0,2 til 1,3 Wh) ligger nederst tæt på 0,3 Wh for store modeller og øverst omkring halvdelen af deres lange dokument på 2,5 Wh.
Til sammenligning: kedel og kort køretur
Det tager groft 100 wattime varme at varme en liter vand fra hanen til kog. Noget når ikke vandet, så i stikkontakten er det mere som 110 til 125 wattime.
En median DentroChat-prompt er en lille del af det. Vi bruger den høje ende af vores estimat, 1,3 wattime, så sammenligningen bliver på den tunge side. Så skal du bruge omkring 90 DentroChat-prompts for at matche en liter.
Til bilen tager vi gennemsnittet for nye biler i 2025 fra Det Europæiske Miljøagentur: 96,7 g CO2 per kilometer ifølge labtest. Gennemsnittet inkluderer elbiler, som tæller som nul udstødning, så en benzinbil på vejen forbruger nok lidt mere.
Per kilometer i sådan en gennemsnitlig ny bil kunne du sende omkring 240 median DentroChat-prompts i Tyskland. Igen den tunge side: 0,4 gram CO2 per prompt. På EU-gennemsnitsnettet er samme prompt 0,3 gram, så omkring 320 prompts per kilometer.
Sprog påvirker antallet af tokens
Forskellige sprog tokeniserer samme side i forskelligt mange tokens. Vi kørte vores artikler gennem tokenizers for alle 17 sprog, DentroChat understøtter.
Vi brugte 22 blogindlæg, der findes på hvert sprog, så det er samme tekst hver gang. Hovedtallet kommer fra GPT-4o-tokenizeren. Spændet er laveste og højeste på tværs af seks tokenizers (GPT-4o, GPT-4, Mistral, Llama 3, Qwen 2.5 og DeepSeek V3).
| Sprog | Tokens per ord | Spænd | Ord i 10k tokens |
|---|---|---|---|
| Engelsk | 1,3 | 1,3 til 1,4 | ~7.700 |
| Spansk | 1,4 | 1,4 til 1,7 | ~7.200 |
| Portugisisk | 1,4 | 1,4 til 1,7 | ~7.000 |
| Fransk | 1,4 | 1,4 til 1,7 | ~6.900 |
| Hollandsk | 1,6 | 1,6 til 2,1 | ~6.300 |
| Italiensk | 1,7 | 1,7 til 1,9 | ~6.000 |
| Tysk | 1,7 | 1,7 til 2,1 | ~5.800 |
| Norsk | 1,9 | 1,9 til 2,2 | ~5.400 |
| Svensk | 1,9 | 1,9 til 2,3 | ~5.300 |
| Dansk | 1,9 | 1,9 til 2,3 | ~5.300 |
| Rumænsk | 1,9 | 1,9 til 2,2 | ~5.300 |
| Kroatisk | 2,1 | 2,1 til 2,6 | ~4.800 |
| Polsk | 2,2 | 2,2 til 2,6 | ~4.500 |
| Græsk | 2,4 | 2,4 til 5,9 | ~4.200 |
| Estisk | 2,5 | 2,5 til 3,1 | ~4.000 |
| Ungarsk | 2,6 | 2,5 til 3,1 | ~3.900 |
| Finsk | 2,8 | 2,8 til 3,5 | ~3.600 |
Kort sagt: på GPT-4o-tokenizeren er engelsk omkring 1,3 tokens per ord, så 10k tokens er omkring 7.700 engelske ord. Spansk, portugisisk og fransk ligger lige bag med omkring 1,4. Hollandsk omkring 1,6, tysk og italiensk omkring 1,7, så 10k tokens er omkring 5.800 tyske ord. De nordiske sprog undtagen finsk ligger omkring 1,9. Estisk omkring 2,5 og finsk højest med omkring 2,8, så 10k tokens er kun omkring 3.600 finske ord.
Ofte hører man, at et tysk ord er tre tokens. På moderne tokenizers måler vi snarere to. Græsk har det store spænd, fordi ældre tokenizers håndterer det græske alfabet dårligt.
Et finsk dokument af samme længde bruger altså flere tokens og dermed mere strøm. Gram CO2 per Wh følger nettet ovenfor.
Det har vi ikke medtaget
Det her handler om strømmen til ét svar på én besked.
Modeltræning skete tidligere på én gang og deles mellem alle, der bruger modellen. At fordele træningsomkostningen på din prompt ville være gætteri, så den er ude.
Så er der omkostningen ved at fremstille grafikkort. Nvidias opgørelse for ét H100-board: 1312 kg CO2-ækvivalent for 8 GPU’er over et par års drift. For én prompt bærer du kun en lille brøkdel, klart under 1 g. På et rent net som Sverige kan den brøkdel nærme sig CO2 fra selve strømmen. På det tyske net er strømmen meget større.
Og vand. Det virale claim om, at AI drikker en vandflaske, kommer fra et 2023-estimat for GPT-3: omkring 500 ml til 20 til 50 svar, i varme amerikanske datacentre der køler ved fordampning. Google målte 0,26 ml for en median Gemini-tekstprompt (omkring fem dråber). Mange europæiske datacentre køler med udeluft og bruger næsten intet vand, inklusive Hetzner i Tyskland hvor DentroChat hostes, og de svenske datacentre hvor en del af vores modeller kører. Mere i Spilder AI vand? og mere detaljeret i AI’s vandforbrug: hvorfor virale tal er misvisende.
Der er også det praktiske: bliver du i samme chat, ligger det lange dokument som regel et par minutter i hukommelsen, så næste besked mest behandler den nye tekst. OpenAI og Anthropic beskriver caches der udløber efter omkring 5 til 10 minutter uden aktivitet. Det er kolonnen «cachet» i vores DentroChat-tabel. Det hjælper også, når modellen kører flere gange for én besked, fordi anden kørsel kan genbruge det, den første allerede læste.
Vi ville gerne vise dig et rigtigt wattimetal for hver besked i DentroChat, den bedste EU AI-chat. Til det skulle dem der kører modellerne oplyse energien per request, og det gør de fleste ikke endnu.
Indtil da er det her vores bedste estimat. På store modeller som GPT-4o bruger en normal prompt omkring 0,3 wattime og et langt dokument omkring 2,5. En median DentroChat-prompt på vores mindre modeller bruger omkring 0,2 til 1,3 wattime. På EU-gennemsnitsnettet er det højst omkring 0,3 gram CO2.