AI utan träning på kunddata: säker AI för företag
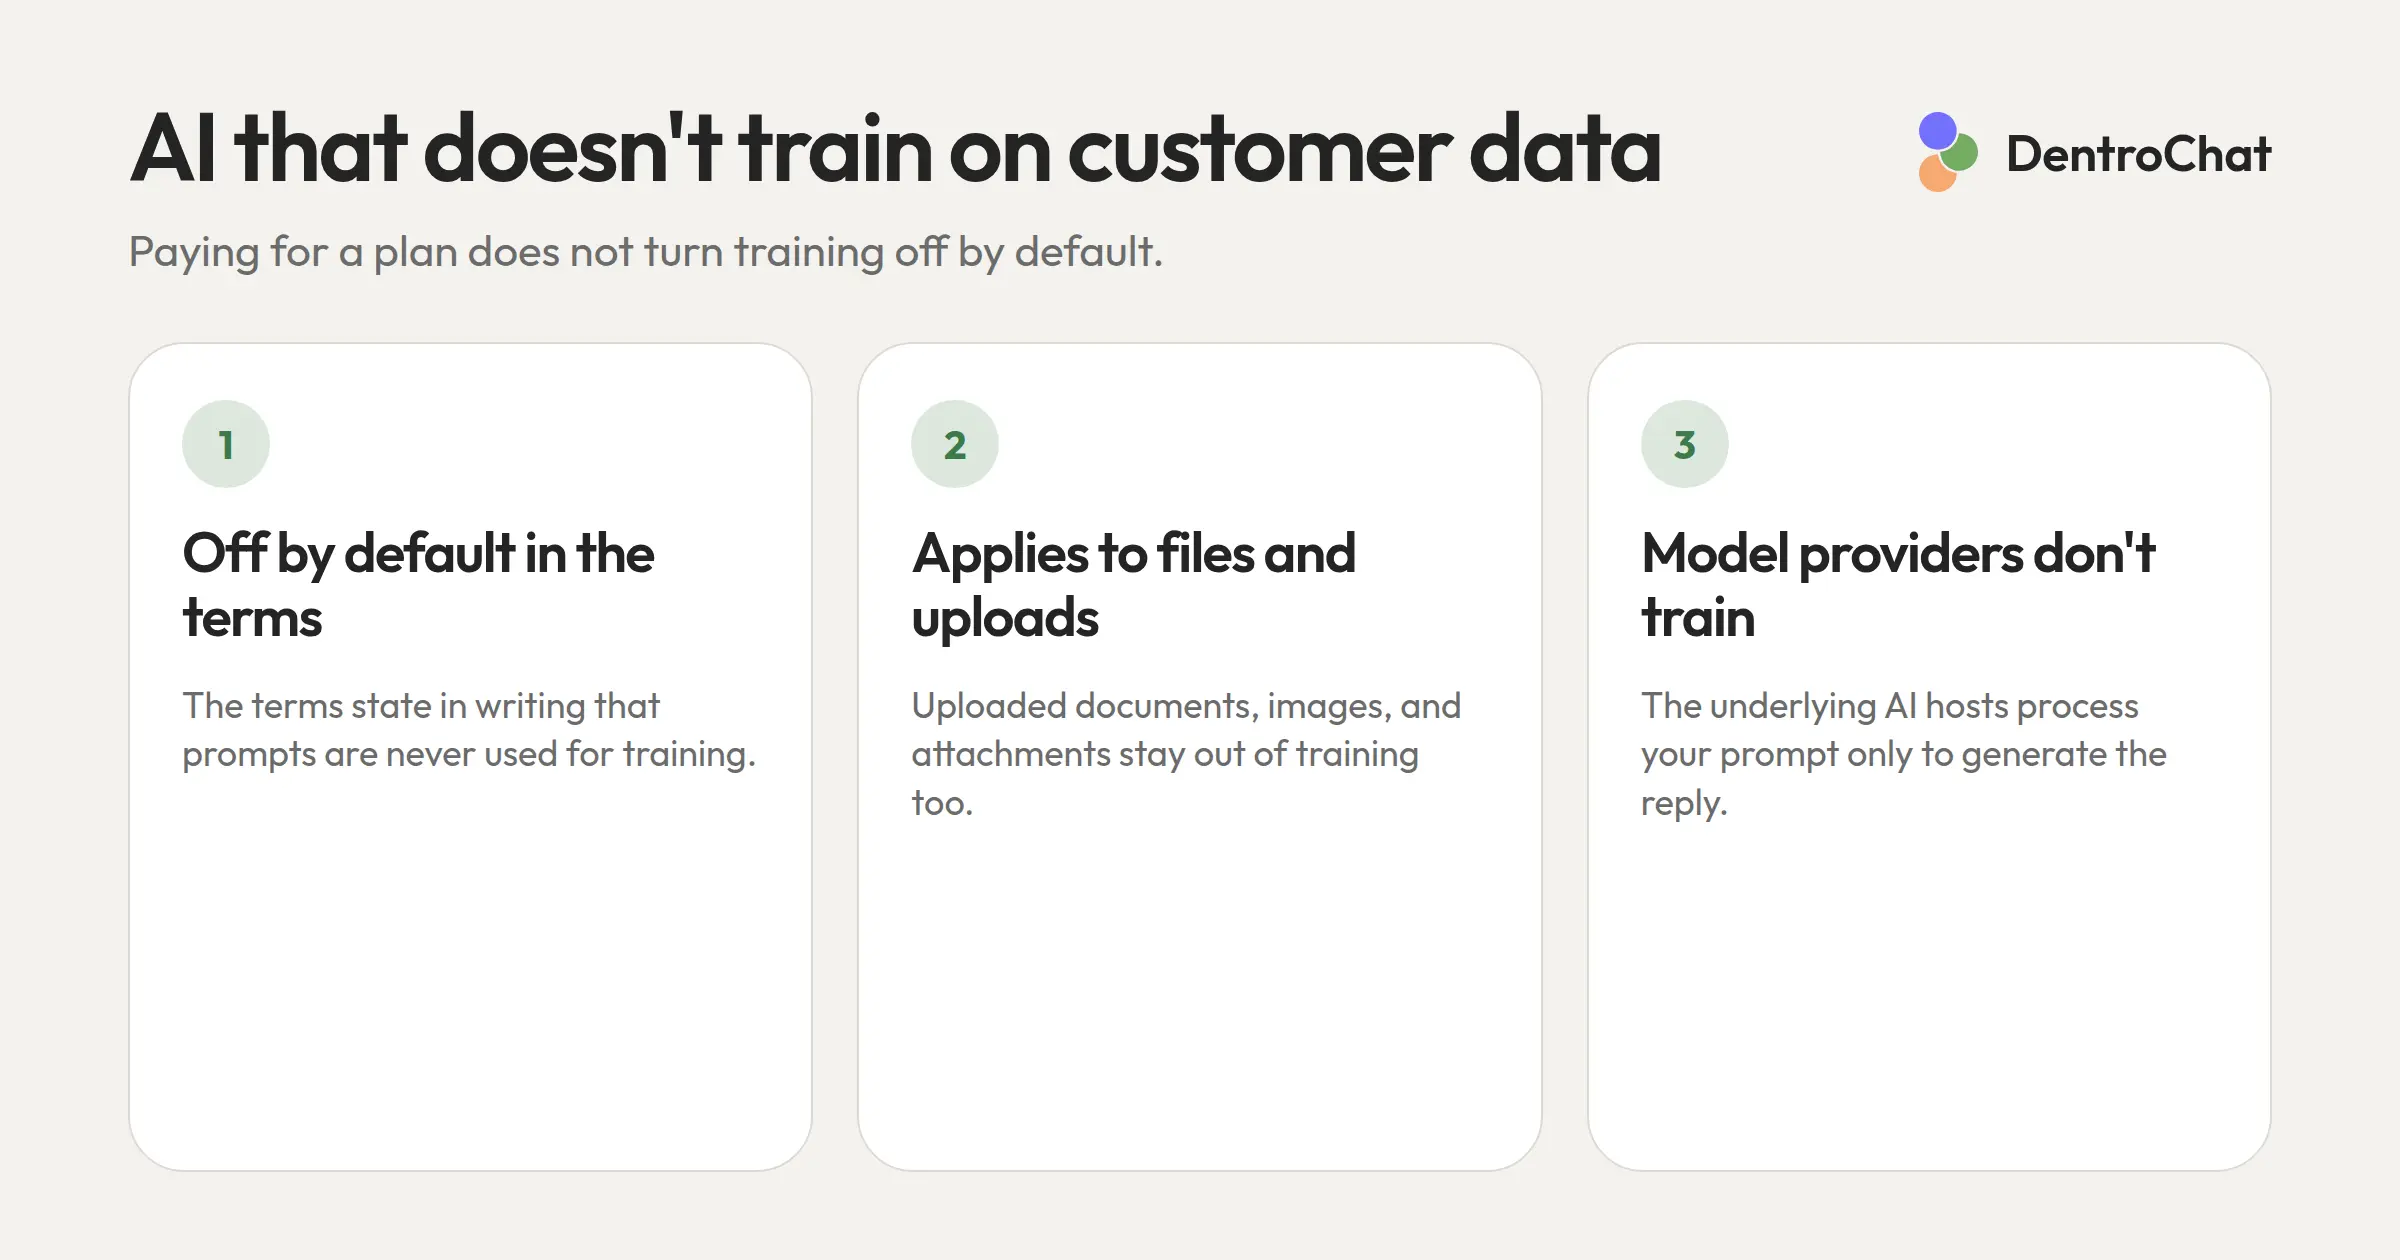
I Norden är det för många företag avgörande att använda AI utan träning på kunddata.
Om du dagligen hanterar avtalstext, kundmeddelanden eller interna strategidokument ska du inte mata in den informationen i ett system som använder den för att träna framtida AI-versioner.
GDPR erbjuder många skydd. Ändå stämmer den tekniska verkligheten hos många populära AI-lösningar ofta inte med marknadsföringen.
Den här guiden hjälper dig förstå vad du ska kräva av säkra AI-verktyg. Vilka varningssignaler i användarvillkoren. Vilka konkreta steg som gör ditt AI-användande säkrare direkt.
Varför AI utan träning på kunddata spelar roll
I vardagen med AI-verktyg skriver du förmodligen in mer än lite text. Kundnamn. Avtalsdetaljer. Supportfrågor. Interna anteckningar. Frågan är inte om dina data skrivs in någonstans, utan var, och vad som händer sedan.
Vad som händer med dina data i ChatGPT och liknande
Många leverantörer formulerar villkoren så att dina inmatningar får användas för att träna modeller. Din prompt om kunddata kan hamna i träningsdata för en framtida version.
Modellen lär sig inte direkt, men nästa release kan ge ut data du en gång matade in. Om någon i Mexiko plötsligt får kunduppgifterna om Hans Kreutzer är det kört.
Gratis vs betalt? Inte huvudpoängen
Många tror felaktigt att en betald prenumeration automatiskt ger bättre integritet.
Fel.
Även med ChatGPT Plus kan träningsalternativ vara på tills du stänger av dem själv. För AI utan träning på kunddata måste du gräva djupare än prisnivån. Integritetsinställningar och leverantörens faktiska löften räknas.
Privat vs enterprise: den verkliga gränsen
Den viktiga skiljelinjen är inte gratis mot betalt utan privatkonto mot enterprise. Personliga konton, inklusive Plus eller Pro, lovar ofta lite integritet som standard. Enterprise-erbjudanden som ChatGPT Enterprise eller Microsoft Copilot for Business säger oftare uttryckligen att inmatningar inte används för modellträning. Det här ska du kontrollera:
-
Tydliga villkor: prompts används inte för träning som standard
-
Samma skydd för uppladdade filer, PDF:er och bilagor
-
Modellleverantörerna i stacken (underleverantörer) tränar inte heller på dina inmatningar
-
Inga dolda opt-out-knappar eller undantag via feedback
Plattformar som dentro.chat är byggda för just det här: affärsbruk där kunddata inte går in i modellträningen.
Juridiska risker när AI hanterar kunddata
GDPR och AI-användning
Så fort du matar personuppgifter in i en AI-tjänst gäller GDPR fullt ut, utan undantag eller respit. Varje prompt med kundnamn, e-post eller avtalsdetalj räknas. Den som använder verktyget behandlar data enligt GDPR och måste följa ändamålsbegränsning och dataminimering: inmatningen får bara användas för att beräkna svaret, inte för senare modellträning. Det spelar också roll vilka tredje parter ser dina data och vilket rättssystem som gäller. Många team förstår först vad GDPR-efterlevnad betyder för AI på jobbet efter att något redan gått fel. Böterna kan bli höga.
US CLOUD Act: varför serverplats inte räcker
Många företag litar på att AI-leverantören använder servrar inom EU. Serverplatsen täcker bara en del av frågan.
En amerikansk chatt kan fortfarande fungera om den inte tränar på din data. För dataskyddet i stort är det bättre att undvika amerikanska underbiträden.
Amerikanska bolag omfattas av US CLOUD Act, som kan tvinga dem att lämna ut data till amerikanska myndigheter, oavsett var data lagras fysiskt. En nod i Frankfurt tar inte bort den exponeringen.
Amerikanska myndigheter kan också tvinga tystnad om utlämnandet. Det hände 1 823 gånger hos Microsoft bara under första halvåret 2025.
Så känner du igen säkra AI-verktyg
Vad du ska fråga varje leverantör
Innan du rullar ut ett AI-verktyg i företaget, ställ konkreta frågor:
-
Är modellträning uteslutet som standard för chattar och uppladdade filer?
-
Gäller träningsförbudet också modellleverantörerna (underleverantörer)?
-
Hur länge sparas prompts för missbruksgranskning, och vem har åtkomst?
-
Var står servrarna fysiskt och vilket lag styr operatören?
En leverantör som svarar skriftligt med detaljer visar att integritet är inbyggd i produkten.
Även utan träning: lagring för missbruksgranskning
Även när träning är av ställer många stora leverantörer inte in raderingen direkt efter svaret. Många tjänster sparar prompts i 30 dagar eller längre för missbruk och säkerhet, ibland med mänskliga granskare. Matar du in konfidentiella kunddata, kolla hur länge inmatningar loggas, om gamla chattar kan raderas automatiskt och vem som får åtkomst vid support.
Varningssignaler i villkoren
Vissa formuleringar ska få dig att stanna direkt. «För att förbättra våra modeller» eller «för att förbättra vår AI» om dina inmatningar och chattinnehåll betyder att prompts kan hamna i framtida träningsdata. Obs: liknande meningar kan bara gälla anonym statistik, inte chattinnehåll. Sammanhanget avgör, se vad «förbättring» syftar på. Vaga integritetspolicyer utan lagringsplats eller retention, eller utan opt-out från träning, är dåliga tecken.
Positiva signaler är lika viktiga. En seriös policy säger tydligt att inmatningar inte används för att träna AI-modeller. Den anger var data lagras och listar varje underleverantör med plats. DentroChats integritetspolicy gör det: inget träning på chattar, underleverantörer inom EU, inga US-baserade underleverantörer.
Hittar du inte sådana tydliga löften är det redan ett svar. Vill du inte läsa en främmande policy rad för rad hjälper vår Privacy Policy Analyzer dig hitta träningsklausuler och tredjelandsoverföringar snabbt.
Använda AI säkrare: praktiska strategier
Även utan det perfekta verktyget kan du göra AI-användandet säkrare direkt. Två åtgärder ger störst effekt.
Anonymisera innan du skriver
Byt ut riktiga namn, företag och kontaktuppgifter mot platshållare («Kund A», «Företag X»). Det känns klumpigt men tar sekunder och sänker risken kraftigt, särskilt utan ett verktyg som uttryckligen lovar att inte använda inmatningar för träning. För utkast eller sammanfattningar räcker anonymisering ofta.
Interna regler för teamet
Individuell försiktighet hjälper lite om kollegor klistrar in kunddata i vilket AI-verktyg som helst. Skriv ner vilka datatyper som får in i vilka verktyg och vilka som är tabu. Europeiska tillsynsmyndigheter förväntar sig tekniska och organisatoriska åtgärder (TOM) i varje AI-utrullning. Korta teamutbildningar skapar medvetenhet utan att bromsa arbetet.
DentroChat: AI utan träning på kunddata
Vill du tillämpa allt ovan konsekvent behöver du en plattform med integritet från start. DentroChat är ett europeiskt AI-alternativ för integritetsmedvetna användare.
Hur DentroChat hanterar integritet
DentroChat körs helt på europeisk infrastruktur och behandlar data endast inom EU och Schweiz. Inga US-underleverantörer, så dina inmatningar exponeras inte för US CLOUD Act. Det är en strukturell skillnad mot många populära alternativ. Dessutom är AI utan träning på kunddata en fast del av erbjudandet.
Vem har mest nytta av det
Särskilt nordiska och europeiska företag som ofta hanterar känsliga kund- eller avtalsdata. Advokater, byråer, konsultbolag. Team under GDPR. Vill du ha något compliant som fungerar i vardagen utan tekniska trick är DentroChat ett solidt val.
AI utan modellträning på kunddata är inte nice-to-have. Det är en baslinje varje affärsbruk av AI ska uppfylla när riktiga kunddata är inblandade. GDPR, CLOUD Act och ökad kundkänslighet: sätt riktningen nu i stället för dyra fixar senare.
Nästa steg kan gå snabbt. Läs villkoren för dina nuvarande AI-verktyg. Ställ frågorna i den här artikeln. Om svaren är vaga eller saknas vet du vad det betyder.