Hur mycket energi använder en AI-prompt?
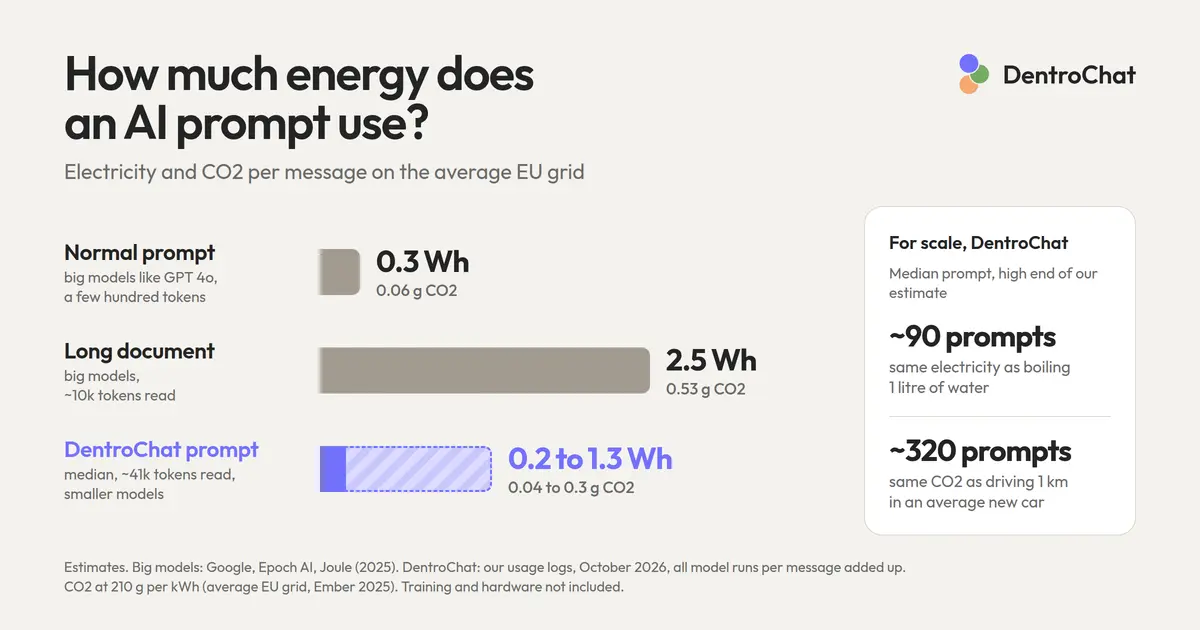
Användare av DentroChat, vår EU AI-assistent, frågar oss ibland hur mycket ström som går åt till deras meddelanden. Det är en rimlig fråga. Vi skulle gärna visa en siffra i produkten, men de som kör modellerna i molnet anger energin per request oftast fortfarande inte. Därför har vi gjort vårt bästa för att uppskatta den utifrån offentlig forskning.
Det här är inte labbmätningar av DentroChat. Vi har läst studierna vi hittade, ställt dem mot varandra, och siffrorna nedan är där de landar. Känner du till en bättre källa, hör av dig.
El för en normal prompt
Typiskt ställer du en fråga och får ett svar på några hundra tokens. En token är en del av ett ord, eller vid korta ord ibland ett helt ord.
Google har mätt det. I maj 2025 var median textprompt i Gemini-apparna 0,24 wattimmar. Det inkluderade chip och kylning för hela hallen i deras datacenter. För median prompt räknade Google med 0,03 gram CO2 (för Googles el).
Epoch AI uppskattade i februari 2025 ett typiskt ChatGPT-svar till ungefär 0,3 wattimmar, utifrån runt 500 tokens svar. De säger själva att uppskattningen ligger lite högt.
I april 2026 kom en artikel i Joule med data från 2025-deployments. De uppskattade medianen för en stor modell till 0,31 wattimmar. Sam Altman skrev i juni 2025 att en genomsnittlig ChatGPT-fråga är ungefär 0,34 wattimmar.
För en typisk prompt skulle vi säga 0,3 wattimmar. Mätning och uppskattningar hamnar ungefär på samma ställe.
El för en längre prompt
Ett långt dokument är mer jobb, eftersom mycket måste läsas.
Epoch AI uppskattade att ungefär 10k tokens input ger ungefär 2,5 wattimmar för en sådan fråga. För att visa vad det är i ord har vi räknat tokens på våra egna sidor. Siffrorna här använder GPT-4o-tokenizer: ungefär 7 700 engelska ord och ungefär 5 800 tyska ord, alltså en lång artikel eller en chatt med många meddelanden. Längre ner har vi kört samma sidor genom fem andra tokenizers, och den tabellen visar hur långt de ligger från GPT-4o.
Jegham et al. gjorde sin egen uppskattning för en sådan prompt med 10k in och 1 500 ut. Det blev mellan ungefär 1,4 och 2,9 wattimmar beroende på modellen, alltså samma storleksordning som Epoch.
Tänker modellen länge och skriver tusentals tokens innan svaret kommer, går det mer el åt. I Joule-artikeln ligger ett svar på ungefär 5k tokens runt 4 wattimmar. Det är ett reasoning-svar där modellen räknar mycket.
Här är allt i en tabell. Det gäller stora modeller som GPT-4o och Gemini:
| Typ av prompt | Tokens, grovt | El | Källa |
|---|---|---|---|
| Normal prompt | kort fråga, några hundra tokens tillbaka | ~0,3 Wh | Google, Epoch AI, Joule-artikel, Altman |
| Långt dokument | ~10k in, 500 till 1 500 ut | ~2,5 Wh (1,4 till 2,9) | Epoch AI, Jegham et al. |
| Reasoning-svar | ~5k ut | ~4 Wh | Joule-artikel |
Kort sagt: en normal prompt använder ungefär 0,3 wattimmar. Ett långt dokument på ungefär 10k tokens använder ungefär 2,5 wattimmar, någonstans mellan 1,4 och 2,9 beroende på modellen. Ett långt reasoning-svar på ungefär 5k tokens använder ungefär 4 wattimmar.
CO2 beror på elnätet
Elen till samma modell är ungefär densamma oavsett var servrarna står. Men CO2 beror på det lokala elnätet.
Vi tog siffrorna från Ember, 2025, som du ser hos Our World in Data. Det är livscykelsiffror. De räknar in försörjningskedjan ovanpå kraftverkets utsläpp, mätt i gram CO2-ekvivalent per kilowattimme.
Med dem multiplicerade vi våra två tal: 0,3 Wh för en normal prompt och 2,5 Wh för ett långt dokument:
| Elnät | g CO2e per kWh | Normal prompt | Långt dokument |
|---|---|---|---|
| Norge | 28 | 0,01 g | 0,07 g |
| Sverige | 35 | 0,01 g | 0,09 g |
| Frankrike | 41 | 0,01 g | 0,10 g |
| Finland | 57 | 0,02 g | 0,14 g |
| Danmark | 114 | 0,03 g | 0,29 g |
| Österrike | 117 | 0,04 g | 0,29 g |
| Spanien | 154 | 0,05 g | 0,38 g |
| EU-genomsnitt | 210 | 0,06 g | 0,53 g |
| Nederländerna | 254 | 0,08 g | 0,63 g |
| Italien | 285 | 0,09 g | 0,71 g |
| Estland | 319 | 0,10 g | 0,80 g |
| Tyskland | 330 | 0,10 g | 0,82 g |
| USA | 384 | 0,12 g | 0,96 g |
| Polen | 589 | 0,18 g | 1,47 g |
Kort sagt: i Sverige (35 g per kWh) och Frankrike (41 g) kostar en normal prompt ungefär 0,01 gram CO2 och ett långt dokument ungefär 0,1 gram. På EU-genomsnittet (210 g) är en normal prompt ungefär 0,06 gram och ett långt dokument ungefär 0,5 gram. I Tyskland (330 g) ungefär 0,1 gram respektive 0,8 gram. Polen har med 589 g högst värde i tabellen, ungefär 0,18 gram för en normal prompt och ungefär 1,5 gram för ett långt dokument. USA är med eftersom många ChatGPT-siffror kommer därifrån; vid 384 g är det ungefär 0,12 gram för en normal prompt och ungefär 1 gram för ett långt dokument.
I Tyskland säger miljöbyrån något liknande för 2025: 344 g CO2 per kilowattimme från produktion och 406 g CO2-ekvivalent med försörjningskedja. Electricity Maps sätter faktisk elförbrukning i Tyskland 2025 till 335 g, där enskilda timmar kan svänga mellan ungefär 100 g och 600 g.
Hur är det med DentroChat?
Alla siffror hittills gäller stora modeller som GPT-4o. Epoch antog att ungefär 100 miljarder parametrar jobbar på varje token, men DentroChat använder ofta mindre modeller. Det är mixture-of-experts-modeller: modellen är stor, men bara en liten del jobbar per token. DeepSeek V4 Flash använder ungefär 13 miljarder parametrar per token, GLM 5.3 Flash ungefär 18 miljarder och Qwen 3.8 Flash Next ungefär 6 miljarder.
Färre aktiva parametrar betyder mindre el per token och därmed mindre CO2 per token. ML.ENERGY-leaderboardet har mätt det på riktiga GPU:er. En Qwen-modell med 22 miljarder aktiva parametrar behövde ungefär 0,12 Wh per 1 000 skrivna tokens. DeepSeek V3.1 med 37 miljarder ungefär 0,37 Wh. Det är bara grafikkorten, så vi lade kylning och resten av servrarna ovanpå. Våra modeller är mindre än båda, så här är vår uppskattning:
| Per 1 000 tokens | Aktiva parametrar per token | Skrivet | Läst, färskt | Läst, cachet | CO2 per 1 000 skrivna, EU-genomsnitt |
|---|---|---|---|---|---|
| GPT-4o (Epochs antagande) | ~100 mrd | ~0,6 Wh | ~0,2 Wh | ~0,13 g | |
| DentroChat-modeller (vår uppskattning) | 6 till 18 mrd | 0,05 till 0,4 Wh | 0,01 till 0,07 Wh | 0,001 till 0,007 Wh | 0,01 till 0,08 g |
Kort sagt: för GPT-4o ger Epochs siffror ungefär 0,6 wattimmar per 1 000 tokens modellen skriver, och ungefär 0,2 per 1 000 tokens den läser. För modellerna i DentroChat uppskattar vi 0,05 till 0,4 wattimmar per 1 000 skrivna tokens och 0,01 till 0,07 per 1 000 lästa tokens. Lästes texten för några minuter sedan ligger den i cache, och då kostar det ungefär en tiondel igen. På EU-genomsnittsnätet är 1 000 skrivna tokens ungefär 0,13 gram CO2 för GPT-4o och 0,01 till 0,08 gram för våra modeller.
Våra prompter är större än «normal prompt» i studierna. Varje meddelande skickar också modellens instruktioner och tool-beskrivningar med, redan ungefär 3k tokens. Utöver det kommer ditt minne, chatten hittills, och eventuella filer eller websökresultat. Använder modellen ett tool läser den allt igen. Den kan först bestämma sig för att söka på webben och sedan läsa hela chatten plus sökresultat för att skriva svaret. Ett meddelande från dig kan alltså betyda flera modellkörningar.
Alla siffror i tabellen nedan är per meddelande du skickar. Har ett meddelande fått modellen att köra flera gånger har vi summerat körningarna på en rad.
Vi tittade i våra användningsloggar och räknade tokens (det du skriver läser vi såklart inte). Tabellen bygger på 606 prompter en dag i oktober 2026. Vi kollade också de 21 700 prompterna de 30 dagarna före, och medianen var väldigt lik:
| DentroChat-prompt | Läst | varav cachet | Skrivet | El (vår uppskattning) | CO2, EU-genomsnitt | CO2, Tyskland |
|---|---|---|---|---|---|---|
| Median | ~41k | ~30k | ~900 | 0,2 till 1,3 Wh | 0,04 till 0,3 g | 0,06 till 0,4 g |
| Övre 10 % | ~131k | ~66k | ~4 600 | 1 till 7 Wh | 0,2 till 1,4 g | 0,3 till 2,3 g |
Kort sagt: median DentroChat-prompt läser ungefär 41k tokens, varav ungefär 30k är cachet eftersom de skickades några minuter tidigare. Den skriver ungefär 900 tokens. Vi uppskattar det till 0,2 till 1,3 wattimmar, ungefär 0,04 till 0,3 gram CO2 på EU-genomsnittsnätet och 0,06 till 0,4 gram i Tyskland. Övre 10 % läser 131k tokens eller mer och skriver 4 600 eller mer. Det är ungefär 1 till 7 wattimmar, eller 0,2 till 1,4 gram CO2 på EU-genomsnittet och 0,3 till 2,3 gram i Tyskland.
För raden «Övre 10 %» tog vi percentilvärdet per kolumn för sig. En riktig prompt träffar sällan alla kolumner samtidigt, så raden är med flit på den tunga sidan.
Det finns också jobb i bakgrunden, som att uppdatera ditt minne och sammanfatta långa chattar. Ibland är en modell för långsam och vi byter mitt i ett svar till en backup-modell. De körningarna finns inte i tabellen. Fördelar du dem över alla prompter läser genomsnittsprompten ungefär 76k tokens (50k cachet) och skriver ungefär 2k. Det landar ungefär 0,4 till 3 wattimmar.
En DentroChat-prompt läser alltså mycket mer än normal prompt i studierna. Per token är den billigare. Medianen (0,2 till 1,3 Wh) ligger nederst nära 0,3 Wh för stora modeller och upptill ungefär hälften av deras långa dokument på 2,5 Wh.
Till jämförelse: vattenkokare och kort bilresa
Det tar ungefär 100 wattimmar värme att värma en liter vatten från kran till kok. En del når inte vattnet, så i uttaget är det mer som 110 till 125 wattimmar.
En median DentroChat-prompt är en liten del av det. Vi använder den höga änden av vår uppskattning, 1,3 wattimmar, så jämförelsen ligger på den tunga sidan. Då behöver du ungefär 90 DentroChat-prompter för en liter.
För bilen tar vi genomsnittet för nya bilar 2025 från Europeiska miljöbyrån: 96,7 g CO2 per kilometer enligt labbtest. Genomsnittet inkluderar elbilar som räknas som noll utsläpp, så en bensinbil på vägen drar förmodligen lite mer.
Per kilometer i en sådan genomsnittlig ny bil kunde du skicka ungefär 240 median DentroChat-prompter i Tyskland. Igen den tunga sidan: 0,4 gram CO2 per prompt. På EU-genomsnittsnätet är samma prompt 0,3 gram, alltså ungefär 320 prompter per kilometer.
Språk påverkar antalet tokens
Olika språk tokeniserar samma sida i olika många tokens. Vi körde våra artiklar genom tokenizers för alla 17 språk DentroChat stödjer.
Vi använde 22 blogginlägg som finns på varje språk, alltså samma text varje gång. Huvudsiffran kommer från GPT-4o-tokenizer. Spannet är lägsta och högsta över sex tokenizers (GPT-4o, GPT-4, Mistral, Llama 3, Qwen 2.5 och DeepSeek V3).
| Språk | Tokens per ord | Spann | Ord i 10k tokens |
|---|---|---|---|
| Engelska | 1,3 | 1,3 till 1,4 | ~7 700 |
| Spanska | 1,4 | 1,4 till 1,7 | ~7 200 |
| Portugisiska | 1,4 | 1,4 till 1,7 | ~7 000 |
| Franska | 1,4 | 1,4 till 1,7 | ~6 900 |
| Nederländska | 1,6 | 1,6 till 2,1 | ~6 300 |
| Italienska | 1,7 | 1,7 till 1,9 | ~6 000 |
| Tyska | 1,7 | 1,7 till 2,1 | ~5 800 |
| Norska | 1,9 | 1,9 till 2,2 | ~5 400 |
| Svenska | 1,9 | 1,9 till 2,3 | ~5 300 |
| Danska | 1,9 | 1,9 till 2,3 | ~5 300 |
| Rumänska | 1,9 | 1,9 till 2,2 | ~5 300 |
| Kroatiska | 2,1 | 2,1 till 2,6 | ~4 800 |
| Polska | 2,2 | 2,2 till 2,6 | ~4 500 |
| Grekiska | 2,4 | 2,4 till 5,9 | ~4 200 |
| Estniska | 2,5 | 2,5 till 3,1 | ~4 000 |
| Ungerska | 2,6 | 2,5 till 3,1 | ~3 900 |
| Finska | 2,8 | 2,8 till 3,5 | ~3 600 |
Kort sagt: på GPT-4o-tokenizer är engelska ungefär 1,3 tokens per ord, så 10k tokens är ungefär 7 700 engelska ord. Spanska, portugisiska och franska ligger strax efter med ungefär 1,4. Nederländska ungefär 1,6, tyska och italienska ungefär 1,7, så 10k tokens är ungefär 5 800 tyska ord. De nordiska språken utom finska ligger runt 1,9. Estniska ungefär 2,5 och finska högst med ungefär 2,8, så 10k tokens är bara ungefär 3 600 finska ord.
Ofta sägs det att ett tyskt ord är tre tokens. På moderna tokenizers mäter vi snarare två. Grekiska har det stora spannet eftersom äldre tokenizers hanterar det grekiska alfabetet dåligt.
Ett finskt dokument av samma längd använder alltså fler tokens och därmed mer el. Gram CO2 per Wh följer elnätet ovan.
Det vi inte har tagit med
Det här handlar om elen till ett svar på ett meddelande.
Modellträning skedde tidigare en gång och delas mellan alla som använder modellen. Att fördela träningskostnaden på din prompt skulle vara gissning, så den är borta.
Sedan kommer kostnaden att tillverka grafikkort. Nvidias sammanställning för ett H100-kort: 1 312 kg CO2-ekvivalent för 8 GPU:er över några års drift. För en prompt bär du bara en liten bråkdel, klart under 1 g. På ett rent nät som Sverige kan den bråkdelen närma sig CO2 från själva elen. På det tyska nätet är elen mycket större.
Och vatten. Det virala påståendet att AI dricker en vattenflaska kommer från en 2023-uppskattning för GPT-3: ungefär 500 ml för 20 till 50 svar, i varma amerikanska datacenter som kyls genom avdunstning. Google mätte 0,26 ml för median Gemini-textprompt (ungefär fem droppar). Många europeiska datacenter kyls med utomhusluft och använder knappt något vatten, inklusive Hetzner i Tyskland där DentroChat hostas, och de svenska datacentren där en del av våra modeller körs. Mer i Slösar AI vatten? och mer detaljerat i AI:s vattenförbrukning: varför virala siffror vilseleder.
Det finns också det praktiska: stannar du i samma chatt ligger det långa dokumentet oftast några minuter i minnet, så nästa meddelande mest bearbetar den nya texten. OpenAI och Anthropic beskriver cache som går ut efter ungefär 5 till 10 minuter utan aktivitet. Det är kolumnen «cachet» i vår DentroChat-tabell. Det hjälper också när modellen kör flera gånger för ett meddelande, eftersom andra körningen kan återanvända det den första redan läste.
Vi skulle gärna visa dig ett riktigt wattimtal för varje meddelande i DentroChat, den bästa EU AI-chatten. För det måste de som kör modellerna berätta energin per request, och de flesta gör det inte än.
Tills dess är det här vår bästa uppskattning. På stora modeller som GPT-4o använder en normal prompt ungefär 0,3 wattimmar och ett långt dokument ungefär 2,5. En median DentroChat-prompt på våra mindre modeller använder ungefär 0,2 till 1,3 wattimmar. På EU-genomsnittsnätet är det högst ungefär 0,3 gram CO2.