Câtă energie consumă un prompt AI?
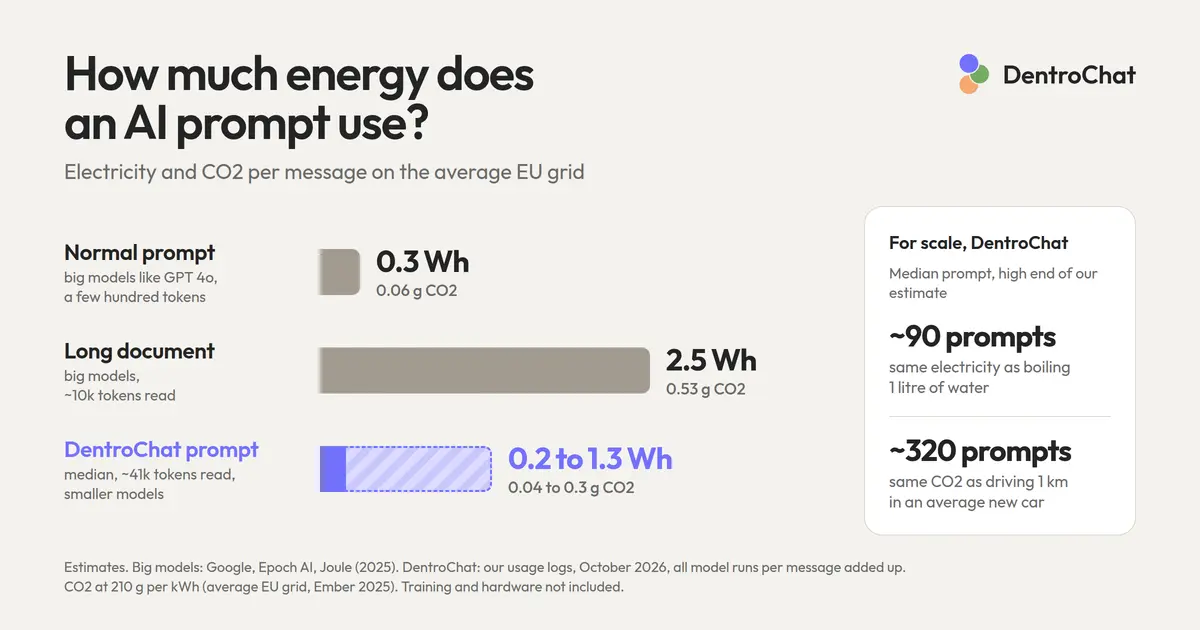
Utilizatorii DentroChat, asistentul nostru AI din UE, ne întreabă uneori cât curent se consumă pe mesajele lor. E o întrebare firească. Ți-am arăta cu plăcere o cifră în produs, dar firmele care rulează modelele în cloud, în mare parte, încă nu publică energia pentru o singură cerere. Așa că am făcut ce am putut și am aproximat folosind cercetări publice.
Astea nu sunt măsurători de laborator pe DentroChat. Am parcurs studiile pe care le-am găsit, le-am comparat între ele, iar cifrele de mai jos sunt unde se întâlnesc. Dacă ai o sursă mai bună, spune-ne.
Curent pentru un prompt obișnuit
Un prompt tipic: pui o întrebare, modelul răspunde cu câteva sute de tokeni. Un token e o bucățică de cuvânt sau un cuvânt întreg dacă e scurt.
Asta a măsurat Google. În mai 2025, promptul text median în aplicațiile Gemini era 0,24 Wh. Include cipul și răcirea întregii săli din datacenter. Google a calculat că pentru promptul median CO2 e 0,03 g (la mixul electric al Google).
Epoch AI a estimat un răspuns tipic în ChatGPT în februarie 2025 la cam 0,3 Wh, pentru vreo 500 de tokeni de răspuns. Ei înșiși spun că estimarea e puțin mare.
Un articol în Joule din aprilie 2026. Datele vin din deploy-uri din 2025. Mediana pentru un model mare e 0,31 Wh. Sam Altman a scris în iunie 2025 că media unei interogări ChatGPT e ~0,34 Wh.
Pentru un prompt tipic am spune 0,3 Wh. Măsurarea și estimările ies cam la fel.
Curent pentru un prompt mai lung
Un document lung e mai multă muncă, pentru că trebuie citit mult.
Epoch AI a estimat că vreo 10k tokeni la intrare duc la cam 2,5 Wh pentru o astfel de interogare. Ca să vezi ce înseamnă în cuvinte, am numărat tokeni pe paginile noastre. Cifrele de aici folosesc tokenizerul GPT 4o: cam 7.700 cuvinte în engleză și cam 5.800 în germană, deci un articol lung sau un chat cu multe mesaje. Mai jos am trecut aceleași pagini prin încă cinci tokenizere, iar tabelul arată cât de departe stau față de GPT 4o.
Jegham et al. au făcut propria estimare pentru un prompt de 10k intrare, 1500 ieșire. A ieșit între ~1,4 și 2,9 Wh, în funcție de model. Cam aceeași ordine de mărime ca la Epoch.
Dacă modelul gândește mult și scrie mii de tokeni înainte să apară răspunsul, se consumă mai mult curent. În articolul Joule, un răspuns de vreo 5k tokeni e ~4 Wh. E un răspuns de tip „reasoning”, unde modelul calculează mult.
Iată totul într-un singur tabel. Sunt modele mari ca GPT 4o și Gemini:
| Tip de prompt | Tokeni, aproximativ | Curent | Sursă |
|---|---|---|---|
| Prompt obișnuit | întrebare scurtă, câteva sute tokeni înapoi | ~0,3 Wh | Google, Epoch AI, Joule, Altman |
| Document lung | ~10k intrare, 500–1500 ieșire | ~2,5 Wh (1,4–2,9) | Epoch AI, Jegham et al. |
| Răspuns reasoning | ~5k ieșire | ~4 Wh | Joule |
Pe scurt: un prompt obișnuit folosește cam 0,3 Wh. Un document de vreo 10k tokeni cam 2,5 Wh, undeva între 1,4 și 2,9 după model. Un răspuns reasoning lung de vreo 5k tokeni cam 4 Wh.
CO2 depinde de rețea
Curentul pentru același model e cam același oriunde stau serverele. CO2 depinde de rețeaua locală.
Am luat cifrele Ember din 2025, vizibile în „Our World in Data”. Sunt valori de ciclu de viață: includ lanțul de aprovizionare al energiei peste emisiile centralei. Măsurate în grame echivalent CO2 pe kilowatt-oră.
Le-am înmulțit cu cele două cifre ale noastre: 0,3 Wh pentru un prompt obișnuit și 2,5 Wh pentru un document lung:
| Rețea | g CO2e per kWh | Prompt obișnuit | Document lung |
|---|---|---|---|
| Norvegia | 28 | 0,01 g | 0,07 g |
| Suedia | 35 | 0,01 g | 0,09 g |
| Franța | 41 | 0,01 g | 0,10 g |
| Finlanda | 57 | 0,02 g | 0,14 g |
| Danemarca | 114 | 0,03 g | 0,29 g |
| Austria | 117 | 0,04 g | 0,29 g |
| Spania | 154 | 0,05 g | 0,38 g |
| Media UE | 210 | 0,06 g | 0,53 g |
| Olanda | 254 | 0,08 g | 0,63 g |
| Italia | 285 | 0,09 g | 0,71 g |
| Estonia | 319 | 0,10 g | 0,80 g |
| Germania | 330 | 0,10 g | 0,82 g |
| Statele Unite | 384 | 0,12 g | 0,96 g |
| Polonia | 589 | 0,18 g | 1,47 g |
Pe scurt: în Suedia (35 g per kWh) și Franța (41 g) un prompt obișnuit e cam 0,01 g CO2, iar un document lung cam 0,1 g. La media UE (210 g) e 0,06 g și cam 0,5 g. În Germania (330 g) cam 0,1 g și cam 0,8 g. Polonia are cel mai mare număr din tabel, 589 g, deci un prompt obișnuit cam 0,18 g și un document lung cam 1,5 g. SUA sunt în tabel pentru că multe cifre ChatGPT vin de acolo. La 384 g e cam 0,12 g pentru un prompt obișnuit și cam 1 g pentru un document lung.
În Germania, agenția de mediu spune lucruri similare pentru 2025: 344 g CO2 din generare și 406 g echivalent CO2 cu lanțul de aprovizionare. Electricity Maps dau consumul real de curent al oamenilor din Germania la 335 g în 2025. Orele individuale pot fi de la ~100 g la ~600 g.
Ce înseamnă pentru DentroChat?
Până acum toate cifrele erau pentru modele mari ca GPT 4o. Epoch presupunea cam 100 de miliarde de parametri activi la fiecare token, dar DentroChat folosește des modele mai mici. Sunt modele „mixture of experts”: modelul e mare, dar doar o parte mică lucrează per token. DeepSeek V4 Flash folosește cam 13 miliarde parametri per token, GLM 5.3 Flash cam 18 miliarde, iar Qwen 3.8 Flash Next cam 6 miliarde.
Mai puțini parametri activi înseamnă mai puțin curent per token și deci mai puțin CO2 per token. Clasamentul ML.ENERGY a măsurat asta pe GPU-urile lor. Un model Qwen cu 22 miliarde parametri activi a avut nevoie de cam 0,12 Wh per 1.000 tokeni scriși. DeepSeek V3.1 cu 37 miliarde cam 0,37 Wh. Asta e doar plăcile video, așa că am adăugat răcirea și restul serverelor. Modelele noastre sunt mai mici decât ambele, deci estimarea noastră:
| Per 1.000 tokeni | Parametri activi per token | Scriși | Citiți, proaspăt | Citiți, în cache | CO2 per 1.000 scriși, media UE |
|---|---|---|---|---|---|
| GPT 4o (presupunerea Epoch) | ~100 mld | ~0,6 Wh | ~0,2 Wh | ~0,13 g | |
| Modele DentroChat (estimarea noastră) | 6–18 mld | 0,05–0,4 Wh | 0,01–0,07 Wh | 0,001–0,007 Wh | 0,01–0,08 g |
Pe scurt: la GPT 4o, cifrele Epoch dau cam 0,6 Wh la fiecare 1.000 tokeni pe care modelul îi scrie și cam 0,2 la fiecare 1.000 citiți. Pentru modelele din DentroChat estimăm 0,05–0,4 Wh per 1.000 scriși și 0,01–0,07 per 1.000 citiți. Dacă textul a fost citit cu câteva minute în urmă, e în cache și costă cam o zecime. Pe rețeaua medie UE, 1.000 tokeni scriși sunt cam 0,13 g CO2 pentru GPT 4o și 0,01–0,08 g pentru modelele noastre.
Dar prompturile noastre sunt mai mari decât „promptul obișnuit” din studii. Fiecare mesaj trimite modelului instrucțiunile și descrierile uneltelor, deja cam 3k tokeni. Pe deasupra vin memoria ta, chatul de până acum și eventuale fișiere sau rezultate de căutare web. Când modelul folosește o unealtă, citește totul din nou. De exemplu, mai întâi decide să caute pe web, apoi citește tot chatul împreună cu rezultatele ca să scrie răspunsul. Un mesaj de la tine poate însemna mai multe rulări ale modelului.
Toate cifrele din tabelul de mai jos sunt per mesaj pe care îl trimiți. Dacă un mesaj a făcut modelul să ruleze de mai multe ori, am adunat rulările într-un singur rând.
Așa că ne-am uitat în logurile noastre de utilizare și am numărat tokenii (ce scrii tu, bineînțeles, nu citim). Tabelul folosește 606 prompturi dintr-o zi din octombrie 2026. Am verificat și cele 21.700 prompturi din cele 30 de zile anterioare, mediana era foarte similară:
| Prompt DentroChat | Tokeni citiți | din care în cache | Tokeni scriși | Curent (estimarea noastră) | CO2, media UE | CO2, Germania |
|---|---|---|---|---|---|---|
| Mediană | ~41k | ~30k | ~900 | 0,2–1,3 Wh | 0,04–0,3 g | 0,06–0,4 g |
| Top 10% | ~131k | ~66k | ~4.600 | 1–7 Wh | 0,2–1,4 g | 0,3–2,3 g |
Pe scurt: promptul median DentroChat citește cam 41k tokeni, din care cam 30k sunt în cache pentru că au fost trimiși cu câteva minute înainte. Scrie cam 900 tokeni. Estimăm 0,2–1,3 Wh, adică cam 0,04–0,3 g CO2 pe rețeaua medie UE și 0,06–0,4 g în Germania. Top 10% citesc 131k tokeni sau mai mult și scriu 4.600 sau mai mult. Asta e cam 1–7 Wh, sau 0,2–1,4 g CO2 pe media UE și 0,3–2,3 g în Germania.
Pentru rândul „Top 10%” am luat linia fiecărei coloane separat. Un prompt real rar atinge toate deodată, deci rândul e intenționat pe partea grea.
Mai e muncă în fundal, ca actualizarea memoriei și rezumarea chat-urilor lungi. Uneori un model e prea lent și trecem la unul de rezervă la jumătate. Acele rulări nu sunt în tabel. Dacă le împarți la toate prompturile, promptul mediu citește cam 76k tokeni (50k în cache) și scrie cam 2k. Asta ajunge la cam 0,4–3 Wh.
Deci un prompt DentroChat citește mult mai mult decât promptul obișnuit din studii. Fiecare token e mai ieftin. Mediana (0,2–1,3 Wh) e aproape de 0,3 Wh al modelelor mari la capătul de jos și cam jumătate din documentul lor lung (2,5 Wh) la capătul de sus.
Comparativ: fierbătorul și o scurtă călătorie
Ai nevoie cam de 100 Wh de căldură ca să aduci un litru de apă de la robinet la fierbere. O parte nu ajunge în apă, deci la priză e mai degrabă 110–125 Wh.
Un prompt median DentroChat e o mică parte din asta. Folosim capătul superior al estimării, 1,3 Wh, ca să rămână comparația pe partea grea. În ritmul ăsta ai nevoie de cam 90 prompturi DentroChat pentru un litru.
Pentru mașină luăm media pentru mașini noi în 2025 de la Agenția Europeană de Mediu: 96,7 g CO2 per km în teste de laborator. Media include și electrice, care contează zero evacuare, deci un benzină pe drum consumă puțin mai mult.
Pentru fiecare kilometru cu o astfel de mașină nouă medie poți trimite cam 240 prompturi mediane DentroChat în Germania. Din nou capătul superior: 0,4 g CO2 per prompt. Pe rețeaua medie UE același prompt e 0,3 g CO2, deci cam 320 prompturi per kilometru.
Limba influențează numărul de tokeni
Limbi diferite împart aceeași pagină în numere diferite de tokeni. Am trecut articolele noastre prin tokenizere pentru toate cele 17 limbi pe care le suportă DentroChat.
Am folosit 22 postări de blog, care există în fiecare limbă, deci același text de fiecare dată. Cifra principală vine de la tokenizerul GPT 4o. Intervalul e minimul și maximul din șase tokenizere (GPT 4o, GPT 4, Mistral, Llama 3, Qwen 2.5 și DeepSeek V3).
| Limbă | Tokeni per cuvânt | Interval | Cuvinte în 10k tokeni |
|---|---|---|---|
| engleză | 1,3 | 1,3–1,4 | ~7.700 |
| spaniolă | 1,4 | 1,4–1,7 | ~7.200 |
| portugheză | 1,4 | 1,4–1,7 | ~7.000 |
| franceză | 1,4 | 1,4–1,7 | ~6.900 |
| olandeză | 1,6 | 1,6–2,1 | ~6.300 |
| italiană | 1,7 | 1,7–1,9 | ~6.000 |
| germană | 1,7 | 1,7–2,1 | ~5.800 |
| norvegiană | 1,9 | 1,9–2,2 | ~5.400 |
| suedeză | 1,9 | 1,9–2,3 | ~5.300 |
| daneză | 1,9 | 1,9–2,3 | ~5.300 |
| română | 1,9 | 1,9–2,2 | ~5.300 |
| croată | 2,1 | 2,1–2,6 | ~4.800 |
| poloneză | 2,2 | 2,2–2,6 | ~4.500 |
| greacă | 2,4 | 2,4–5,9 | ~4.200 |
| estonă | 2,5 | 2,5–3,1 | ~4.000 |
| maghiară | 2,6 | 2,5–3,1 | ~3.900 |
| finlandeză | 2,8 | 2,8–3,5 | ~3.600 |
Pe scurt: la tokenizerul GPT 4o engleza e cam 1,3 tokeni per cuvânt, deci 10k tokeni sunt cam 7.700 cuvinte în engleză. Spaniola, portugheza și franceza sunt aproape, cam 1,4. Olandeza cam 1,6, germana și italiana cam 1,7, deci 10k tokeni sunt cam 5.800 cuvinte în germană. Limbile nordice exceptând finlandeza stau cam la 1,9. Estona cam 2,5, finlandeza cea mai mare, cam 2,8, deci 10k tokeni sunt doar cam 3.600 cuvinte în finlandeză.
Des se spune că un cuvânt german e 3 tokeni. Pe tokenizere moderne măsurăm mai degrabă 2. Greaca are intervalul mare pentru că tokenizerele vechi gestionează prost alfabetul grecesc.
Deci documentul finlandez, aceeași lungime, folosește mai mulți tokeni și deci mai mult curent. Gramii CO2 per Wh de pe rețea rămân ca mai sus.
Ce n-am acoperit
Aici e curentul pentru un răspuns la un mesaj.
Antrenarea modelului s-a făcut o dată, înainte, și o împart toți ce-l folosesc. Să aloci costul antrenării promptului tău ar fi ghicit, așa că l-am lăsat afară.
E și costul fabricării plăcilor video. Defalcarea Nvidia pentru o placă H100: 1312 kg echivalent CO2 pentru 8 GPU. Asta pe câțiva ani de funcționare. Pentru un prompt cari doar o fracțiune mică, mult sub 1 g. Pe o rețea curată ca Suedia, fracțiunea se apropie de CO2-ul curentului. Pe rețeaua germană curentul e mult mai mare.
Apoi e apa. Afirmația virală că AI bea o sticlă de apă vine dintr-o estimare din 2023 pentru GPT 3: cam 500 ml pentru 20–50 răspunsuri, în datacenter-e americane fierbinți răcite prin evaporare. Google a măsurat 0,26 ml pentru promptul text median Gemini (~cinci picături). Multe datacenter-e europene răcesc cu aer exterior și aproape nu folosesc apă!! Asta include Hetzner în Germania, unde e găzduit DentroChat, și datacenter-ele suedeze unde rulează o parte din modelele noastre. Am scris mai mult în IA risipește apă? Mit sau nu, dacă folosești infrastructură în UE și mai detaliat în Consumul de apă al AI: De ce cifrele virale sunt înșelătoare.
Mai e un aspect practic. Dacă ești în același chat, documentul lung de obicei stă în memorie câteva minute. Mesajul următor procesează în principal textul nou. OpenAI și Anthropic vorbesc despre cache-uri care expiră după cam 5–10 minute fără activitate. Asta e coloana „în cache” din tabelul DentroChat. Ajută și când modelul rulează de mai multe ori pentru un mesaj, pentru că a doua rulare poate refolosi ce a citit prima.
Tot am vrea să-ți arătăm un număr real de wat-ore pentru fiecare mesaj în DentroChat, cel mai bun EU AI Chat. Pentru asta, furnizorii care rulează modelele ar trebui să ne spună energia fiecărei cereri, iar majoritatea încă nu o fac.
Până atunci, asta e cea mai bună aproximare a noastră. Pe modele mari ca GPT 4o, un prompt obișnuit folosește cam 0,3 Wh și un document lung cam 2,5. Un prompt median DentroChat pe modelele noastre mai mici folosește cam 0,2–1,3 Wh. Pe rețeaua medie UE asta e cel mult cam 0,3 g CO2.