Este criptat chat-ul tău AI? ChatGPT, Lumo și DentroChat
Acum ceva vreme, un utilizator DentroChat ne-a scris:
Lumo spune că criptează toate conversațiile. DentroChat face același lucru sau are o abordare diferită?
Întrebarea m-a pus pe gânduri, pentru că odinioară mi-am scris lucrarea de licență despre criptografie și, în sfârșit, am vrut să-mi notez gândurile cum trebuie. Răspunsul meu a ieșit destul de lung și tehnic, așa că, dacă unele părți devin prea dense, poate cel mai bine ar fi să lipești acest articol în Lumo sau în DentroChat și să lași un AI să ți-l explice mai simplu :-)
Ca să răspund corect la întrebarea cum funcționează chat-ul AI criptat, să vedem mai întâi cum funcționează criptarea Proton, apoi Lumo, apoi cum fac DentroChat și ChatGPT.
Cum funcționează criptarea zero-knowledge a Proton
Suntem mari fani ai ecosistemului Proton și îl folosim activ de ani de zile pentru VPN, e-mail, apeluri video și multe altele.
Marele atu al Proton este configurația zero-knowledge. Perechile de chei publice-private sunt derivate din parola contului tău și sunt unice pentru fiecare utilizator. Cheia privată este folosită pentru a cripta e-mailurile noastre, fișierele din Drive etc. Doar utilizatorul, adică noi, poate decripta propriile date pe dispozitivul local. Angajații Proton nu pot decripta datele noastre, pentru că nu au acces niciodată la cheia noastră privată.
Avantajul este că, chiar dacă NSA „stă” în interiorul unui server Proton, nu va putea obține datele noastre (cel puțin atâta timp cât toate celelalte ipoteze de securitate se mențin). Dezavantajul este că, dacă vreodată pierdem parola Proton și codurile de rezervă și nu avem configurată nicio metodă de recuperare, Proton nu va putea restaura datele noastre.
Dacă vrei să înțelegi de la zero cum funcționează criptarea cu chei publice și private, acest videoclip YouTube despre criptografia cu cheie publică este excelent. Când l-am văzut în primul an de facultate, m-a dat pur și simplu peste cap!
Lumo: de ce un LLM schimbă tabloul
Lumo este fundamental diferit de celelalte servicii Proton din cauza modului în care funcționează modelele lingvistice mari (LLM). Ca să primești un răspuns de la un model AI/LLM, trebuie să introduci datele în model în text simplu, adică decriptat. (Există abordări prin care se poate face asta mai criptat, despre care vorbim mai jos.)
Dacă ai rula un LLM local pe propriul calculator, abordarea clasică de criptare Proton ar funcționa în continuare: decriptezi datele local pe mașina ta, le dai modelului LLM local, primești un răspuns și criptezi din nou datele local. Asta este abordarea când rulezi modele locale cu instrumente precum Ollama.
Problema este că cele mai bune LLM-uri au nevoie de mașini foarte puternice, ceea ce pur și simplu nu este realist pe un computer obișnuit de consum. Prin urmare, LLM-ul trebuie să ruleze pe un server Proton, iar datele tale trebuie decriptate înainte de a fi introduse în LLM-ul Proton.
Ce se întâmplă când trimiți un mesaj către Lumo
Când folosești Lumo, funcționează așa (după cum este documentat în modelul de securitate Lumo al Proton):
- Îți decriptezi local, pe dispozitiv, istoricul conversațiilor.
- Adaugi un mesaj nou de la utilizator.
- Întregul istoric de mesaje, împreună cu mesajul tău nou, este criptat cu cheia publică a serverului Proton unde rulează LLM-ul.
- Datele tale criptate ajung la serverul Proton și sunt decriptate cu cheia privată a serverului. Datele decriptate sunt introduse în LLM, iar un răspuns este generat.
- Răspunsul generat este criptat din nou și trimis înapoi către tine.
- Îl decriptezi pe dispozitivul tău și citești răspunsul.
Este o abordare foarte solidă, ținând cont de constrângeri.
Singurul lucru este: abordarea nu mai este zero-knowledge în timpul inferenței. Dacă poliția elvețiană, NSA sau un angajat necinstit al Proton ascultă în interiorul serverului Proton unde datele tale sunt decriptate înainte de a fi introduse în LLM, pot să le citească. Lumo nu folosește criptare end-to-end (E2EE) ca celelalte servicii Proton, ci ceva ce ei numesc User-to-Lumo Encryption (U2L). Punctul forte al Lumo este că istoricul tău salvat al conversațiilor este criptat cu cheia ta în repaus, astfel încât nimeni de la Proton nu poate citi mai târziu conversațiile tale vechi.
Cum face DentroChat
Am încercat să găsim o modalitate de a asigura adevărată criptare end-to-end pentru DentroChat și am ajuns la o arhitectură foarte apropiată de ea. Din păcate, nu a fost fezabil din punct de vedere financiar pentru noi să o construim (încă).
Abordarea noastră actuală este criptarea clasică folosită de majoritatea aplicațiilor moderne: criptare în tranzit și criptare în repaus:
- Când îți trimitem datele tale sau când tu trimiți datele tale către DentroChat, acest trafic este criptat în tranzit folosind TLS (care folosește perechi de chei publice-private pentru a stabili conexiunea criptată).
- Când datele tale sunt stocate pe serverele noastre din Germania, sunt criptate în repaus (ceea ce configurăm și administrăm noi înșine, deoarece furnizorii standard de găzduire nu criptează discurile în repaus implicit). Dacă un atacator copiază hard diskul serverelor noastre, obține doar date criptate.
Am ales această abordare pentru că, în momentul în care AI-ul răspunde la promptul tău, are aceeași ipoteză de bază de încredere ca Lumo: utilizatorul trebuie să aibă încredere că nu citim datele lui în timpul procesării. Abordarea noastră actuală a fost mult mai simplu de configurat, în timp ce abordarea Proton este mai sofisticată și pune mai multe obstacole în calea potențialilor atacatori pentru istoricul conversațiilor salvate. Este posibil să mergem și noi pe drumul lor la un moment dat, dacă vedem un beneficiu clar. Deocamdată, abordarea DentroChat este sigură, solidă și testată în timp de multe aplicații.
Cum îți criptează ChatGPT conversațiile (și unde este capcana)
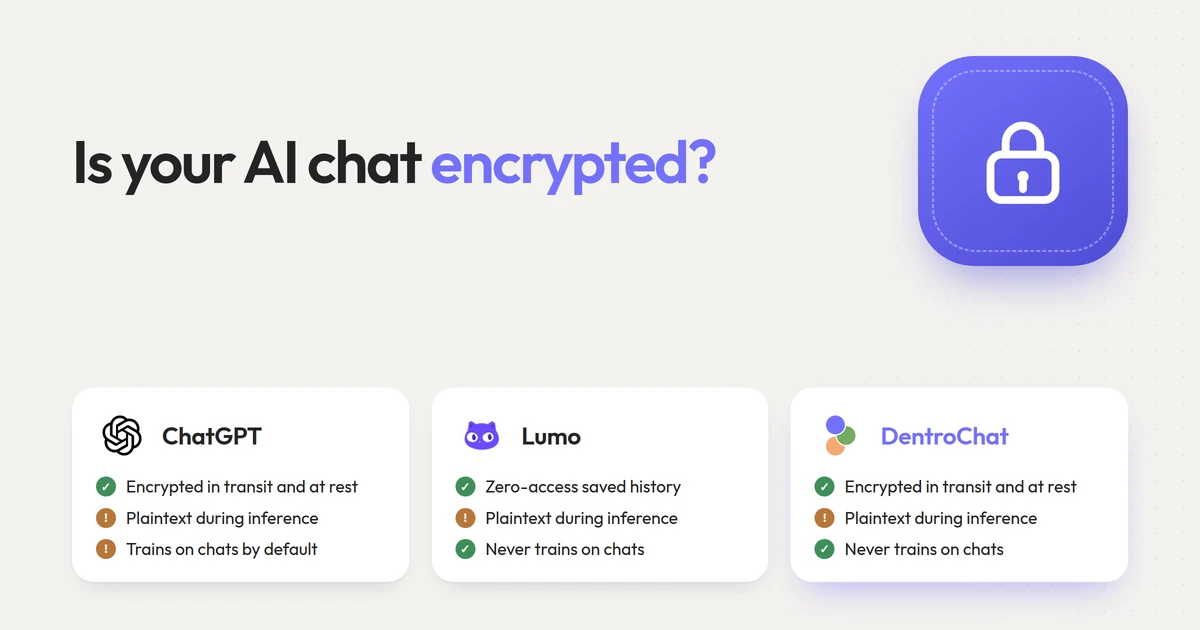
Pe hârtie, ChatGPT folosește exact aceleași blocuri criptografice ca DentroChat și ca majoritatea software-ului cloud: criptare în tranzit (TLS) între browserul tău și serverele OpenAI și criptare în repaus (AES-256) pe discurile lor. ChatGPT nu folosește nici el criptare end-to-end, pentru că GPU-urile OpenAI au nevoie și ele de promptul tău în text simplu pentru a genera un răspuns.
Diferența la ChatGPT nu este cine deține cheile și ce are voie OpenAI să facă cu datele tale atunci când le decriptează:
- Antrenarea modelelor și revizuirea umană: La ChatGPT Free și Plus, conversațiile tale decriptate sunt folosite implicit pentru a antrena viitoarele modele OpenAI, iar conversațiile selectate pot fi citite de revizori umani, cu excepția cazului în care te dezabonezi manual din setări. Nici Lumo, nici DentroChat nu antrenează vreodată pe conversațiile tale.
- Păstrarea după ștergere: Chiar dacă ștergi o conversație sau folosești modul „Conversație temporară” al ChatGPT, OpenAI păstrează o copie pe serverele sale timp de până la 30 de zile (am detaliat toate aspectele aici).
- Expunere la US CLOUD Act: Deoarece OpenAI deține cheile de decriptare pentru conversațiile tale salvate și este o companie americană, autoritățile americane pot cere acces în baza US CLOUD Act. Chiar dacă spațiul tău de lucru este setat pe rezidența datelor în UE!
| ChatGPT | Proton Lumo | DentroChat | |
|---|---|---|---|
| Criptat în tranzit (TLS) | Da | Da | Da |
| Criptat în repaus | Da (OpenAI deține cheile) | Da (Zero-access, tu deții cheile) | Da (DentroChat deține cheile) |
| Criptat end-to-end în timpul inferenței AI | Nu (text simplu pe server) | Nu (text simplu pe server, U2L) | Nu (text simplu pe server) |
| Antrenează modele AI pe conversațiile tale | Da implicit (renunțare posibilă) | Niciodată | Niciodată |
| Supus US CLOUD Act | Da | Nu pentru conversații (SUA pentru facturare/suport) | Nu (stack 100% UE / elvețian) |
Două moduri de a obține criptare end-to-end (aproape) reală pentru AI
Așadar, se poate vreodată rula un LLM în cloud fără ca operatorul serverului să vadă promptul tău în text simplu? Există două abordări pentru un E2EE adevărat.
1. Criptarea homomorfă
Criptarea homomorfă este un domeniu de cercetare extraordinar. Îți permite să efectuezi calcule direct pe date criptate.
De exemplu: tu criptezi numărul 12, iar un alt utilizator criptează numărul 17. Cele două numere criptate sunt adunate printr-un calcul de adunare criptat. Rezultatul este numărul criptat 29, iar doar tu și celălalt utilizator îl puteți decripta și afla că rezultatul este 29. Serverul care a făcut calculul nu a știut niciodată că numerele erau 12, 17 sau 29.
Acest exemplu este simplu, dar poate funcționa și pentru LLM-uri. În acest caz, introduci date criptate în LLM, LLM-ul produce un răspuns criptat, iar doar utilizatorul îl poate decripta. Se desfășoară aici cercetări academice importante, de exemplu această lucrare recentă despre inferența LLM criptată (Cachemir).
Problema criptării homomorfe este că este foarte costisitoare din punct de vedere computațional și, prin urmare, foarte lentă. Chiar și cu accelerările recente, vorbim despre aproximativ 100 de secunde de timp GPU pentru fiecare token generat, ceea ce înseamnă că ar trebui să aștepți 30 de minute pentru un răspuns simplu la „Care este capitala Spaniei?”
2. GPU-uri NVIDIA H100/H200 Confidential Computing (TEE)
A doua abordare este folosirea GPU-urilor NVIDIA H100/H200 Confidential Computing cu un Trusted Execution Environment (TEE).
Funcționează astfel: GPU-ul are propria pereche de chei privată-publică, înscrisă direct în hardware. Este creată o singură dată, la fabricarea GPU-ului, iar odată creată, cheia privată nu poate fi extrasă din exterior, nici măcar de persoana care deține rackul de servere.
Acest lucru este excelent, pentru că acum poți cripta datele cu cheia publică a GPU-ului și să le trimiți serverului. GPU-ul le decriptează în interiorul propriei enclave hardware folosind cheia sa privată, le trimite LLM-ului care rulează în interiorul GPU-ului, criptează din nou răspunsul și ți-l trimite înapoi.
Astfel, obținem un E2EE aproape real. Singurul vector de atac hardware rămas este în etapa de fabricație: dacă NSA ar fi înregistrat toate cheile private în timp ce aceste GPU-uri NVIDIA erau create în fabrică, ar putea teoretic să intercepteze și să decripteze traficul mai târziu, când GPU-ul este pus în funcțiune. Totuși, un GPU NVIDIA cu TEE reprezintă o ipoteză de securitate foarte puternică.
Aveam două opțiuni pentru DentroChat: să cumpărăm noi astfel de GPU-uri sau să găsim un furnizor european care le oferă. Prima variantă era prea scumpă pentru noi: un singur H100 costă în jur de 40.000 de euro, iar ca să rulăm modelele mari cu greutăți deschise, precum cele pe care le avem în DentroChat, am avea nevoie de 8 bucăți. Ca afacere finanțată din resurse proprii, nu era posibil la acel moment. Nici găsirea unui furnizor european care folosește GPU-uri confidential computing nu era posibilă acum o jumătate de an. Totuși, aceasta este cea mai realistă cale de viitor, iar noi căutăm constant furnizori europeni de infrastructură AI care o susțin.
De ce credem că DentroChat este o alegere solidă alături de Lumo
Chiar fără criptare zero-access pentru istoricul salvat, există câteva motive pentru care mulți utilizatori aleg DentroChat în locul Lumo:
- Modele AI mai bune: Ultima dată când am testat Lumo, calitatea răspunsurilor a fost destul de slabă și lentă. Cu DentroChat, ai acces la cele mai bune modele open-source și la un agent harness adaptat, în spatele scenei.
- Zero subprocesatori americani în tot stack-ul: Atât Lumo, cât și DentroChat își rulează inferența AI pe servere europene și elvețiene. Totuși, Lumo direcționează în continuare facturarea și suportul pentru clienți prin companii americane (precum Stripe și Zendesk). La DentroChat nu folosim niciun subprocesator american, nicăieri. Poți verifica întregul nostru stack pe pagina noastră de subprocesatori.
Dacă vrei să compari cele două mai în detaliu, uită-te la testul nostru complet de alternative la Lumo, la ghidul nostru despre chat AI privat sau la modul în care se compară alternativele europene la ChatGPT. Și dacă ai vreodată o întrebare tehnică de genul acesta, nu ezita să ne scrii prin butonul de feedback din DentroChat!
Întrebări frecvente
ChatGPT este criptat end-to-end?
Nu. OpenAI îți criptează conversațiile în tranzit (TLS) și în repaus pe serverele sale, ceea ce reprezintă standardul de bază pentru aplicațiile cloud. Pentru că LLM-ul are nevoie de text simplu pentru a genera un răspuns, serverele OpenAI decriptează promptul tău pentru a-l procesa. Dacă nu ai un plan de business sau nu renunți explicit, conversațiile de consumator pot fi folosite și pentru antrenarea modelelor.
Este Proton Lumo criptat end-to-end?
Nu end-to-end. Lumo folosește ceea ce Proton numește criptare User-to-Lumo (U2L): istoricul tău salvat al conversațiilor este blocat cu criptare zero-access, astfel încât Proton nu poate citi conversațiile tale vechi, iar promptul tău este criptat până la serverul de inferență. Totuși, serverul GPU Proton trebuie să decripteze mesajul tău în memorie pentru a-l introduce în LLM.
Cum îmi criptează DentroChat conversațiile?
DentroChat criptează tot traficul în tranzit folosind TLS și stochează conversațiile și fișierele tale cu criptare în repaus administrată de noi, pe servere europene din Germania și Franța. La fel ca Lumo și ChatGPT, prompturile trebuie decriptate în memoria serverului în timpul inferenței, pentru ca modelul AI să poată răspunde la ele, iar noi nu antrenăm niciodată pe datele tale.
Poate un chat AI să fie vreodată cu adevărat criptat end-to-end?
Da, fie rulând un model mic local pe propriul computer, fie în cloud, folosind criptarea homomorfă sau GPU-uri NVIDIA Confidential Computing (TEE). Astăzi, criptarea homomorfă este încă mult prea lentă pentru un chat interactiv, în timp ce GPU-urile confidential computing reprezintă cea mai promițătoare cale de viitor, odată ce furnizorii europeni de găzduire le vor pune la dispoziție pe scară largă.