O teu chat de IA está encriptado? ChatGPT, Lumo e DentroChat
Há algum tempo, um utilizador do DentroChat contactou-nos:
O Lumo afirma que encripta todas as conversas. O DentroChat faz o mesmo ou tem uma abordagem diferente?
Esta pergunta deixou-me a pensar, porque escrevi a minha tese de licenciatura sobre criptografia há muitos anos, e desta vez queria mesmo pôr as minhas ideias por escrito como deve ser. A minha resposta acabou por ficar bastante longa e técnica, por isso, se alguma parte te parecer demasiado densa, talvez seja melhor colares este artigo no Lumo ou no DentroChat e deixares uma IA explicar-te tudo de forma mais simples :-)
Para responder bem à pergunta sobre como funciona o chat de IA encriptado, vejamos primeiro como funciona a encriptação da Proton, depois o Lumo, e por fim como o fazem o DentroChat e o ChatGPT.
Como funciona a encriptação zero-knowledge da Proton
Somos grandes fãs do ecossistema da Proton e usamo-lo ativamente há anos para VPN, e-mail, videochamadas e muito mais.
O grande atrativo da Proton é a sua configuração zero-knowledge. Os pares de chaves pública e privada são derivados da tua palavra-passe e são únicos para cada utilizador. Esta chave privada é usada para encriptar os nossos e-mails, conteúdos do Drive, etc. Só o utilizador, ou seja, nós, consegue desencriptar os seus próprios dados no dispositivo local. Os funcionários da Proton não conseguem desencriptar os nossos dados porque nunca chegam a ter acesso à nossa chave privada.
A vantagem é que, mesmo que a NSA esteja “sentada” dentro de um servidor da Proton, não consegue aceder aos nossos dados (pelo menos enquanto se mantiverem válidos todos os outros pressupostos de segurança). A desvantagem é que, se alguma vez perdermos a palavra-passe da Proton e os códigos de recuperação, e não tivermos configurado nenhum método de recuperação, a Proton não consegue restaurar os nossos dados.
Se quiseres perceber desde a base como funciona a encriptação de chave pública e privada, este vídeo do YouTube sobre criptografia de chave pública é excelente. Quando o vi no meu primeiro ano de universidade, fiquei completamente fascinado!
Lumo: porque é que um LLM muda o cenário
O Lumo é, por natureza, diferente dos outros serviços da Proton por causa da forma como funcionam os Large Language Models (LLM). Para obter uma resposta de um modelo de IA / LLM, é preciso enviar a entrada para o modelo em texto simples (plaintext), ou seja, desencriptada. (Existem abordagens para fazer isto de forma mais encriptada, falaremos disso mais abaixo.)
Se executasses um LLM localmente no teu computador, a abordagem clássica de encriptação da Proton descrita acima continuaria a funcionar: desencriptas os dados localmente na tua máquina, envias-os para o teu LLM local, obténs uma resposta e voltas a encriptar os dados localmente. É essa a abordagem quando executas modelos locais com ferramentas como o Ollama.
O problema é que os melhores LLM precisam de máquinas muito potentes, o que simplesmente não é viável num computador de utilizador comum. Por isso, o LLM tem de correr num servidor da Proton, e os teus dados têm de ser desencriptados antes de serem enviados para o LLM da Proton.
O que acontece quando envias uma mensagem ao Lumo
Quando usas o Lumo, o processo é este (conforme documentado no modelo de segurança do Lumo da Proton):
- Desencriptas o histórico das tuas mensagens localmente, no teu dispositivo.
- Acrescentas uma nova mensagem do utilizador.
- Todo o histórico de mensagens, juntamente com a tua nova mensagem, é encriptado com a chave pública do servidor da Proton onde corre o LLM.
- Os teus dados encriptados chegam ao servidor da Proton e são desencriptados com a chave privada desse servidor. Os dados desencriptados são enviados para o LLM, que gera uma resposta.
- A resposta gerada é novamente encriptada e enviada de volta para ti.
- Desencriptas a resposta no teu dispositivo e lês a resposta.
Tendo em conta as limitações, esta é uma abordagem muito sólida.
O único senão: a abordagem deixa de ser zero-knowledge durante a inferência. Se a polícia suíça, a NSA ou um funcionário mal-intencionado da Proton estiver a escutar dentro do servidor da Proton onde os teus dados são desencriptados antes de serem enviados para o LLM, pode ler os teus dados. O Lumo não usa End-to-End Encryption (E2EE) como os outros serviços da Proton, mas sim aquilo a que chamam User-to-Lumo Encryption (U2L). O que continua a destacar o Lumo é que o teu histórico de conversas guardado fica encriptado com a tua chave em repouso, por isso ninguém na Proton consegue ler mais tarde as tuas conversas antigas.
Como o faz o DentroChat
Tentámos encontrar uma forma de garantir uma verdadeira End-to-End Encryption no DentroChat e chegámos a uma arquitetura que está muito próxima disso. Infelizmente, não era financeiramente viável construí-la (ainda).
A nossa abordagem atual é a encriptação clássica usada pela maioria das aplicações modernas: encriptação em trânsito e encriptação em repouso:
- Quando te enviamos os teus dados, ou quando envias os teus dados ao DentroChat, este tráfego é encriptado em trânsito através de TLS (que usa pares de chaves públicas e privadas para estabelecer a ligação encriptada).
- Quando os teus dados são guardados nos nossos servidores na Alemanha, são encriptados em repouso (configurado e gerido por nós, já que os fornecedores de alojamento standard não encriptam os discos em repouso por defeito). Se um atacante copiar o disco rígido dos nossos servidores, só obtém dados encriptados.
Escolhemos esta abordagem porque, no momento em que a IA responde ao teu pedido, assenta no mesmo pressuposto de confiança que o Lumo: o utilizador tem de confiar que não lemos os seus dados durante o processamento. A nossa abordagem era muito mais simples de configurar, enquanto a da Proton é mais sofisticada e coloca mais obstáculos a potenciais atacantes no que toca ao histórico de conversas guardado. Também poderemos seguir esse caminho mais tarde, se virmos um benefício claro. Para já, a abordagem do DentroChat é segura, sólida e testada ao longo dos anos por muitas aplicações.
Como o ChatGPT encripta as tuas conversas (e onde está o problema)
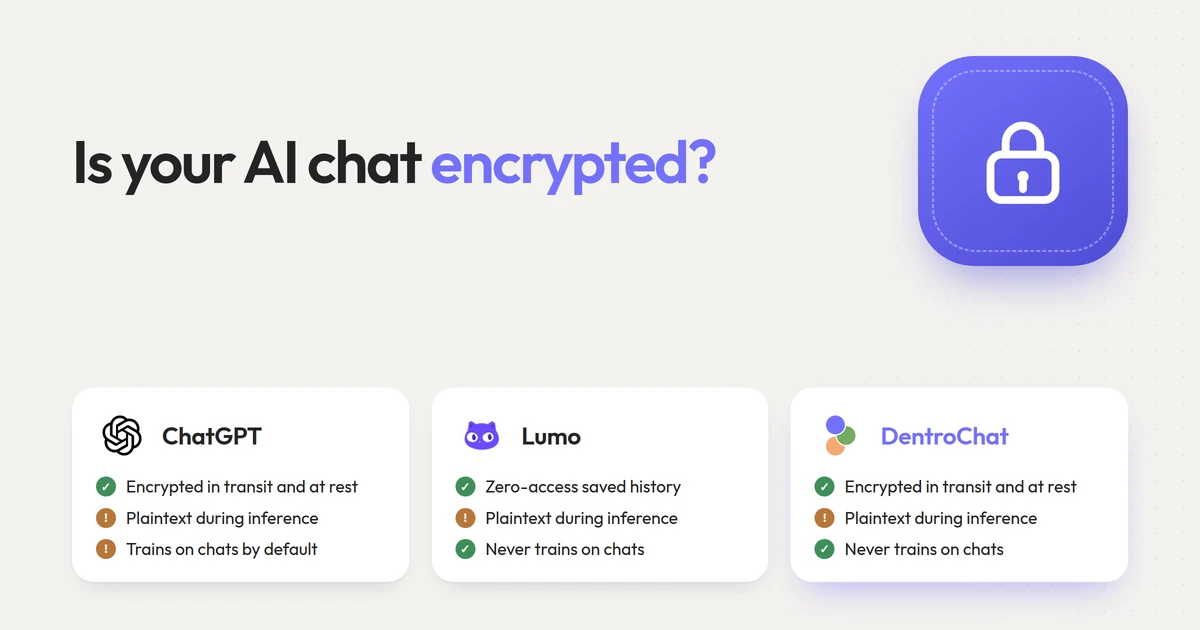
No papel, o ChatGPT usa exatamente os mesmos blocos criptográficos que o DentroChat e a maioria do software na cloud: encriptação em trânsito (TLS) entre o teu browser e os servidores da OpenAI, e encriptação em repouso (AES-256) nos discos deles. O ChatGPT também não usa encriptação de ponta a ponta, porque as GPU da OpenAI precisam igualmente do teu prompt em texto simples para gerar uma resposta.
A diferença no ChatGPT não está em quem detém as chaves e o que a OpenAI pode fazer com os teus dados quando os desencripta:
- Treino de modelos e revisão humana: No ChatGPT Free e Plus, as tuas conversas desencriptadas são usadas por defeito para treinar futuros modelos da OpenAI, e conversas selecionadas por amostragem podem ser lidas por revisores humanos, a menos que desatives manualmente essa opção nas definições. Nem o Lumo nem o DentroChat treinam alguma vez com as tuas conversas.
- Retenção após eliminação: Mesmo que elimines uma conversa ou uses o modo “Conversa temporária” do ChatGPT, a OpenAI mantém uma cópia nos seus servidores durante até 30 dias (explicámos todos os detalhes aqui).
- Exposição ao US CLOUD Act: Como a OpenAI detém as chaves de desencriptação das tuas conversas guardadas e é uma empresa norte-americana, as autoridades dos EUA podem exigir acesso ao abrigo do US CLOUD Act. Mesmo que o teu espaço de trabalho esteja configurado para residência de dados na UE!
| ChatGPT | Proton Lumo | DentroChat | |
|---|---|---|---|
| Encriptado em trânsito (TLS) | Sim | Sim | Sim |
| Encriptado em repouso | Sim (a OpenAI detém as chaves) | Sim (Zero-access, tu tens as chaves) | Sim (o DentroChat detém as chaves) |
| Encriptação de ponta a ponta durante a inferência de IA | Não (texto simples no servidor) | Não (texto simples no servidor, U2L) | Não (texto simples no servidor) |
| Treina modelos de IA com as tuas conversas | Sim, por defeito (opt-out) | Nunca | Nunca |
| Sujeito ao US CLOUD Act | Sim | Não para as conversas (EUA para faturação e suporte) | Não (stack 100% UE / suíça) |
Duas formas de obter uma encriptação de ponta a ponta (quase) verdadeira para IA
Então, será possível executar um LLM na cloud sem que o operador do servidor veja o teu prompt em texto simples? Existem duas abordagens para um E2EE adequado.
1. Encriptação homomórfica
A encriptação homomórfica é uma área de investigação fascinante. Permite realizar cálculos diretamente sobre dados encriptados.
Por exemplo: tu encriptas o número 12, e outro utilizador encripta o número 17. Os dois números encriptados são somados através de uma operação de adição encriptada. O resultado é o número encriptado 29, e apenas tu e o outro utilizador o podem desencriptar para descobrir que o resultado é 29. O servidor que fez a conta nunca soube que os números eram 12, 17 ou 29.
Este exemplo é simples, mas também pode funcionar para LLM. Nesse caso, introduzes dados encriptados no LLM, o LLM devolve uma resposta encriptada, e só o utilizador a pode desencriptar. Existe muita investigação académica relevante nesta área, como este artigo recente sobre inferência de LLM encriptada (Cachemir).
O problema da encriptação homomórfica é que é computacionalmente muito exigente e, por isso, muito lenta. Mesmo com as melhorias recentes, estamos a falar de cerca de 100 segundos de tempo de GPU por cada token gerado, o que significaria esperar 30 minutos por uma resposta simples a “Qual é a capital de Espanha?”
2. GPU NVIDIA H100/H200 com Confidential Computing (TEE)
A segunda abordagem é usar GPU NVIDIA H100/H200 com Confidential Computing e um Trusted Execution Environment (TEE).
Funciona assim: a GPU tem o seu próprio par de chaves privada e pública codificado diretamente no hardware. É criado uma única vez, quando a GPU é fabricada, e, depois de criado, o chave privada não pode ser obtido do exterior, nem sequer pela pessoa que é dona do bastidor do servidor.
Isto é ótimo, porque agora podes encriptar os teus dados com a chave pública da GPU e enviá-los para o servidor. A GPU desencripta-os dentro do seu próprio enclave de hardware usando a chave privada, entrega-os ao LLM que corre dentro da GPU, volta a encriptar a resposta e envia-a de volta para ti.
Assim, obtemos um E2EE quase verdadeiro. O único vetor de ataque de hardware que resta está na fase de fabrico: se a NSA tiver registado todas as chaves privadas enquanto estas GPU NVIDIA eram fabricadas na fábrica, poderia, teoricamente, intercetar e desencriptar mais tarde o tráfego quando a GPU estiver em funcionamento. No entanto, uma GPU NVIDIA com TEE é um pressuposto de segurança muito forte.
Tínhamos duas opções para o DentroChat: comprar nós próprios essas GPU ou encontrar um fornecedor europeu que as oferecesse. A primeira era demasiado cara para nós: uma única H100 custa cerca de 40.000 €, e para correr grandes modelos de pesos abertos como os que temos no DentroChat, precisaríamos de 8 delas. Como empresa autofinanciada, isso não era possível na altura. Encontrar um fornecedor europeu com GPU de confidential computing também não era possível há meio ano. No entanto, este é o caminho mais realista para o futuro, e estamos constantemente à procura de fornecedores europeus de infraestrutura de IA que o suportem.
Porque achamos que o DentroChat é uma boa escolha ao lado do Lumo
Mesmo sem encriptação zero-access no histórico guardado, há algumas razões pelas quais muitos utilizadores escolhem o DentroChat em vez do Lumo:
- Melhores modelos de IA: Da última vez que testámos o Lumo, a qualidade das respostas foi bastante fraca e lenta. Com o DentroChat tens acesso aos melhores modelos de código aberto e a um agent harness personalizado por baixo do capô.
- Zero subprocessadores norte-americanos em toda a stack: Tanto o Lumo como o DentroChat executam a inferência de IA em servidores europeus e suíços. No entanto, o Lumo continua a encaminhar a faturação e o apoio ao cliente através de empresas norte-americanas (como a Stripe e a Zendesk). No DentroChat não usamos subprocessadores norte-americanos em lado nenhum. Podes verificar toda a nossa stack na nossa página de subprocessadores.
Se quiseres comparar os dois em mais detalhe, consulta o nosso teste completo de alternativas ao Lumo, o nosso guia sobre chat de IA privado ou como se comparam as alternativas europeias ao ChatGPT. E se tiveres uma questão técnica como esta, não hesites em contactar-nos através do botão de feedback no DentroChat!
Perguntas frequentes
O ChatGPT é encriptado de ponta a ponta?
Não. A OpenAI encripta as tuas conversas em trânsito (TLS) e em repouso nos seus servidores, que é a base padrão para aplicações na cloud. Como o LLM precisa de texto simples para gerar uma resposta, os servidores da OpenAI desencriptam o teu prompt para o processar. A menos que estejas num plano empresarial ou faças opt-out explicitamente, as conversas dos utilizadores comuns também podem ser usadas para treinar modelos.
O Proton Lumo é encriptado de ponta a ponta?
Não de ponta a ponta. O Lumo usa aquilo a que a Proton chama encriptação User-to-Lumo (U2L): o teu histórico de conversas guardado está protegido com encriptação zero-access, para que a Proton não consiga ler as tuas conversas antigas, e o teu prompt fica encriptado até ao servidor de inferência. No entanto, o servidor de GPU da Proton ainda tem de desencriptar a tua mensagem na memória para a enviar ao LLM.
Como é que o DentroChat encripta as minhas conversas?
O DentroChat encripta todo o tráfego em trânsito com TLS e guarda as tuas conversas e ficheiros com encriptação em repouso gerida por nós, em servidores europeus na Alemanha e em França. Tal como o Lumo e o ChatGPT, os prompts têm de ser desencriptados na memória do servidor durante a inferência para que o modelo de IA possa responder, e nunca treinamos modelos com os teus dados.
Pode alguma vez uma conversa com IA ser verdadeiramente encriptada de ponta a ponta?
Sim, quer executando um modelo pequeno localmente no teu computador, quer na cloud com encriptação homomórfica ou GPU NVIDIA com Confidential Computing (TEE). Hoje, a encriptação homomórfica continua a ser demasiado lenta para um chat interativo, enquanto as GPU com confidential computing são o caminho mais promissor, assim que os fornecedores europeus de alojamento as disponibilizarem amplamente.