Ile energii zużywa prompt AI?
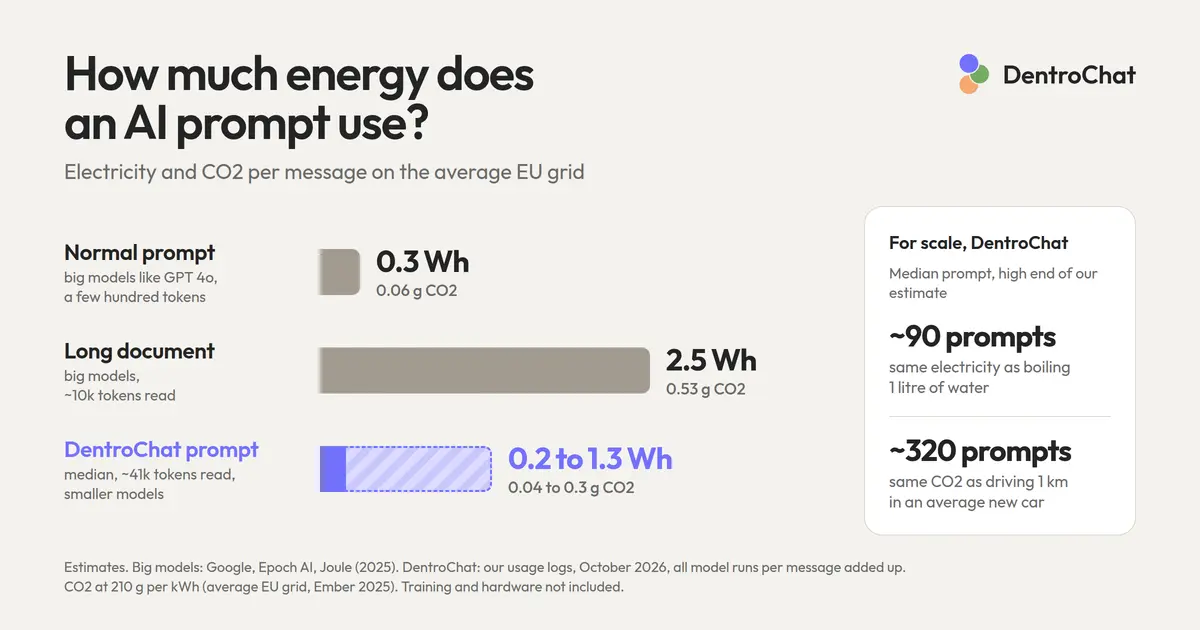
Użytkownicy DentroChat, naszego asystenta AI w UE, czasem pytają nas, ile prądu idzie na ich wiadomości. To rozsądne pytanie. Chętnie pokazalibyśmy ci liczbę w produkcie, ale firmy, które uruchamiają modele w chmurze, w większości nadal nie podają energii na pojedyncze żądanie. Dlatego zrobiliśmy, co mogliśmy, i oszacowaliśmy to na podstawie publicnych badań.
To nie są pomiary laboratoryjne DentroChat. Przejrzeliśmy studia, które udało nam się znaleźć, porównaliśmy je ze sobą, a liczby poniżej to punkt, w którym się zgadzają. Jeśli masz lepsze źródło, daj nam znać.
Prąd na zwykły prompt
Typowy prompt to: zadajesz pytanie, a model odpowiada kilkuset tokenami. Token to kawałek słowa albo całe słowo, jeśli jest krótkie.
Google to zmierzył. W maju 2025 mediana promptu tekstowego w aplikacjach Gemini wynosiła 0,24 Wh. Liczba obejmuje chip i chłodzenie całej hali w centrum danych. Google policzył, że dla mediany promptu CO2 to 0,03 g (przy mixie energetycznym Google).
Epoch AI oszacowało typową odpowiedź w ChatGPT w lutym 2025 na około 0,3 Wh, przy około 500 tokenach odpowiedzi. Sami uważają, że to szacunek nieco wysoki.
Artykuł w Joule z kwietnia 2026. Dane z wdrożeń z 2025. Mediana dla dużego modelu to 0,31 Wh. Sam Altman napisał w czerwcu 2025, że średnie zapytanie w ChatGPT to ~0,34 Wh.
Dla typowego promptu powiedzielibyśmy 0,3 Wh. Pomiar i szacunki wychodzą mniej więcej tak samo.
Prąd przy dłuższym prompcie
Długi dokument to więcej pracy, bo trzeba dużo przeczytać.
Epoch AI oszacowało, że około 10 tys. tokenów wejścia daje około 2,5 Wh na takie zapytanie. Żeby pokazać, ile to słów, policzyliśmy tokeny na własnych stronach. Liczby tutaj pochodzą z tokenizera GPT 4o: około 7700 angielskich słów i około 5800 niemieckich, czyli długi artykuł albo czat z wieloma wiadomościami. Niżej puszcziliśmy te same strony przez pięć innych tokenizerów, a tabela pokazuje, jak daleko od GPT 4o one stoją.
Jegham et al. zrobili własne oszacowanie dla promptu 10 tys. wejścia i 1500 wyjścia. Wyszło między ~1,4 a 2,9 Wh w zależności od modelu. Podobny rząd wielkości co u Epoch.
Jeśli model długo myśli i pisze tysiące tokenów, zanim pojawi się odpowiedź, zużywa się więcej prądu. W artykule w Joule odpowiedź około 5 tys. tokenów to ~4 Wh. To odpowiedź w stylu „reasoning”, gdzie model dużo liczy w głowie.
Oto wszystko w jednej tabeli. Chodzi o duże modele jak GPT 4o i Gemini:
| Rodzaj promptu | Tokeny, mniej więcej | Prąd | Skąd |
|---|---|---|---|
| Zwykły prompt | krótkie pytanie, kilkaset tokenów odpowiedzi | ~0,3 Wh | Google, Epoch AI, Joule, Altman |
| Długi dokument | ~10k wejścia, 500–1500 wyjścia | ~2,5 Wh (1,4–2,9) | Epoch AI, Jegham et al. |
| Odpowiedź reasoning | ~5k wyjścia | ~4 Wh | Joule |
Krótko: zwykły prompt to około 0,3 Wh. Długi dokument około 10 tys. tokenów to około 2,5 Wh, między 1,4 a 2,9 w zależności od modelu. Długa odpowiedź reasoning około 5 tys. tokenów to około 4 Wh.
CO2 zależy od sieci
Prąd na ten sam model jest mniej więcej taki sam, gdzie stoją serwery. CO2 zależy od lokalnej sieci energetycznej.
Wzięliśmy liczby Ember z 2025, widoczne w „Our World in Data”. To wartości cyklu życia: liczą łańcuch dostaw energii oprócz emisji elektrowni. Mierzone w gramach ekwiwalentu CO2 na kilowatogodzinę.
Pomnożyliśmy to przez nasze dwie liczby: 0,3 Wh na zwykły prompt i 2,5 Wh na długi dokument:
| Sieć | g CO2e na kWh | Zwykły prompt | Długi dokument |
|---|---|---|---|
| Norwegia | 28 | 0,01 g | 0,07 g |
| Szwecja | 35 | 0,01 g | 0,09 g |
| Francja | 41 | 0,01 g | 0,10 g |
| Finlandia | 57 | 0,02 g | 0,14 g |
| Dania | 114 | 0,03 g | 0,29 g |
| Austria | 117 | 0,04 g | 0,29 g |
| Hiszpania | 154 | 0,05 g | 0,38 g |
| Średnia UE | 210 | 0,06 g | 0,53 g |
| Holandia | 254 | 0,08 g | 0,63 g |
| Włochy | 285 | 0,09 g | 0,71 g |
| Estonia | 319 | 0,10 g | 0,80 g |
| Niemcy | 330 | 0,10 g | 0,82 g |
| Stany Zjednoczone | 384 | 0,12 g | 0,96 g |
| Polska | 589 | 0,18 g | 1,47 g |
Krótko: w Szwecji (35 g na kWh) i we Francji (41 g) zwykły prompt to około 0,01 g CO2, a długi dokument około 0,1 g. Przy średniej UE (210 g) to 0,06 g i około 0,5 g. W Niemczech (330 g) około 0,1 g i około 0,8 g. Polska ma najwyższą wartość w tabeli, 589 g, więc zwykły prompt to około 0,18 g, a długi dokument około 1,5 g. USA są w tabeli, bo wiele liczb ChatGPT powstało tam. Przy 384 g to około 0,12 g na zwykły prompt i około 1 g na długi dokument.
W Niemczech agencja środowiskowa mówi podobnie na 2025: 344 g CO2 z wytwarzania i 406 g ekwiwalentu CO2 z łańcuchem dostaw. Electricity Maps podaje faktyczne zużycie prądu przez ludzi w Niemczech na 335 g w 2025. Pojedyncze godziny mogą być od ~100 g do ~600 g.
A DentroChat?
Dotąd liczyły się duże modele jak GPT 4o. Epoch zakładał około 100 miliardów parametrów na każdy token, ale DentroChat często używa mniejszych modeli. To modele „mixture of experts”: model jest duży, ale na każdy token pracuje tylko mała część. DeepSeek V4 Flash używa około 13 miliardów parametrów na token, GLM 5.3 Flash około 18 miliardów, a Qwen 3.8 Flash Next około 6 miliardów.
Mniej aktywnych parametrów to mniej prądu na token i mniej CO2 na token. Ranking ML.ENERGY zmierzył to na swoich GPU. Model Qwen z 22 miliardami aktywnych parametrów potrzebował około 0,12 Wh na 1000 napisanych tokenów. DeepSeek V3.1 z 37 miliardami około 0,37 Wh. To tylko karty graficzne, więc dodaliśmy chłodzenie i resztę serwerów. Nasze modele są mniejsze niż oba, stąd nasze oszacowanie:
| Na 1000 tokenów | Aktywne parametry na token | Napisane | Odczyt, świeże | Odczyt, w cache | CO2 na 1000 napisanych, średnia UE |
|---|---|---|---|---|---|
| GPT 4o (założenie Epoch) | ~100 mld | ~0,6 Wh | ~0,2 Wh | ~0,13 g | |
| Modele DentroChat (nasze oszacowanie) | 6–18 mld | 0,05–0,4 Wh | 0,01–0,07 Wh | 0,001–0,007 Wh | 0,01–0,08 g |
Krótko: dla GPT 4o liczby Epoch dają około 0,6 Wh na każde 1000 tokenów, które model napisze, i około 0,2 na każde 1000 odczytanych. Dla modeli w DentroChat szacujemy 0,05–0,4 Wh na 1000 napisanych i 0,01–0,07 na 1000 odczytanych. Jeśli tekst był odczytany kilka minut wcześniej, trafia do cache i kosztuje mniej więcej dziesiątą tego. W średniej sieci UE 1000 napisanych tokenów to około 0,13 g CO2 dla GPT 4o i 0,01–0,08 g dla naszych modeli.
Nasze prompty są jednak większe niż „zwykły prompt” w badaniach. Każda wiadomość wysyła modelowi instrukcje i opisy narzędzi, to już około 3 tys. tokenów. Do tego dochodzi twoja pamięć, dotychczasowy czat oraz pliki albo wyniki wyszukiwania. Gdy model używa narzędzia, czyta wszystko jeszcze raz. Na przykład najpierw decyduje się wyszukać w sieci, potem czyta cały czat razem z wynikami, żeby napisać odpowiedź. Jedna twoja wiadomość może więc oznaczać kilka uruchomień modelu.
Wszystkie liczby w tabeli poniżej dotyczą jednej wiadomości, którą wysyłasz. Jeśli jedna wiadomość uruchomiła model kilka razy, zsumowaliśmy te przebiegi w jednym wierszu.
Spojrzeliśmy więc w własne logi użycia i policzyliśmy tokeny (tego, co piszesz, oczywiście nie czytamy). Tabela opiera się na 606 promptach z jednego dnia w październiku 2026. Sprawdziliśmy też 21 700 promptów z 30 dni wcześniej, mediana była bardzo podobna:
| Prompt DentroChat | Odczytane | w tym w cache | Napisane | Prąd (nasze oszacowanie) | CO2, średnia UE | CO2, Niemcy |
|---|---|---|---|---|---|---|
| Mediana | ~41k | ~30k | ~900 | 0,2–1,3 Wh | 0,04–0,3 g | 0,06–0,4 g |
| Górne 10% | ~131k | ~66k | ~4600 | 1–7 Wh | 0,2–1,4 g | 0,3–2,3 g |
Krótko: mediana promptu DentroChat czyta około 41 tys. tokenów, z czego około 30 tys. jest w cache, bo wysłano je kilka minut wcześniej. Pisze około 900 tokenów. Szacujemy to na 0,2–1,3 Wh, czyli około 0,04–0,3 g CO2 w średniej sieci UE i 0,06–0,4 g w Niemczech. Górne 10% czyta 131 tys. tokenów lub więcej i pisze 4600 lub więcej. To około 1–7 Wh, czyli 0,2–1,4 g CO2 w średniej UE i 0,3–2,3 g w Niemczech.
W wierszu „Górne 10%” wzięliśmy dla każdej kolumny osobno linię percentylową. Prawdziwy prompt rzadko trafia we wszystkie naraz, więc wiersz celowo jest po ciężkiej stronie.
Jest też praca w tle, np. aktualizacja pamięci i streszczanie długich czatów. Czasem model jest za wolny i w połowie przechodzimy na zapasowy. Tych przebiegów nie ma w tabeli. Rozłożone na wszystkie prompty, średni prompt czyta około 76 tys. tokenów (50 tys. w cache) i pisze około 2 tys., czyli około 0,4–3 Wh.
Prompt DentroChat czyta więc dużo więcej niż zwykły prompt z badań. Każdy token jest tańszy. Mediana promptu DentroChat (0,2–1,3 Wh) na dole jest blisko zwykłego promptu dużych modeli (0,3 Wh), a na górze około połowy ich długiego dokumentu (2,5 Wh).
Dla porównania: czajnik i krótki przejazd
Żeby podgrzać litr wody z kranu do wrzenia, trzeba mniej więcej 100 Wh ciepła. Część nie trafia do wody, więc z gniazdka to raczej 110–125 Wh.
Mediana promptu DentroChat to mały ułamek tego. Bierzemy górną granicę naszego oszacowania, 1,3 Wh, żeby porównanie było po ciężkiej stronie. W takim tempie potrzebujesz około 90 promptów DentroChat na litr.
Do samochodu bierzemy średnią dla nowych aut w 2025 od Europejskiej Agencji Środowiska: 96,7 g CO2 na km według testów laboratoryjnych. Średnia obejmuje też elektryki, które liczą się jako zero spalin, więc benzyna na drodze zużywa trochę więcej.
Na każdy kilometr w takim przeciętnym nowym aucie możesz w Niemczech wysłać około 240 medianowych promptów DentroChat. Znowu górna granica: 0,4 g CO2 na prompt. W średniej sieci UE ten sam prompt to 0,3 g CO2, czyli około 320 promptów na kilometr.
Język a liczba tokenów
Różne języki rozbijają tę samą stronę na różną liczbę tokenów. Puściliśmy własne artykuły przez tokenizery dla wszystkich 17 języków, które obsługuje DentroChat.
Użyliśmy 22 postów blogowych, które są w każdym języku, więc za każdym razem ten sam tekst. Główna liczba pochodzi z tokenizera GPT 4o. Zakres to minimum i maksimum z sześciu tokenizerów (GPT 4o, GPT 4, Mistral, Llama 3, Qwen 2.5 i DeepSeek V3).
| Język | Tokeny na słowo | Zakres | Słowa w 10k tokenach |
|---|---|---|---|
| angielski | 1,3 | 1,3–1,4 | ~7700 |
| hiszpański | 1,4 | 1,4–1,7 | ~7200 |
| portugalski | 1,4 | 1,4–1,7 | ~7000 |
| francuski | 1,4 | 1,4–1,7 | ~6900 |
| niderlandzki | 1,6 | 1,6–2,1 | ~6300 |
| włoski | 1,7 | 1,7–1,9 | ~6000 |
| niemiecki | 1,7 | 1,7–2,1 | ~5800 |
| norweski | 1,9 | 1,9–2,2 | ~5400 |
| szwedzki | 1,9 | 1,9–2,3 | ~5300 |
| duński | 1,9 | 1,9–2,3 | ~5300 |
| rumuński | 1,9 | 1,9–2,2 | ~5300 |
| chorwacki | 2,1 | 2,1–2,6 | ~4800 |
| polski | 2,2 | 2,2–2,6 | ~4500 |
| grecki | 2,4 | 2,4–5,9 | ~4200 |
| estoński | 2,5 | 2,5–3,1 | ~4000 |
| węgierski | 2,6 | 2,5–3,1 | ~3900 |
| fiński | 2,8 | 2,8–3,5 | ~3600 |
Krótko: w tokenizerze GPT 4o angielski to około 1,3 tokena na słowo, więc 10 tys. tokenów to około 7700 angielskich słów. Hiszpański, portugalski i francuski tuż za nim, około 1,4. Niderlandzki około 1,6, niemiecki i włoski około 1,7, czyli 10 tys. tokenów to około 5800 niemieckich słów. Języki nordyckie oprócz fińskiego około 1,9. Estoński około 2,5, fiński najwyżej, około 2,8, więc 10 tys. tokenów to tylko około 3600 fińskich słów.
Często mówi się, że niemieckie słowo to 3 tokeny. Na nowoczesnych tokenizerach mierzymy raczej 2. Grecki ma duży zakres, bo starsze tokenizery źle radzą sobie z alfabetem greckim.
Dokument po fińsku tej samej długości zużywa więc więcej tokenów, a więc więcej prądu. Gramy CO2 na Wh z sieci zostają jak wyżej.
Czego nie uwzględniliśmy
Tu chodzi o prąd na jedną odpowiedź na jedną wiadomość.
Trening modelu był wcześniej, jednorazowo, i dzielą go wszyscy użytkownicy. Przypisanie kosztu treningu do twojego promptu to zgadywanie, więc tego nie liczymy.
Jest też koszt produkcji kart graficznych. Rozbicie Nvidii dla jednej płyty H100: 1312 kg ekwiwalentu CO2 na 8 GPU. To na kilka lat pracy. Na jeden prompt przypada tylko mały ułamek, wyraźnie poniżej 1 g. W czystej sieci jak Szwecja ten ułamek może zbliżyć się do CO2 z samego prądu. W niemieckiej sieci prąd dominuje.
Jest jeszcze woda. Wiralowe twierdzenie, że AI wypija butelkę wody, pochodzi z oszacowania z 2023 dla GPT 3: około 500 ml na 20–50 odpowiedzi, w gorących amerykańskich centrach danych chłodzonych parowaniem. Google zmierzył 0,26 ml na medianę promptu tekstowego Gemini (~pięć kropli wody). Wiele europejskich centrów chłodzi powietrzem z zewnątrz i prawie nie zużywa wody!! Dotyczy to Hetznera w Niemczech, gdzie hostowany jest DentroChat, i szwedzkich centrów, gdzie działają część naszych modeli. Więcej w Czy AI marnuje wodę? i dokładniej w Zużycie wody przez AI: Dlaczego wiralowe liczby wprowadzają w błąd.
Jest też praktyczna sprawa. W tym samym czacie długi dokument zwykle trzyma się w pamięci kilka minut. Następna wiadomość przetwarza głównie nowy tekst. OpenAI i Anthropic opisują cache wygasający po około 5–10 minutach bez aktywności. To kolumna „w cache” w naszej tabeli DentroChat. Pomaga też, gdy model uruchamia się kilka razy na jedną wiadomość, bo drugi przebieg może użyć tego, co pierwszy już odczytał.
Nadal chcielibyśmy pokazać ci prawdziwą liczbę watogodzin na każdą wiadomość w DentroChat, najlepszym EU AI Chat. Musieliby nam podać energię każdego żądania dostawcy modeli, a większość tego jeszcze nie robi.
Na razie to nasze najlepsze przybliżenie. Na dużych modelach jak GPT 4o zwykły prompt to około 0,3 Wh, a długi dokument około 2,5. Mediana promptu DentroChat na naszych mniejszych modelach to około 0,2–1,3 Wh. W średniej sieci UE to co najwyżej około 0,3 g CO2.