Hvor mye energi bruker en AI-prompt?
Brukere av DentroChat, vår EU AI-assistent, spør oss av og til hvor mye strøm som går med til meldingene deres. Det er et fair spørsmål. Vi skulle gjerne vist et tall i produktet, men de som kjører modellene i skyen oppgir energien per request stort sett fortsatt ikke. Derfor har vi gjort vårt beste for å anslå det ut fra offentlig forskning.
Dette er ikke labmålinger av DentroChat. Vi har lest studiene vi fant, holdt dem opp mot hverandre, og tallene under er der de lander. Kjenner du en bedre kilde, si fra.
Strøm til en normal prompt
Typisk stiller du et spørsmål og får et svar på et par hundre tokens. Et token er en del av et ord, eller ved korte ord noen ganger et helt ord.
Google har målt det. I mai 2025 var median tekstprompt i Gemini-appene 0,24 wattime. Det inkluderte chip og kjøling for hele hallen i datasenteret. For median prompt regnet Google med 0,03 gram CO2 (for Googles strøm).
Epoch AI estimerte i februar 2025 et typisk ChatGPT-svar til omtrent 0,3 wattime, ut fra rundt 500 tokens svar. De sier selv at estimatet ligger litt høyt.
I april 2026 kom en artikkel i Joule med data fra 2025-deployments. De estimerte medianen for en stor modell til 0,31 wattime. Sam Altman skrev i juni 2025 at en gjennomsnittlig ChatGPT-forespørsel er omtrent 0,34 wattime.
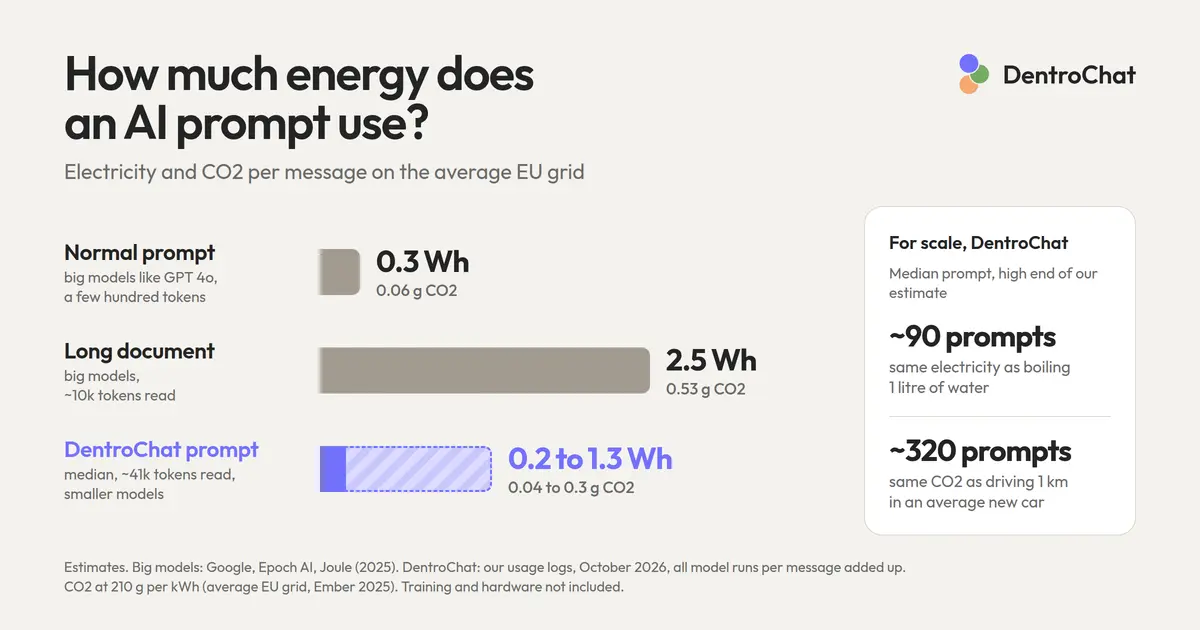
For en typisk prompt ville vi sagt 0,3 wattime. Måling og estimater ender omtrent på samme sted.
Strøm til en lengre prompt
Et langt dokument er mer jobb, fordi mye må leses.
Epoch AI estimerte at omtrent 10k tokens input gir omtrent 2,5 wattime for en slik forespørsel. For å vise hva det er i ord, har vi talt tokens på våre egne sider. Tallene her bruker GPT-4o-tokenizeren: omtrent 7.700 engelske ord og omtrent 5.800 tyske ord, altså en lang artikkel eller en chat med mange meldinger. Lenger ned har vi kjørt de samme sidene gjennom fem andre tokenizers, og den tabellen viser hvor langt de er fra GPT-4o.
Jegham et al. laget sitt eget estimat for en slik prompt med 10k inn og 1.500 ut. Det ble mellom omtrent 1,4 og 2,9 wattime avhengig av modellen, altså samme størrelsesorden som Epoch.
Tenker modellen lenge og skriver tusenvis av tokens før svaret kommer, brukes det mer strøm. I Joule-artikkelen ligger et svar på omtrent 5k tokens omtrent 4 wattime. Det er et reasoning-svar der modellen regner mye.
Her er alt i én tabell. Det gjelder store modeller som GPT-4o og Gemini:
| Type prompt | Tokens, grovt | Strøm | Kilde |
|---|---|---|---|
| Normal prompt | kort spørsmål, et par hundre tokens tilbake | ~0,3 Wh | Google, Epoch AI, Joule-artikkel, Altman |
| Langt dokument | ~10k inn, 500 til 1.500 ut | ~2,5 Wh (1,4 til 2,9) | Epoch AI, Jegham et al. |
| Reasoning-svar | ~5k ut | ~4 Wh | Joule-artikkel |
Kort fortalt: en normal prompt bruker omtrent 0,3 wattime. Et langt dokument på omtrent 10k tokens bruker omtrent 2,5 wattime, et sted mellom 1,4 og 2,9 avhengig av modellen. Et langt reasoning-svar på omtrent 5k tokens bruker omtrent 4 wattime.
CO2 avhenger av nettet
Strømmen til samme modell er omtrent den samme uansett hvor serverne står. Men CO2 avhenger av det lokale strømnettet.
Vi tok tallene fra Ember, 2025, som du finner hos Our World in Data. Det er livsløpstall. De inkluderer forsyningskjeden på toppen av kraftverkets utslipp, målt i gram CO2-ekvivalent per kilowattime.
Med dem multipliserte vi våre to tall: 0,3 Wh for en normal prompt og 2,5 Wh for et langt dokument:
| Nett | g CO2e per kWh | Normal prompt | Langt dokument |
|---|---|---|---|
| Norge | 28 | 0,01 g | 0,07 g |
| Sverige | 35 | 0,01 g | 0,09 g |
| Frankrike | 41 | 0,01 g | 0,10 g |
| Finland | 57 | 0,02 g | 0,14 g |
| Danmark | 114 | 0,03 g | 0,29 g |
| Østerrike | 117 | 0,04 g | 0,29 g |
| Spania | 154 | 0,05 g | 0,38 g |
| EU-gjennomsnitt | 210 | 0,06 g | 0,53 g |
| Nederland | 254 | 0,08 g | 0,63 g |
| Italia | 285 | 0,09 g | 0,71 g |
| Estland | 319 | 0,10 g | 0,80 g |
| Tyskland | 330 | 0,10 g | 0,82 g |
| USA | 384 | 0,12 g | 0,96 g |
| Polen | 589 | 0,18 g | 1,47 g |
Kort fortalt: i Sverige (35 g per kWh) og Frankrike (41 g) koster en normal prompt omtrent 0,01 gram CO2 og et langt dokument omtrent 0,1 gram. På EU-gjennomsnittet (210 g) er en normal prompt omtrent 0,06 gram og et langt dokument omtrent 0,5 gram. I Tyskland (330 g) omtrent 0,1 gram og 0,8 gram. Polen har med 589 g høyest verdi i tabellen, omtrent 0,18 gram for en normal prompt og omtrent 1,5 gram for et langt dokument. USA er med fordi mange ChatGPT-tall kommer derfra; ved 384 g er det omtrent 0,12 gram for en normal prompt og omtrent 1 gram for et langt dokument.
I Tyskland sier miljøbyrået noe lignende for 2025: 344 g CO2 per kilowattime fra produksjon og 406 g CO2-ekvivalent med forsyningskjede. Electricity Maps setter faktisk strømforbruk i Tyskland i 2025 til 335 g, der enkelttimer kan svinge mellom omtrent 100 g og 600 g.
Hva med DentroChat?
Alle tall så langt gjelder store modeller som GPT-4o. Epoch antok at omtrent 100 milliarder parametre jobber på hvert token, men DentroChat bruker ofte mindre modeller. Det er mixture-of-experts-modeller: modellen er stor, men bare en liten del jobber per token. DeepSeek V4 Flash bruker omtrent 13 milliarder parametre per token, GLM 5.3 Flash omtrent 18 milliarder og Qwen 3.8 Flash Next omtrent 6 milliarder.
Færre aktive parametre betyr mindre strøm per token og dermed mindre CO2 per token. ML.ENERGY-leaderboardet har målt det på ekte GPU-er. En Qwen-modell med 22 milliarder aktive parametre trengte omtrent 0,12 Wh per 1.000 skrevne tokens. DeepSeek V3.1 med 37 milliarder omtrent 0,37 Wh. Det er bare grafikkortene, så vi la kjøling og resten av serverne på toppen. Modellene våre er mindre enn begge, så dette er estimatet vårt:
| Per 1.000 tokens | Aktive parametre per token | Skrevet | Lest, fersk | Lest, cachet | CO2 per 1.000 skrevet, EU-gjennomsnitt |
|---|---|---|---|---|---|
| GPT-4o (Epochs antagelse) | ~100 mrd | ~0,6 Wh | ~0,2 Wh | ~0,13 g | |
| DentroChat-modeller (vårt estimat) | 6 til 18 mrd | 0,05 til 0,4 Wh | 0,01 til 0,07 Wh | 0,001 til 0,007 Wh | 0,01 til 0,08 g |
Kort fortalt: for GPT-4o gir Epochs tall omtrent 0,6 wattime per 1.000 tokens modellen skriver, og omtrent 0,2 per 1.000 tokens den leser. For modellene i DentroChat estimerer vi 0,05 til 0,4 wattime per 1.000 skrevne tokens og 0,01 til 0,07 per 1.000 leste tokens. Ble teksten lest for et par minutter siden, ligger den i cache, og da koster det omtrent en tiendedel igjen. På EU-gjennomsnittsnettet er 1.000 skrevne tokens omtrent 0,13 gram CO2 for GPT-4o og 0,01 til 0,08 gram for modellene våre.
Promptene våre er større enn «normal prompt» i studiene. Hver melding sender også modellens instruksjoner og tool-beskrivelser med, allerede omtrent 3k tokens. I tillegg kommer minnet ditt, chatten så langt, og eventuelle filer eller websøkeresultater. Bruker modellen et tool, leser den alt på nytt. Den kan først bestemme seg for å søke på nettet og deretter lese hele chatten pluss søkeresultater for å skrive svaret. Én melding fra deg kan bety flere modelkjøringer.
Alle tall i tabellen under er per melding du sender. Har én melding fått modellen til å kjøre flere ganger, har vi summert kjøringene i én rad.
Vi så i bruksloggene våre og telte tokens (det du skriver leser vi selvfølgelig ikke). Tabellen bruker 606 prompts fra én dag i oktober 2026. Vi sjekket også de 21.700 promptene de 30 dagene før, og medianen var veldig lik:
| DentroChat-prompt | Lest | derav cachet | Skrevet | Strøm (vårt estimat) | CO2, EU-gjennomsnitt | CO2, Tyskland |
|---|---|---|---|---|---|---|
| Median | ~41k | ~30k | ~900 | 0,2 til 1,3 Wh | 0,04 til 0,3 g | 0,06 til 0,4 g |
| Øverste 10 % | ~131k | ~66k | ~4.600 | 1 til 7 Wh | 0,2 til 1,4 g | 0,3 til 2,3 g |
Kort fortalt: median DentroChat-prompt leser omtrent 41k tokens, hvorav omtrent 30k er cachet fordi de ble sendt noen minutter før. Den skriver omtrent 900 tokens. Vi estimerer det til 0,2 til 1,3 wattime, omtrent 0,04 til 0,3 gram CO2 på EU-gjennomsnittsnettet og 0,06 til 0,4 gram i Tyskland. Øverste 10 % leser 131k tokens eller mer og skriver 4.600 eller mer. Det er omtrent 1 til 7 wattime, eller 0,2 til 1,4 gram CO2 på EU-gjennomsnittet og 0,3 til 2,3 gram i Tyskland.
For raden «Øverste 10 %» tok vi percentilverdien per kolonne for seg. En ekte prompt treffer sjelden alle kolonner samtidig, så raden er med vilje på den tunge siden.
Det er også arbeid i bakgrunnen, som å oppdatere minnet ditt og oppsummere lange chatter. Noen ganger er en modell for treg, og vi bytter midt i et svar til en backup-modell. De kjøringene er ikke i tabellen. Fordeler du dem over alle prompts, leser gjennomsnittsprompten omtrent 76k tokens (50k cachet) og skriver omtrent 2k. Det lander omtrent 0,4 til 3 wattime.
En DentroChat-prompt leser altså mye mer enn normal prompt i studiene. Per token er den billigere. Medianen (0,2 til 1,3 Wh) ligger nederst nær 0,3 Wh for store modeller og øverst omtrent halvparten av deres lange dokument på 2,5 Wh.
Til sammenligning: vannkoker og kort kjøretur
Det tar grovt 100 wattime varme å varme en liter vann fra springen til koking. Noe når ikke vannet, så i stikkontakten er det mer som 110 til 125 wattime.
En median DentroChat-prompt er en liten del av det. Vi bruker den høye enden av estimatet vårt, 1,3 wattime, så sammenligningen blir på den tunge siden. Da trenger du omtrent 90 DentroChat-prompter for én liter.
For bilen tar vi gjennomsnittet for nye biler i 2025 fra Det europeiske miljøbyrået: 96,7 g CO2 per kilometer ifølge labtest. Gjennomsnittet inkluderer elbiler som teller som null utslipp, så en bensinbil på veien bruker sannsynligvis litt mer.
Per kilometer i en slik gjennomsnittlig ny bil kunne du sendt omtrent 240 median DentroChat-prompter i Tyskland. Igjen den tunge siden: 0,4 gram CO2 per prompt. På EU-gjennomsnittsnettet er samme prompt 0,3 gram, altså omtrent 320 prompts per kilometer.
Språk påvirker antall tokens
Ulike språk tokeniserer samme side i ulikt mange tokens. Vi kjørte artiklene våre gjennom tokenizers for alle 17 språk DentroChat støtter.
Vi brukte 22 blogginnlegg som finnes på hvert språk, altså samme tekst hver gang. Hovedtallet kommer fra GPT-4o-tokenizeren. Spennet er laveste og høyeste på tvers av seks tokenizers (GPT-4o, GPT-4, Mistral, Llama 3, Qwen 2.5 og DeepSeek V3).
| Språk | Tokens per ord | Spenn | Ord i 10k tokens |
|---|---|---|---|
| Engelsk | 1,3 | 1,3 til 1,4 | ~7.700 |
| Spansk | 1,4 | 1,4 til 1,7 | ~7.200 |
| Portugisisk | 1,4 | 1,4 til 1,7 | ~7.000 |
| Fransk | 1,4 | 1,4 til 1,7 | ~6.900 |
| Nederlandsk | 1,6 | 1,6 til 2,1 | ~6.300 |
| Italiensk | 1,7 | 1,7 til 1,9 | ~6.000 |
| Tysk | 1,7 | 1,7 til 2,1 | ~5.800 |
| Norsk | 1,9 | 1,9 til 2,2 | ~5.400 |
| Svensk | 1,9 | 1,9 til 2,3 | ~5.300 |
| Dansk | 1,9 | 1,9 til 2,3 | ~5.300 |
| Rumensk | 1,9 | 1,9 til 2,2 | ~5.300 |
| Kroatisk | 2,1 | 2,1 til 2,6 | ~4.800 |
| Polsk | 2,2 | 2,2 til 2,6 | ~4.500 |
| Gresk | 2,4 | 2,4 til 5,9 | ~4.200 |
| Estisk | 2,5 | 2,5 til 3,1 | ~4.000 |
| Ungarsk | 2,6 | 2,5 til 3,1 | ~3.900 |
| Finsk | 2,8 | 2,8 til 3,5 | ~3.600 |
Kort fortalt: på GPT-4o-tokenizeren er engelsk omtrent 1,3 tokens per ord, så 10k tokens er omtrent 7.700 engelske ord. Spansk, portugisisk og fransk ligger rett bak med omtrent 1,4. Nederlandsk omtrent 1,6, tysk og italiensk omtrent 1,7, så 10k tokens er omtrent 5.800 tyske ord. De nordiske språkene unntatt finsk ligger omtrent 1,9. Estisk omtrent 2,5 og finsk høyest med omtrent 2,8, så 10k tokens er bare omtrent 3.600 finske ord.
Ofte hører man at et tysk ord er tre tokens. På moderne tokenizers måler vi heller to. Gresk har det store spennet fordi eldre tokenizers håndterer det greske alfabetet dårlig.
Et finsk dokument av samme lengde bruker altså flere tokens og dermed mer strøm. Gram CO2 per Wh følger nettet over.
Det vi ikke har tatt med
Dette handler om strømmen til ett svar på én melding.
Modelltrening skjedde tidligere én gang og deles mellom alle som bruker modellen. Å fordele treningskostnaden på prompten din ville vært gjetning, så den er ute.
Så kommer kostnaden ved å lage grafikkort. Nvidias oversikt for ett H100-kort: 1312 kg CO2-ekvivalent for 8 GPU-er over noen års drift. For én prompt bærer du bare en liten brøkdel, klart under 1 g. På et rent nett som Sverige kan den brøkdelen nærme seg CO2 fra selve strømmen. På det tyske nettet er strømmen mye større.
Og vann. Den virale påstanden om at AI drikker en vannflaske kommer fra et 2023-estimat for GPT-3: omtrent 500 ml til 20 til 50 svar, i varme amerikanske datasentre som kjøler ved fordamping. Google målte 0,26 ml for median Gemini-tekstprompt (omtrent fem dråper). Mange europeiske datasentre kjøler med uteluft og bruker nesten ikke vann, inkludert Hetzner i Tyskland der DentroChat hostes, og de svenske datasentrene der en del av modellene våre kjører. Mer i Sløser AI vann? og mer detaljert i AI’s vannforbruk: hvorfor virale tall er misvisende.
Det er også det praktiske: blir du i samme chat, ligger det lange dokumentet som regel noen minutter i minnet, så neste melding mest behandler den nye teksten. OpenAI og Anthropic beskriver cacher som utløper etter omtrent 5 til 10 minutter uten aktivitet. Det er kolonnen «cachet» i DentroChat-tabellen vår. Det hjelper også når modellen kjører flere ganger for én melding, fordi andre kjøring kan gjenbruke det den første allerede leste.
Vi skulle gjerne vist deg et ekte wattimetall for hver melding i DentroChat, den beste EU AI-chatten. For det må de som kjører modellene oppgi energien per request, og de fleste gjør det ikke ennå.
Inntil da er dette vårt beste estimat. På store modeller som GPT-4o bruker en normal prompt omtrent 0,3 wattime og et langt dokument omtrent 2,5. En median DentroChat-prompt på våre mindre modeller bruker omtrent 0,2 til 1,3 wattime. På EU-gjennomsnittsnettet er det maks omtrent 0,3 gram CO2.