Is je AI-chat versleuteld? ChatGPT, Lumo en DentroChat
Een tijdje geleden stuurde een DentroChat-gebruiker ons een vraag:
Lumo zegt dat het alle gesprekken versleutelt. Doet DentroChat hetzelfde, of hebben jullie een andere aanpak?
Die vraag zette me aan het denken, want ik heb destijds mijn bachelorscriptie over cryptografie geschreven, en ik wilde mijn gedachten eindelijk eens goed opschrijven. Mijn antwoord werd nogal lang en technisch. Als het je te dicht wordt, kun je dit artikel misschien het best in Lumo of DentroChat plakken en een AI het in eenvoudigere woorden laten uitleggen :-)
Om goed uit te leggen hoe versleutelde AI-chat werkt, kijken we eerst naar de versleuteling van Proton, dan naar Lumo, en daarna naar hoe DentroChat en ChatGPT het aanpakken.
Hoe de zero-knowledge-versleuteling van Proton werkt
We zijn grote fans van het Proton-ecosysteem en gebruiken het al jaren actief voor VPN, e-mail, videobellen en meer.
Het grote voordeel van Proton is de zero-knowledge-opzet. Publieke-privésleutelparen worden afgeleid van je accountwachtwoord en zijn per gebruiker uniek. De privésleutel wordt gebruikt om onze e-mails, Drive-bestanden en andere gegevens te versleutelen. Alleen de gebruiker, dus wij, kan onze eigen gegevens op ons lokale apparaat ontsleutelen. Medewerkers van Proton kunnen onze gegevens niet ontsleutelen, omdat ze nooit toegang krijgen tot onze privésleutel.
Het voordeel is dat zelfs als de NSA zich op een Proton-server verschuilt, ze onze gegevens niet kunnen bemachtigen (althans zolang alle andere veiligheidsaannames standhouden). Het nadeel is dat als we ooit ons Proton-wachtwoord en de back-upcodes kwijtraken en er geen herstelmethode is ingesteld, Proton onze gegevens niet kan herstellen.
Als je vanaf nul wilt begrijpen hoe publieke-privésleutelversleuteling werkt, is deze YouTube-video over publieke-sleutelcryptografie geweldig. Toen ik hem in mijn eerste jaar aan de universiteit bekeek, blies hij mijn hoofd echt weg!
Lumo: waarom een LLM het plaatje verandert
Lumo verschilt op een fundamentele manier van de andere Proton-diensten, vanwege de manier waarop grote taalmodellen (LLM’s) werken. Om een antwoord van een AI- of LLM-model te krijgen, moet je de invoer in platte tekst aan het model geven, dus ontsleuteld. (Er zijn manieren om dit op een meer versleutelde manier te doen, daar kom ik hieronder op terug.)
Als je een LLM lokaal op je eigen computer zou draaien, zou de klassieke Proton-aanpak hierboven nog steeds werken: je ontsleutelt de gegevens lokaal op je apparaat, voert ze in je lokale LLM, krijgt een antwoord en versleutelt de gegevens daarna weer lokaal. Zo werkt het wanneer je lokale modellen draait met tools zoals Ollama.
Het probleem is dat de beste LLM’s zeer krachtige machines nodig hebben, en dat is op een gewone consumentencomputer simpelweg niet haalbaar. Daarom moet de LLM op een Proton-server draaien, en moeten je gegevens worden ontsleuteld voordat ze in de LLM van Proton worden gevoerd.
Wat er gebeurt als je Lumo een bericht stuurt
Als je Lumo gebruikt, werkt het zo (zoals beschreven in het beveiligingsmodel van Lumo van Proton):
- Je ontsleutelt je chatgeschiedenis lokaal op je apparaat.
- Je voegt een nieuw gebruikersbericht toe.
- De volledige berichtgeschiedenis, samen met je nieuwe bericht, wordt versleuteld met de publieke sleutel van de Proton-server waarop de LLM draait.
- Je versleutelde gegevens komen aan bij de Proton-server en worden ontsleuteld met de privésleutel van die server. De ontsleutelde gegevens worden in de LLM gevoerd, en er wordt een antwoord gegenereerd.
- Het gegenereerde antwoord wordt opnieuw versleuteld en naar jou teruggestuurd.
- Je ontsleutelt het op je apparaat en leest het antwoord.
Gezien de beperkingen is dit een zeer solide aanpak.
Alleen: tijdens de inferentie is de aanpak niet langer zero-knowledge. Als de Zwitserse politie, de NSA of een kwaadwillende medewerker van Proton meeluistert op de Proton-server waar je gegevens worden ontsleuteld voordat ze in de LLM gaan, kunnen ze je gegevens lezen. Lumo gebruikt geen End-to-End Encryption (E2EE) zoals de andere Proton-diensten, maar iets wat zij User-to-Lumo Encryption (U2L) noemen. Waar Lumo wel uitblinkt, is dat je opgeslagen chatgeschiedenis met jouw sleutel is versleuteld wanneer die is opgeslagen, zodat niemand bij Proton je oude gesprekken later kan lezen.
Hoe DentroChat het doet
We hebben geprobeerd een manier te bedenken om echte End-to-End Encryption voor DentroChat te realiseren, en we kwamen met een architectuur die er heel dicht bij in de buurt komt. Helaas was het voor ons financieel (nog) niet haalbaar om die te bouwen.
Onze huidige aanpak is de klassieke versleuteling die de meeste moderne apps gebruiken: versleuteling tijdens verzending en versleuteling in opslag:
- Wanneer wij jouw gegevens naar jou sturen, of jij gegevens naar DentroChat stuurt, wordt dat verkeer tijdens verzending versleuteld met TLS (dat publieke-privésleutels gebruikt om de versleutelde verbinding op te zetten).
- Wanneer je gegevens op onze servers in Duitsland worden opgeslagen, worden ze in opslag versleuteld (wat we zelf configureren en beheren, omdat standaard hostingproviders schijven niet standaard in opslag versleutelen). Als een aanvaller de harde schijf van onze servers kopieert, krijgt hij alleen versleutelde gegevens.
We hebben voor deze aanpak gekozen omdat het AI-model op het moment dat het jouw prompt beantwoordt, dezelfde kern van vertrouwen nodig heeft als Lumo: de gebruiker moet erop vertrouwen dat wij zijn gegevens niet lezen terwijl we ze verwerken. Onze huidige aanpak was veel eenvoudiger op te zetten, terwijl die van Proton geavanceerder is en potentiële aanvallers voor opgeslagen chatgeschiedenis meer hindernissen in de weg legt. Misschien volgen we op een gegeven moment ook hun weg als we een duidelijk voordeel zien. Voorlopig is de aanpak van DentroChat veilig, solide en door de jaren heen door veel toepassingen getest.
Hoe ChatGPT je gesprekken versleutelt (en waar het schuurt)
Op papier gebruikt ChatGPT precies dezelfde cryptografische bouwstenen als DentroChat en de meeste cloudsoftware: versleuteling tijdens verzending (TLS) tussen je browser en de servers van OpenAI, en versleuteling in opslag (AES-256) op hun schijven. ChatGPT gebruikt ook geen end-to-end-versleuteling, omdat de GPU’s van OpenAI je prompt eveneens in platte tekst nodig hebben om een antwoord te genereren.
Het verschil met ChatGPT zit in wie de sleutels heeft en wat OpenAI mag doen met je gegevens wanneer ze zijn ontsleuteld:
- Modeltraining en menselijke beoordeling: Bij ChatGPT Free en Plus worden je ontsleutelde gesprekken standaard gebruikt om toekomstige OpenAI-modellen te trainen, en steekproefsgewijs gekozen chats kunnen door menselijke beoordelaars worden gelezen, tenzij je dit handmatig uitschakelt in je instellingen. Noch Lumo noch DentroChat trainen ooit op je chats.
- Bewaring na verwijdering: Ook als je een chat verwijdert of de modus „Tijdelijke chat” van ChatGPT gebruikt, bewaart OpenAI tot 30 dagen een kopie op zijn servers (we hebben alle details hier uitgelegd).
- Blootstelling aan de US CLOUD Act: Omdat OpenAI de decryptiesleutels voor je opgeslagen chats bezit en een Amerikaans bedrijf is, kunnen Amerikaanse autoriteiten toegang afdwingen op grond van de US CLOUD Act. Zelfs als je werkruimte is ingesteld op EU-gegevensopslag!
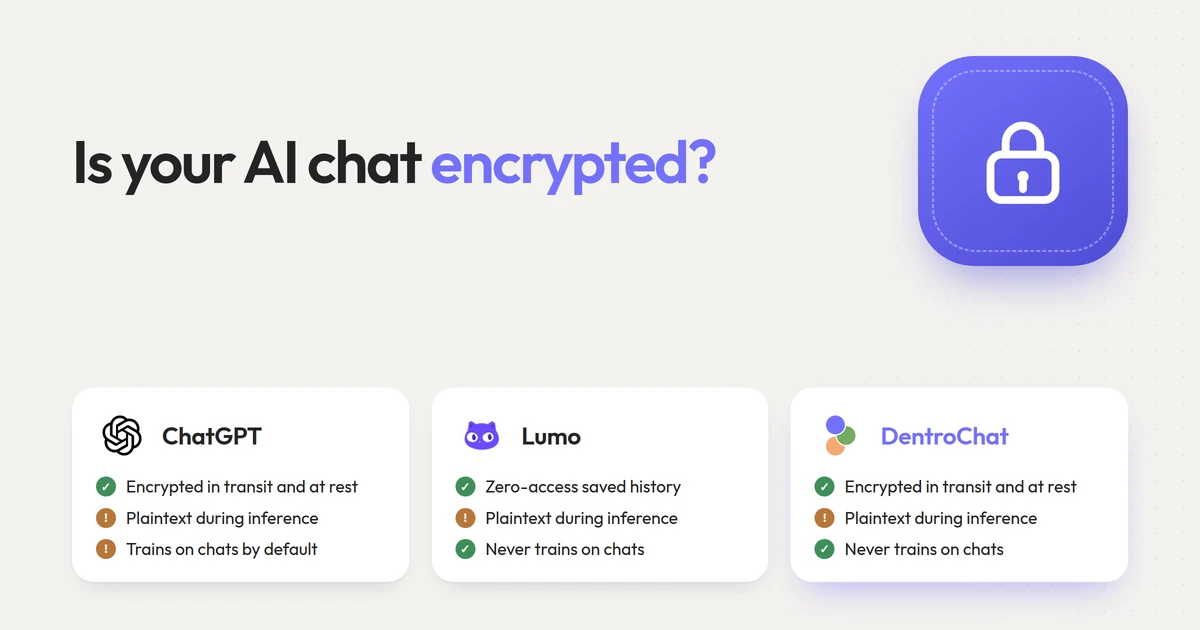
| ChatGPT | Proton Lumo | DentroChat | |
|---|---|---|---|
| Versleuteld tijdens verzending (TLS) | Ja | Ja | Ja |
| Versleuteld in opslag | Ja (OpenAI heeft de sleutels) | Ja (Zero-access, jij hebt de sleutels) | Ja (DentroChat heeft de sleutels) |
| End-to-end versleuteld tijdens AI-verwerking | Nee (platte tekst op de server) | Nee (platte tekst op de server, U2L) | Nee (platte tekst op de server) |
| Traint AI-modellen op je chats | Ja, standaard (uitschakelbaar) | Nooit | Nooit |
| Onderworpen aan de US CLOUD Act | Ja | Nee voor chats (VS voor facturatie en support) | Nee (100% EU- / Zwitserse stack) |
Twee manieren om (bijna) echte end-to-end-versleuteling voor AI te krijgen
Kun je ooit een LLM in de cloud draaien zonder dat de serverbeheerder je prompt in platte tekst ziet? Er zijn twee aanpakken voor echte E2EE.
1. Homomorfe versleuteling
Homomorfe versleuteling is een fascinerend onderzoeksgebied. Het maakt het mogelijk om berekeningen rechtstreeks op versleutelde gegevens uit te voeren.
Stel: jij versleutelt het getal 12, en een andere gebruiker versleutelt het getal 17. Beide versleutelde getallen worden bij elkaar opgeteld via een versleutelde optelling. De uitkomst is het versleutelde getal 29, en alleen jij en de andere gebruiker kunnen het echt ontsleutelen en zien dat de uitkomst 29 is. De server die de berekening deed, heeft nooit geweten dat het om 12, 17 of 29 ging.
Dit voorbeeld is eenvoudig, maar het kan ook voor LLM’s werken. Dan voer je versleutelde gegevens in de LLM, geeft de LLM een versleuteld antwoord, en kan alleen de gebruiker het antwoord ontsleutelen. Hier vindt serieus academisch onderzoek plaats, zoals dit recente artikel over versleutelde LLM-inferentie (Cachemir).
Het probleem met homomorfe versleuteling is dat het rekenkundig zeer veeleisend is en daardoor erg traag. Zelfs met recente versnellingen heb je het over ongeveer 100 seconden GPU-tijd per gegenereerd token. Dat betekent dat je 30 minuten zou moeten wachten op een simpel antwoord op „Wat is de hoofdstad van Spanje?”
2. NVIDIA H100/H200 Confidential Computing-GPU’s (TEE)
De tweede aanpak is het gebruik van NVIDIA H100/H200 Confidential Computing-GPU’s met een Trusted Execution Environment (TEE).
Het werkt zo: de GPU heeft een eigen privé-publiek sleutelpaar dat rechtstreeks in zijn hardware is ingebakken. Het wordt eenmaal aangemaakt wanneer de GPU wordt gefabriceerd, en daarna kan de privésleutel van buitenaf niet meer worden opgevraagd, zelfs niet door de persoon die het serverrek bezit.
Dat is geweldig, want nu kun je je gegevens versleutelen met de publieke sleutel van de GPU en naar de server sturen. De GPU ontsleutelt ze binnen zijn eigen hardware-enclave met zijn privésleutel, voert ze in de LLM die in de GPU draait, versleutelt het antwoord opnieuw en stuurt het naar jou terug.
Zo krijgen we bijna echte E2EE. Het enige overgebleven aanvalspunt zit in de productiestap: als de NSA alle privésleutels heeft vastgelegd terwijl deze NVIDIA-GPU’s in de fabriek werden gemaakt, zou de dienst theoretisch later, wanneer de GPU in gebruik is, nog steeds het verkeer kunnen onderscheppen en ontsleutelen. Een NVIDIA-GPU met een TEE is echter een zeer sterke veiligheidsaanname.
We hadden voor DentroChat twee opties: zelf zulke GPU’s kopen, of een Europese aanbieder vinden die ze aanbiedt. Het eerste was te duur voor ons: één H100 kost ongeveer €40.000, en om grote open-weights-modellen zoals die we in DentroChat gebruiken te draaien, hebben we er 8 nodig. Als zelffinancierend bedrijf was dat toen niet mogelijk. Een Europese aanbieder vinden die confidential computing-GPU’s gebruikt, lukte een half jaar geleden ook nog niet. Dit is echter het meest realistische pad voor de toekomst, en we zoeken voortdurend naar Europese AI-infrastructuurproviders die dit ondersteunen.
Waarom we denken dat DentroChat een sterke keuze is naast Lumo
Zelfs zonder zero-access-versleuteling voor opgeslagen geschiedenis (nog niet), zijn er een paar redenen waarom veel gebruikers voor DentroChat kiezen in plaats van Lumo:
- Betere AI-modellen: Toen we Lumo voor het laatst testten, was de kwaliteit van de antwoorden nogal mager en traag. Bij DentroChat krijg je toegang tot de beste open-sourcemodellen en een op maat gemaakt agentframework onder de motorkap.
- Nul Amerikaanse subverwerkers in de hele stack: Zowel Lumo als DentroChat draaien hun AI-verwerking op Europese en Zwitserse servers. Lumo laat facturatie en klantenservice echter nog steeds via Amerikaanse bedrijven lopen (zoals Stripe en Zendesk). Bij DentroChat gebruiken we nergens Amerikaanse subverwerkers. Je kunt onze volledige stack controleren op onze pagina met subverwerkers.
Wil je de twee in meer detail vergelijken, bekijk dan onze volledige test van Lumo-alternatieven, onze gids over privé AI-chat of hoe Europese ChatGPT-alternatieven het doen. En heb je ooit een technische vraag zoals deze, aarzel dan niet om ons te bereiken via de feedbackknop in DentroChat!
Veelgestelde vragen
Is ChatGPT end-to-end versleuteld?
Nee. OpenAI versleutelt je gesprekken tijdens verzending (TLS) en in opslag op zijn servers, wat de standaard basis is voor cloudapps. Omdat de LLM platte tekst nodig heeft om een antwoord te genereren, ontsleutelen de servers van OpenAI je prompt om die te verwerken. Tenzij je een zakelijk abonnement hebt of je expliciet afmeldt, kunnen consumentengesprekken ook voor modeltraining worden gebruikt.
Is Proton Lumo end-to-end versleuteld?
Niet end-to-end. Lumo gebruikt wat Proton User-to-Lumo (U2L)-versleuteling noemt: je opgeslagen chatgeschiedenis wordt vergrendeld met zero-access-versleuteling, zodat Proton je oude chats niet kan lezen, en je prompt wordt versleuteld helemaal tot aan de inferentieserver. De GPU-server van Proton moet je bericht echter nog steeds in het geheugen ontsleutelen om het in de LLM te kunnen voeren.
Hoe versleutelt DentroChat mijn gesprekken?
DentroChat versleutelt al het verkeer tijdens verzending met TLS en slaat je gesprekken en bestanden op met zelf beheerde versleuteling in opslag op Europese servers in Duitsland en Frankrijk. Net als bij Lumo en ChatGPT moeten prompts tijdens de inferentie in het servergeheugen worden ontsleuteld, zodat het AI-model ze kan beantwoorden, en we trainen nooit op je gegevens.
Kan een AI-chat ooit echt end-to-end versleuteld zijn?
Ja, door een klein model lokaal op je eigen computer te draaien, of in de cloud met homomorfe versleuteling of NVIDIA Confidential Computing-GPU’s (TEE’s). Vandaag de dag is homomorfe versleuteling nog veel te traag voor interactieve chat, terwijl confidential computing-GPU’s het meest veelbelovende pad vooruit zijn zodra Europese hostingproviders ze op grote schaal beschikbaar maken.