Titkosított az AI chated? ChatGPT, Lumo és DentroChat
Nemrég megkeresett minket egy DentroChat-felhasználó:
A Lumo azt állítja, hogy minden beszélgetést titkosít. A DentroChat ugyanezt csinálja, vagy más a megközelítésetek?
Ez a kérdés kicsit megmozgatott, mert régen a szakdolgozatomat kriptográfiából írtam, és most végre rendesen le akartam írni a gondolataimat. A válaszom meglehetősen hosszú és technikai lett, így ha valami túl sűrűnek tűnik, talán a legjobb, ha beillesztesz ebbe a cikkbe a Lumóba vagy a DentroChatbe, és hagyod, hogy egy AI egyszerűbben elmagyarázza :-)
Ha rendesen szeretnénk válaszolni arra, hogyan működik a titkosított AI chat, nézzük meg először a Proton titkosítását, aztán a Lumót, végül pedig azt, hogyan csinálja mindezt a DentroChat és a ChatGPT.
Hogyan működik a Proton zero-knowledge titkosítása
Nagy rajongói vagyunk a Proton ökoszisztémájának, és évek óta aktívan használjuk VPN-hez, e-mailhez, videohívásokhoz és sok máshoz.
A Proton nagy vonzereje a zero-knowledge felépítése. A nyilvános-privát kulcspárok a fiókod jelszavából származnak, és minden felhasználónál egyediek. Ezzel a privát kulccsal titkosítjuk az e-mailjeinket, a Drive-on lévő tartalmakat stb. Csak a felhasználó, vagyis mi tudjuk visszafejteni a saját adatainkat a helyi eszközünkön. A Proton munkatársai nem tudják visszafejteni az adatainkat, mert soha nem férnek hozzá a privát kulcsunkhoz.
Az előny az, hogy még ha az NSA a Proton egyik szerverén „ülne”, akkor sem férne hozzá az adatainkhoz (legalábbis addig, amíg az összes többi biztonsági feltételezés is érvényes marad). A hátránya pedig az, hogy ha valaha elveszítjük a Proton jelszavunkat és a biztonsági kódokat, és nincs beállítva helyreállítási módszer, a Proton nem tudja visszaállítani az adatainkat.
Ha a nulláról szeretnéd megérteni, hogyan működik a nyilvános-privát kulcsú titkosítás, ez a YouTube-videó a nyilvános kulcsú kriptográfiáról csodálatos. Amikor az egyetem első évében néztem meg, teljesen földbe döngölt!
Lumo: miért változtat meg mindent egy LLM
A Lumo alapvetően más, mint a többi Proton-szolgáltatás, a nagy nyelvi modellek (LLM-ek) működési módja miatt. Ahhoz, hogy választ kapj egy AI/LLM-modelltől, a bemenetet nyílt szövegként, vagyis visszafejtve kell betáplálni a modellbe. (Vannak módszerek arra, hogy ezt titkosítottabban tegyük, erről lentebb írok.)
Ha egy LLM-et a saját számítógépeden futtatnál helyben, a klasszikus Proton-titkosítási megközelítés továbbra is működne: a helyi gépeden visszafejted az adatokat, betáplálod a helyi LLM-be, választ kapsz, majd ismét helyben titkosítod az adatokat. Így működik a helyi modellek futtatása olyan eszközökkel, mint az Ollama.
A gond az, hogy a legjobb LLM-ekhez nagyon erős gépek kellenek, ami egy átlagos fogyasztói számítógépen egyszerűen nem reális. Ezért az LLM-nek egy Proton-szerveren kell futnia, és az adataidat még azelőtt vissza kell fejteni, mielőtt betáplálnák a Proton LLM-jébe.
Mi történik, amikor üzenetet küldesz a Lumónak
Amikor a Lumót használod, a következő módon működik (ahogy a Proton Lumo biztonsági modelljében le van írva):
- A csevegési előzményeidet helyben, az eszközödön visszafejted.
- Hozzáadsz egy új felhasználói üzenetet.
- A teljes üzenettörténetet az új üzeneteddel együtt titkosítja a Proton szervernek a nyilvános kulcsa, ahol az LLM fut.
- A titkosított adataid megérkeznek a Proton szerverére, és a szerver privát kulcsával visszafejtik őket. A visszafejtett adatok bekerülnek az LLM-be, amely választ generál.
- A generált választ ismét titkosítják, és visszaküldik neked.
- Az eszközödön visszafejted, és elolvasod a választ.
Adott korlátok mellett ez egy nagyon szilárd megközelítés.
Egyetlen dolog van: a megközelítés következtetés (inference) közben már nem zero-knowledge. Ha a svájci rendőrség, az NSA vagy egy becsületlen Proton-munkatárs belehallgat a Proton szerverébe, ahol az adataidat még az LLM-nek való átadás előtt visszafejtik, akkor el tudják olvasni az adataidat. A Lumo nem használ végpontok közötti titkosítást (E2EE) úgy, mint a többi Proton-szolgáltatás, hanem valamit, amit User-to-Lumo titkosításnak (U2L) neveznek. A Lumo erőssége ott van, hogy a mentett csevegési előzményeid a nyugalmi állapotban is a te kulcsoddal vannak titkosítva, így a Protonnál senki sem tudja később elolvasni a régi beszélgetéseidet.
Hogyan csinálja a DentroChat
Próbáltunk kitalálni egy módot arra, hogy valódi végpontok közötti titkosítást biztosítsunk a DentroChatnek, és egy olyan architektúrát dolgoztunk ki, amely nagyon közel van ehhez. Sajnos pénzügyileg (egyelőre) nem volt kivitelezhető számunkra megépíteni.
Jelenlegi megközelítésünk a legtöbb modern alkalmazás által használt klasszikus titkosítás: titkosítás átvitel közben és titkosítás nyugalmi állapotban:
- Amikor elküldjük neked az adataidat, vagy te küldöd el az adataidat a DentroChatnek, ez a forgalom TLS-sel titkosított átvitel közben (a TLS nyilvános-privát kulcsokat használ a titkosított kapcsolat létrehozásához).
- Amikor az adataid a németországi szervereinken tárolódnak, nyugalmi állapotban titkosítva vannak (amit mi magunk konfigurálunk és kezelünk, mivel a szokásos tárhelyszolgáltatók alapértelmezés szerint nem titkosítják nyugalmi állapotban a lemezeket). Ha egy támadó lemásolja a szervereink merevlemezét, csak titkosított adatokat kap.
Ezt a megközelítést azért választottuk, mert abban a pillanatban, amikor az AI válaszol a kérdésedre, ugyanaz a bizalmi feltételezés áll fenn, mint a Lumónál: a felhasználónak bíznia kell benne, hogy nem olvassuk az adatait a feldolgozás közben. A mi jelenlegi megoldásunkat sokkal egyszerűbb volt beállítani, míg a Proton megoldása kifinomultabb, és több akadályt állít a potenciális támadók elé a mentett csevegési előzmények esetében. Lehet, hogy egyszer mi is ezen az úton haladunk majd, ha egyértelmű előnyét látjuk. Egyelőre a DentroChat megközelítése biztonságos, szilárd, és sok alkalmazásban évek óta bevált.
Hogyan titkosítja a ChatGPT a beszélgetéseidet (és hol a csapda)
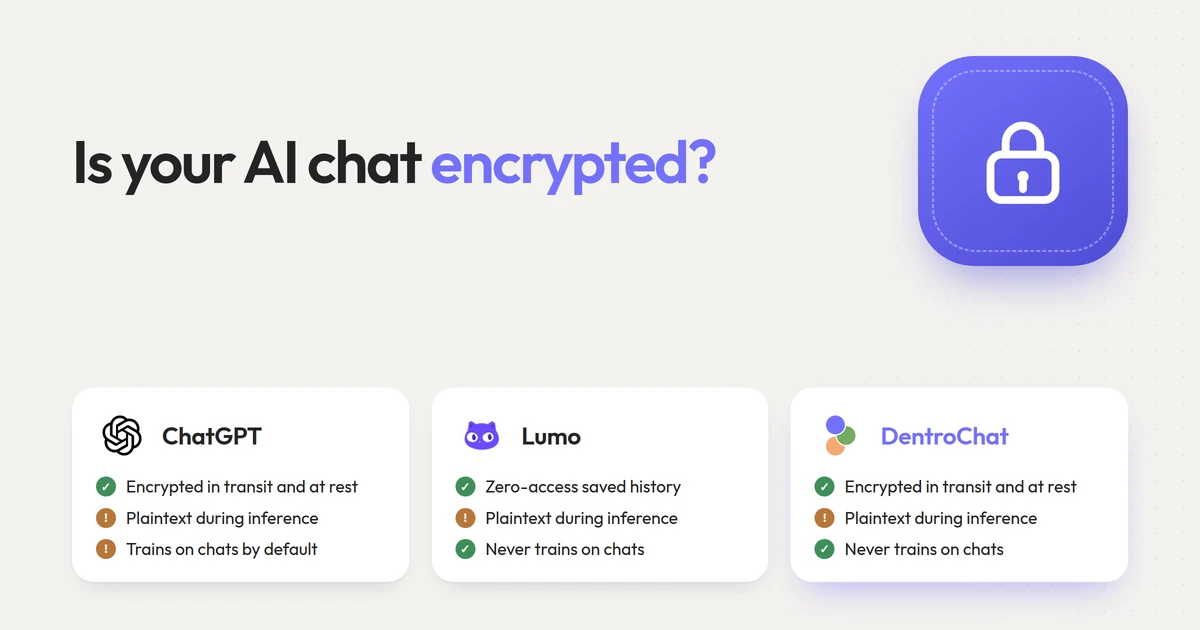
Papíron a ChatGPT pontosan ugyanazokat a kriptográfiai építőelemeket használja, mint a DentroChat és a legtöbb felhőalapú szoftver: titkosítás átvitel közben (TLS) a böngésződ és az OpenAI szerverei között, valamint titkosítás nyugalmi állapotban (AES-256) a lemezeiken. A ChatGPT sem használ végpontok közötti titkosítást, mert az OpenAI GPU-jainak is nyílt szövegben kell látniuk a kérdésedet a válasz generálásához.
A ChatGPT esetében a különbség nem az, kinél vannak a kulcsok, és mit tehet az OpenAI az adataiddal, amikor visszafejti őket:
- Modellképzés és emberi felülvizsgálat: A ChatGPT Free és Plus esetén a visszafejtett beszélgetéseidet alapértelmezés szerint felhasználják a jövőbeli OpenAI-modellek képzéséhez, a mintavételezett csevegéseket pedig emberi felülvizsgálók is elolvashatják, hacsak nem kapcsolod ki kézzel a beállításokban. Sem a Lumo, sem a DentroChat nem tanul soha a csevegéseidből.
- Megőrzés a törlés után: Még ha törölsz is egy csevegést, vagy a ChatGPT „Ideiglenes csevegés” módját használod, az OpenAI legfeljebb 30 napig megtart egy másolatot a szervereiken (itt részletesen leírtuk).
- Kitettség a US CLOUD Act-nek: Mivel az OpenAI birtokolja a mentett csevegéseid visszafejtő kulcsait, és amerikai cég, az amerikai hatóságok kikényszeríthetik a hozzáférést a US CLOUD Act alapján. Még akkor is, ha a munkaterületed EU-s adatrezidenciára van állítva!
| ChatGPT | Proton Lumo | DentroChat | |
|---|---|---|---|
| Átvitel közben titkosítva (TLS) | Igen | Igen | Igen |
| Nyugalmi állapotban titkosítva | Igen (az OpenAI birtokolja a kulcsokat) | Igen (Zero-access, te birtokolod a kulcsokat) | Igen (a DentroChat birtokolja a kulcsokat) |
| Végpontok közötti titkosítás AI-következtetés közben | Nem (nyílt szöveg a szerveren) | Nem (nyílt szöveg a szerveren, U2L) | Nem (nyílt szöveg a szerveren) |
| AI-modellek tanítása a csevegéseiden | Igen, alapértelmezés szerint (kikapcsolható) | Soha | Soha |
| Hatálya alá tartozik a US CLOUD Act | Igen | Csevegések esetén nem (számlázás/támogatás esetén USA) | Nem (100%-ban EU/svájci stack) |
Két út a (majdnem) valódi végpontok közötti titkosításhoz AI-nál
Lehetséges-e egyáltalán felhőben futtatni egy LLM-et úgy, hogy a szerver üzemeltetője ne lássa a nyílt szövegű kérdésedet? Két megközelítés létezik a valódi E2EE-hez.
1. Homomorf titkosítás
A homomorf titkosítás elképesztő kutatási terület. Lehetővé teszi, hogy közvetlenül a titkosított adatokon végezz számításokat.
Példa: te titkosítod a 12 számot, egy másik felhasználó pedig a 17-et. Mindkét titkosított számot egy titkosított összeadási művelettel összeadjuk. Az eredmény a titkosított 29, és csak te és a másik felhasználó tudjátok visszafejteni, hogy az eredmény 29. A számítást végző szerver soha nem tudta meg, hogy a számok 12, 17 vagy 29.
Ez a példa egyszerű, de LLM-ek esetén is működhet. Ilyenkor titkosított adatokat viszel be az LLM-be, az LLM titkosított választ ad, és csak a felhasználó tudja visszafejteni a választ. Jelentős akadémiai kutatás folyik ezen a területen, például ez a közelmúltbeli tanulmány a titkosított LLM-következtetésről (Cachemir).
A homomorf titkosítás problémája az, hogy számításilag rendkívül költséges, és ezért nagyon lassú. Még a legutóbbi gyorsításokkal is nagyjából 100 másodperc GPU-idővel számolhatunk generált tokenenként, ami azt jelenti, hogy egy egyszerű válaszra, például a „Mi Spanyolország fővárosa?” kérdésre 30 percet kellene várnod.
2. NVIDIA H100/H200 Confidential Computing GPU-k (TEE)
A második megközelítés az NVIDIA H100/H200 Confidential Computing GPU-k használata megbízható végrehajtási környezettel (TEE).
A működés a következő: a GPU-nak saját privát-nyilvános kulcspárja van, amely közvetlenül a hardverébe van beégetve. Ezt a GPU gyártásakor hozzák létre egyszer, és miután létrejött, a privát kulcsot kívülről nem lehet kiolvasni, még a szerverszekrény tulajdonosa sem.
Ez nagyszerű, mert most titkosíthatod az adataidat a GPU nyilvános kulcsával, és elküldheted a szervernek. A GPU a saját hardveres enklávéjában a privát kulcsával visszafejti azokat, betáplálja a GPU-n belül futó LLM-be, újra titkosítja a választ, és visszaküldi neked.
Ezzel szinte valódi E2EE-t kapunk. Az egyetlen megmaradó hardveres támadási vektor a gyártási lépésnél van: ha az NSA rögzítette volna az összes privát kulcsot, amikor ezeket az NVIDIA GPU-kat a gyárban létrehozták, elméletileg később, a GPU üzembe helyezésekor is el tudnák fogni és visszafejteni a forgalmat. Egy TEE-s NVIDIA GPU azonban nagyon erős biztonsági feltételezés.
A DentroChatnek két lehetőségünk volt: vagy saját magunk vesszük meg az ilyen GPU-kat, vagy találunk egy európai szolgáltatót, amely kínálja őket. Az első túl drága volt számunkra: egyetlen H100 körülbelül 40 000 euróba kerül, és ahhoz, hogy a nagy, nyílt súlyú modelleket futtathassuk, mint amilyenek a DentroChatben is vannak, 8 darabra lenne szükségünk. Önfinanszírozó vállalkozásként akkoriban ez nem volt lehetséges. Fél évvel ezelőtt az sem volt lehetséges, hogy találjunk egy európai szolgáltatót, amely confidential computing GPU-kat használ. Ez viszont a legreálisabb út előre, és folyamatosan keresünk olyan európai AI-infrastruktúra-szolgáltatókat, amelyek ezt támogatják.
Miért gondoljuk, hogy a DentroChat erős választás a Lumo mellett
Még a mentett előzmények zero-access titkosítása nélkül is van néhány ok, amiért sok felhasználó a Lumo helyett a DentroChatet választja:
- Jobb AI-modellek: Amikor legutóbb teszteltük a Lumót, a kapott válaszok minősége elég gyenge és lassú volt. A DentroChatben a legjobb nyílt forráskódú modellekhez férhetsz hozzá, a motorháztető alatt pedig egy testreszabott agent harness dolgozik.
- Nulla amerikai alvállalkozó az egész stackben: Mind a Lumo, mind a DentroChat európai és svájci szervereken futtatja az AI-következtetést. A Lumo azonban a számlázást és az ügyfélszolgálatot továbbra is amerikai cégeken (például a Stripe-on és a Zendesken) keresztül bonyolítja. A DentroChatnél sehol nem használunk amerikai alvállalkozót. A teljes stackünket a alvállalkozói oldalunkon ellenőrizheted.
Ha a kettőt részletesebben szeretnéd összehasonlítani, nézd meg teljes Lumo-alternatívák tesztünket, a privát AI chatről szóló útmutatónkat, vagy azt, hogyan állnak helyt az európai ChatGPT-alternatívák. És ha valaha hasonló technikai kérdésed van, bátran írj nekünk a DentroChatben található visszajelzés gombon keresztül!
Gyakran ismételt kérdések
Végpontok közötti titkosítású a ChatGPT?
Nem. Az OpenAI átvitel közben (TLS) és nyugalmi állapotban titkosítja a beszélgetéseidet a szerverein, ami a felhőalkalmazások szokásos alapszintje. Mivel az LLM-nek nyílt szövegre van szüksége a válasz generálásához, az OpenAI szerverei visszafejtik a kérdésedet a feldolgozáshoz. Hacsak nem üzleti csomagon vagy, vagy kifejezetten nem mondasz nemet, a fogyasztói beszélgetéseket modellképzéshez is felhasználhatják.
Végpontok közötti titkosítású a Proton Lumo?
Nem végpontok között. A Lumo azt használja, amit a Proton User-to-Lumo (U2L) titkosításnak nevez: a mentett csevegési előzményeidet zero-access titkosítás védi, így a Proton nem tudja elolvasni a régi beszélgetéseidet, a kérdésed pedig egészen a következtetési szerverig titkosítva van. A Proton GPU-szerverének azonban a memóriában vissza kell fejtenie az üzenetedet, hogy betáplálja az LLM-be.
Hogyan titkosítja a DentroChat a beszélgetéseimet?
A DentroChat minden forgalmat átvitel közben TLS-sel titkosít, a beszélgetéseidet és fájljaidat pedig saját kezelésű, nyugalmi állapotban történő titkosítással tárolja európai szervereken, Németországban és Franciaországban. A Lumóhoz és a ChatGPT-hez hasonlóan a kéréseket a szerver memóriájában kell visszafejteni a következtetés során, hogy az AI-modell válaszolhasson rájuk, és mi soha nem tanítunk az adataidon.
Lehet-e valaha valóban végpontok közötti titkosítású egy AI chat?
Igen, akár úgy, hogy egy kis modellt futtatsz helyben a saját számítógépeden, akár a felhőben homomorf titkosítással vagy NVIDIA Confidential Computing GPU-kkal (TEE). Ma a homomorf titkosítás még túl lassú az interaktív csevegéshez, míg a confidential computing GPU-k a legígéretesebb út előre, amint az európai tárhelyszolgáltatók széles körben elérhetővé teszik őket.