¿Cuánta energía consume un prompt de IA?
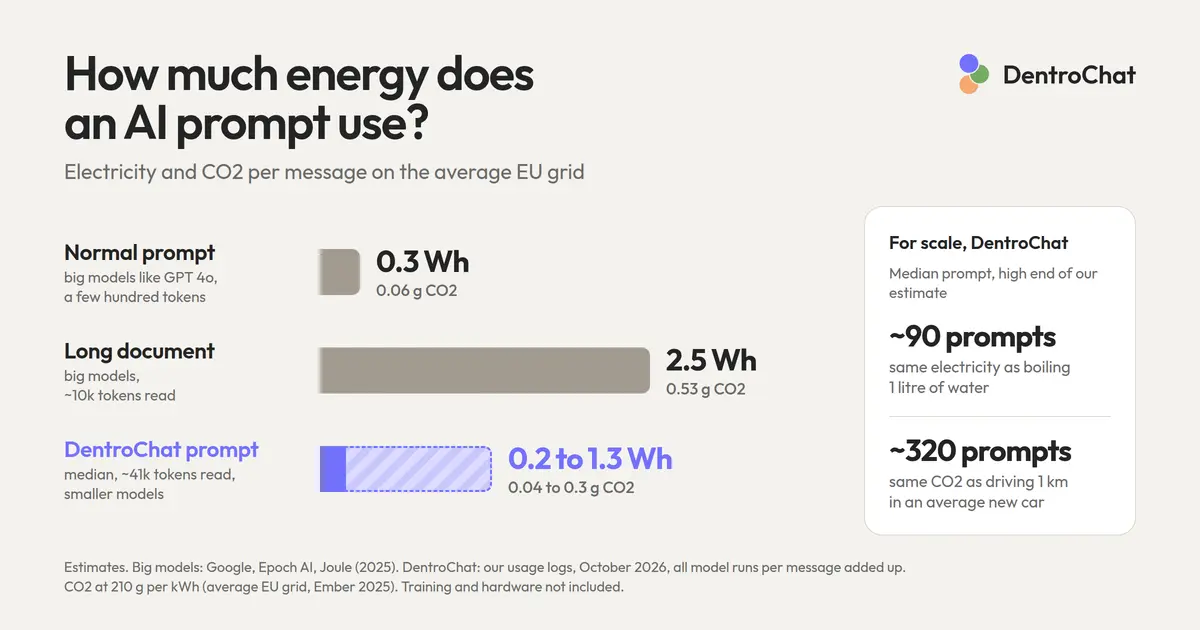
Los usuarios de DentroChat, nuestro asistente de IA de la UE, a veces nos preguntan cuánta electricidad gastan sus mensajes. Es una pregunta razonable. Nos gustaría mostrarte un número en el producto, pero las empresas que ejecutan los modelos en la nube en su mayoría aún no dan la energía de una sola petición. Así que hemos hecho lo posible por aproximarla con investigación pública.
Estos no son mediciones de laboratorio de DentroChat. Hemos repasado los estudios que encontramos y los hemos contrastado entre sí; las cifras de abajo son donde coinciden. Si tienes una fuente mejor, cuéntanoslo.
Electricidad para un prompt normal
Un prompt típico: haces una pregunta y el modelo responde con unos cientos de tokens. Un token es un trozo de palabra, o una palabra entera si es corta.
Google lo midió. En mayo de 2025, el prompt de texto mediano en sus apps Gemini era de 0,24 vatios-hora. Eso incluye chip y refrigeración de toda la nave del centro de datos. Para el prompt mediano, Google calculó 0,03 gramos de CO2 (con la electricidad de Google).
Epoch AI estimó una respuesta típica en ChatGPT en febrero de 2025 en unos 0,3 vatios-hora, para una respuesta de unos 500 tokens. Dicen que su estimación queda un poco alta.
Un artículo en Joule de abril de 2026, con datos de despliegues de 2025, estima la mediana en un modelo grande en 0,31 vatios-hora. Sam Altman publicó en junio de 2025 que la consulta media en ChatGPT ronda ~0,34 vatios-hora.
Para un prompt típico diríamos 0,3 vatios-hora. Medición y estimaciones salen al mismo sitio.
Electricidad para un prompt más largo
Un documento largo implica más trabajo porque hay que leer mucho.
Epoch AI estimó que unos 10k tokens de entrada llevan a unos 2,5 vatios-hora en ese tipo de consulta. Para ver qué significa en palabras, contamos tokens en nuestras propias páginas. Las cifras aquí usan el tokenizador GPT 4o: unos 7.700 palabras en inglés y unos 5.800 en alemán, es decir, un artículo largo o un chat con muchos mensajes. Más abajo pasamos las mismas páginas por otros cinco tokenizadores, y la tabla muestra cuánto se apartan de GPT 4o.
Jegham et al. hicieron su propia estimación para un prompt así: 10k de entrada, 1.500 de salida. Entre ~1,4 y 2,9 vatios-hora según el modelo. Mismo orden de magnitud que Epoch.
Si el modelo piensa mucho y escribe miles de tokens antes de que aparezca la respuesta, se gasta más electricidad. En el artículo de Joule ponen una respuesta de unos 5k tokens en ~4 vatios-hora. Es una respuesta de estilo «reasoning», donde el modelo razona mucho.
Aquí va todo en una tabla. Son modelos grandes como GPT 4o y Gemini:
| Tipo de prompt | Tokens, aprox. | Electricidad | Fuente |
|---|---|---|---|
| Prompt normal | pregunta corta, unos cientos de tokens de vuelta | ~0,3 Wh | Google, Epoch AI, artículo Joule, Altman |
| Documento largo | ~10k entrada, 500 a 1.500 salida | ~2,5 Wh (1,4 a 2,9) | Epoch AI, Jegham et al. |
| Respuesta reasoning | ~5k salida | ~4 Wh | Artículo Joule |
En resumen: un prompt normal usa unos 0,3 vatios-hora. Un documento largo de unos 10k tokens unos 2,5 vatios-hora, entre 1,4 y 2,9 según el modelo. Una respuesta reasoning larga de unos 5k tokens unos 4 vatios-hora.
El CO2 depende de la red eléctrica
La electricidad para el mismo modelo es más o menos la misma donde estén los servidores. Pero el CO2 depende de la red local.
Tomamos las cifras de Ember, 2025, visibles en « Our World in Data ». Son cifras de ciclo de vida: incluyen la cadena de suministro eléctrica además de las emisiones de la central, en gramos de equivalente CO2 por kilovatio-hora.
Multiplicamos eso por nuestros dos números, 0,3 Wh para un prompt normal y 2,5 Wh para un documento largo:
| Red | g CO2e por kWh | Prompt normal | Documento largo |
|---|---|---|---|
| Noruega | 28 | 0,01 g | 0,07 g |
| Suecia | 35 | 0,01 g | 0,09 g |
| Francia | 41 | 0,01 g | 0,10 g |
| Finlandia | 57 | 0,02 g | 0,14 g |
| Dinamarca | 114 | 0,03 g | 0,29 g |
| Austria | 117 | 0,04 g | 0,29 g |
| España | 154 | 0,05 g | 0,38 g |
| Media UE | 210 | 0,06 g | 0,53 g |
| Países Bajos | 254 | 0,08 g | 0,63 g |
| Italia | 285 | 0,09 g | 0,71 g |
| Estonia | 319 | 0,10 g | 0,80 g |
| Alemania | 330 | 0,10 g | 0,82 g |
| Estados Unidos | 384 | 0,12 g | 0,96 g |
| Polonia | 589 | 0,18 g | 1,47 g |
En resumen: en Suecia (35 g por kWh) y Francia (41 g), un prompt normal son unos 0,01 gramos de CO2 y un documento largo unos 0,1 gramos. En la media de la UE (210 g), un prompt normal unos 0,06 gramos y un documento largo unos 0,5 gramos. En Alemania (330 g), un prompt normal unos 0,1 gramos y un documento largo unos 0,8 gramos. Polonia es la más alta de la tabla con 589 g, así que un prompt normal unos 0,18 gramos y un documento largo unos 1,5 gramos. Estados Unidos está porque muchas cifras de ChatGPT salen de allí. A 384 g, unos 0,12 gramos para un prompt normal y unos 1 gramo para un documento largo.
En Alemania, la agencia medioambiental dice cosas parecidas para 2025: 344 g CO2 por kWh de generación y 406 g de equivalente CO2 con la cadena de suministro. Electricity Maps sitúa el consumo real de electricidad en Alemania en 335 g en 2025. Horas sueltas pueden ir de ~100 g a ~600 g.
¿Y DentroChat?
Todas las cifras hasta aquí son para modelos grandes como GPT 4o. Epoch asumía que unos 100 mil millones de parámetros trabajan en cada token, pero DentroChat suele usar modelos más pequeños. Son modelos «mixture of experts»: el modelo es grande, pero solo una parte trabaja en cada token. DeepSeek V4 Flash usa unos 13 mil millones de parámetros por token, GLM 5.3 Flash unos 18 mil millones y Qwen 3.8 Flash Next unos 6 mil millones.
Menos parámetros activos significa menos electricidad por token y menos CO2 por token. La tabla ML.ENERGY lo midió con sus GPU. Un modelo Qwen con 22 mil millones de parámetros activos necesitaba unos 0,12 Wh por 1.000 tokens escritos. DeepSeek V3.1 con 37 mil millones unos 0,37 Wh. Eso es solo las tarjetas gráficas, así que sumamos refrigeración y el resto de servidores. Nuestros modelos son más pequeños que ambos, de ahí nuestra estimación:
| Por 1.000 tokens | Parámetros activos por token | Escritos | Leídos, frescos | Leídos, en caché | CO2 por 1.000 escritos, media UE |
|---|---|---|---|---|---|
| GPT 4o (supuesto Epoch) | ~100 mil millones | ~0,6 Wh | ~0,2 Wh | ~0,13 g | |
| Modelos DentroChat (nuestra estimación) | 6 a 18 mil millones | 0,05 a 0,4 Wh | 0,01 a 0,07 Wh | 0,001 a 0,007 Wh | 0,01 a 0,08 g |
En resumen: para GPT 4o, las cifras de Epoch dan unos 0,6 vatios-hora por cada 1.000 tokens que escribe el modelo y unos 0,2 por cada 1.000 que lee. Para los modelos en DentroChat estimamos 0,05 a 0,4 vatios-hora por 1.000 tokens escritos y 0,01 a 0,07 por 1.000 leídos. Si el texto ya se leyó hace unos minutos, está en caché y cuesta aproximadamente una décima parte. En la red media de la UE, 1.000 tokens escritos son unos 0,13 gramos de CO2 para GPT 4o y 0,01 a 0,08 gramos para nuestros modelos.
Pero nuestros prompts son más grandes que el « prompt normal » de los estudios. Cada mensaje también envía al modelo sus instrucciones y las descripciones de sus herramientas, ya unos 3k tokens. Encima van tu memoria, el chat hasta ahora y archivos o resultados de búsqueda web. Cuando el modelo usa una herramienta, vuelve a leerlo todo. Por ejemplo, primero decide buscar en la web y luego relee todo el chat con los resultados para escribir la respuesta. Un mensaje tuyo puede implicar varias pasadas del modelo.
Todas las cifras de la tabla de abajo son por mensaje que envías. Si un mensaje hizo correr el modelo varias veces, sumamos esas pasadas en una fila.
Miramos nuestros propios registros de uso y contamos tokens (lo que escribes, claro, no lo leemos). La tabla usa 606 prompts de un día de octubre de 2026. También revisamos los 21.700 prompts de los 30 días anteriores, y la mediana era muy parecida:
| Prompt DentroChat | Tokens leídos | de ellos en caché | Tokens escritos | Electricidad (nuestra estimación) | CO2, media UE | CO2, Alemania |
|---|---|---|---|---|---|---|
| Mediana | ~41k | ~30k | ~900 | 0,2 a 1,3 Wh | 0,04 a 0,3 g | 0,06 a 0,4 g |
| Top 10 % | ~131k | ~66k | ~4.600 | 1 a 7 Wh | 0,2 a 1,4 g | 0,3 a 2,3 g |
En resumen: el prompt mediano de DentroChat lee unos 41k tokens, de los cuales unos 30k en caché porque se enviaron unos minutos antes. Escribe unos 900 tokens. Lo estimamos en 0,2 a 1,3 vatios-hora, unos 0,04 a 0,3 gramos de CO2 en la red media de la UE y 0,06 a 0,4 gramos en Alemania. El 10 % superior lee 131k tokens o más y escribe 4.600 o más. Son unos 1 a 7 vatios-hora, o 0,2 a 1,4 gramos de CO2 en la media de la UE y 0,3 a 2,3 gramos en Alemania.
Para la fila del top 10 % tomamos cada columna por separado. Un prompt real rara vez alcanza todo a la vez, así que la fila está a propósito del lado pesado.
También hay trabajo en segundo plano, como actualizar tu memoria o resumir chats largos. A veces un modelo va lento y cambiamos a uno de respaldo a mitad de camino. Esas pasadas no están en la tabla. Repartidas entre todos los prompts, el prompt medio lee unos 76k tokens (50k en caché) y escribe unos 2k. Eso cae en unos 0,4 a 3 vatios-hora.
Un prompt de DentroChat lee mucho más que el prompt normal de los estudios. Cada token cuesta menos. La mediana DentroChat (0,2 a 1,3 Wh) se acerca al prompt normal de los modelos grandes (0,3 Wh) por abajo y a unos la mitad de su documento largo (2,5 Wh) por arriba.
A modo de comparación: un hervidor y un trayecto corto
Hacen falta unos 100 vatios-hora de calor para calentar un litro de agua del grifo hasta hervir. Parte no llega al agua, así que en el enchufe son más bien 110-125 vatios-hora.
Un prompt mediano de DentroChat es una pequeña fracción de eso. Usamos el extremo alto de nuestra estimación, 1,3 vatios-hora, para que la comparación siga del lado pesado. A ese ritmo harían falta unos 90 prompts de DentroChat para igualar un litro.
Para el coche tomamos la media de coches nuevos en 2025 de la Agencia Europea de Medio Ambiente: 96,7 g CO2 por km según pruebas de laboratorio. La media incluye eléctricos contados a cero en escape, así que un gasolina en carretera gastará un poco más.
Por cada kilómetro que conduzcas en ese coche nuevo medio podrías enviar unos 240 prompts medianos de DentroChat en Alemania. Otra vez el extremo alto: 0,4 gramos de CO2 por prompt. En la red media de la UE el mismo prompt son 0,3 gramos, unos 320 prompts por kilómetro.
El idioma y los tokens
Cada idioma usa distinto número de tokens para tokenizar la misma página. Pasamos nuestros artículos por tokenizadores de las 17 lenguas que admite DentroChat.
Usamos 22 entradas del blog, que existen en cada idioma, así que es el mismo texto cada vez. La cifra principal es el tokenizador GPT 4o. El rango es el mínimo y máximo en seis tokenizadores (GPT 4o, GPT 4, Mistral, Llama 3, Qwen 2.5 y DeepSeek V3).
| Idioma | Tokens por palabra | Rango | Palabras en 10k tokens |
|---|---|---|---|
| Inglés | 1,3 | 1,3 a 1,4 | ~7.700 |
| Español | 1,4 | 1,4 a 1,7 | ~7.200 |
| Portugués | 1,4 | 1,4 a 1,7 | ~7.000 |
| Francés | 1,4 | 1,4 a 1,7 | ~6.900 |
| Neerlandés | 1,6 | 1,6 a 2,1 | ~6.300 |
| Italiano | 1,7 | 1,7 a 1,9 | ~6.000 |
| Alemán | 1,7 | 1,7 a 2,1 | ~5.800 |
| Noruego | 1,9 | 1,9 a 2,2 | ~5.400 |
| Sueco | 1,9 | 1,9 a 2,3 | ~5.300 |
| Danés | 1,9 | 1,9 a 2,3 | ~5.300 |
| Rumano | 1,9 | 1,9 a 2,2 | ~5.300 |
| Croata | 2,1 | 2,1 a 2,6 | ~4.800 |
| Polaco | 2,2 | 2,2 a 2,6 | ~4.500 |
| Griego | 2,4 | 2,4 a 5,9 | ~4.200 |
| Estonio | 2,5 | 2,5 a 3,1 | ~4.000 |
| Húngaro | 2,6 | 2,5 a 3,1 | ~3.900 |
| Finés | 2,8 | 2,8 a 3,5 | ~3.600 |
En resumen: en el tokenizador GPT 4o el inglés ronda 1,3 tokens por palabra, así que 10k tokens son unos 7.700 palabras en inglés. Español, portugués y francés van justo detrás con unos 1,4. Neerlandés unos 1,6, alemán e italiano unos 1,7, así que 10k tokens son unos 5.800 palabras en alemán. Las lenguas nórdicas salvo finés rondan 1,9. Estonio unos 2,5 y finés el más alto con unos 2,8, así que 10k tokens son solo unos 3.600 palabras en finés.
A menudo se dice que una palabra alemana son 3 tokens. En tokenizadores modernos medimos más bien 2. El griego tiene el rango grande porque los tokenizadores antiguos manejan mal el alfabeto griego.
El documento en finés, para la misma longitud, usa más tokens y por tanto más electricidad. Los g CO2/Wh de la red siguen siendo los de la tabla de arriba.
Lo que no hemos tratado
Esto es la electricidad de una respuesta a un mensaje.
El entrenamiento del modelo se hizo antes de una vez y lo comparten todos los que lo usan. Asignar el coste de entrenamiento a tu prompt sería adivinar, así que lo dejamos fuera.
Está el coste de fabricar las tarjetas gráficas. El desglose de Nvidia para una placa H100: 1.312 kg de equivalente CO2 para 8 GPU, repartidos en unos años de operación. En un prompt solo cargas una fracción minúscula, muy por debajo de 1 g. En una red limpia como Suecia, esa fracción puede acercarse al CO2 de la propia electricidad. En la red alemana la electricidad pesa mucho más.
Y el agua. La afirmación viral de que la IA bebe una botella de agua viene de una estimación de 2023 para GPT 3: unos 500 ml para 20 a 50 respuestas, en centros de datos calientes de EE. UU. con refrigeración por evaporación. Google midió 0,26 ml para un prompt de texto Gemini mediano (~cinco gotas). Pero muchos centros europeos enfrían con aire exterior y casi no usan agua !! Eso incluye Hetzner en Alemania, donde está alojado DentroChat, y los centros suecos donde corren parte de nuestros modelos. Escribimos más en ¿La IA desperdicia agua? y con más detalle en Consumo de agua de la IA: por qué las cifras virales engañan.
También este punto práctico. Si sigues en el mismo chat, el documento largo suele quedarse en memoria unos minutos. El siguiente mensaje procesa sobre todo el texto nuevo. OpenAI y Anthropic hablan de cachés que caducan tras, digamos, 5-10 minutos sin actividad. Esa es la columna « en caché » de nuestra tabla DentroChat. También ayuda cuando el modelo corre varias veces por un mensaje, porque la segunda pasada puede reutilizar lo que la primera ya leyó.
Seguiríamos queriendo mostrarte un vatios-hora real por cada mensaje en DentroChat, el mejor chat de IA de la UE. Para eso, quienes ejecutan los modelos tendrían que decirnos la energía de cada petición, y la mayoría aún no lo hace.
Hasta entonces, esta es nuestra mejor aproximación. En modelos grandes como GPT 4o, un prompt normal usa unos 0,3 vatios-hora y un documento largo unos 2,5. Un prompt mediano de DentroChat en nuestros modelos más pequeños usa unos 0,2 a 1,3 vatios-hora. En la red media de la UE es como mucho unos 0,3 gramos de CO2.