Πόση ενέργεια καταναλώνει ένα AI prompt;
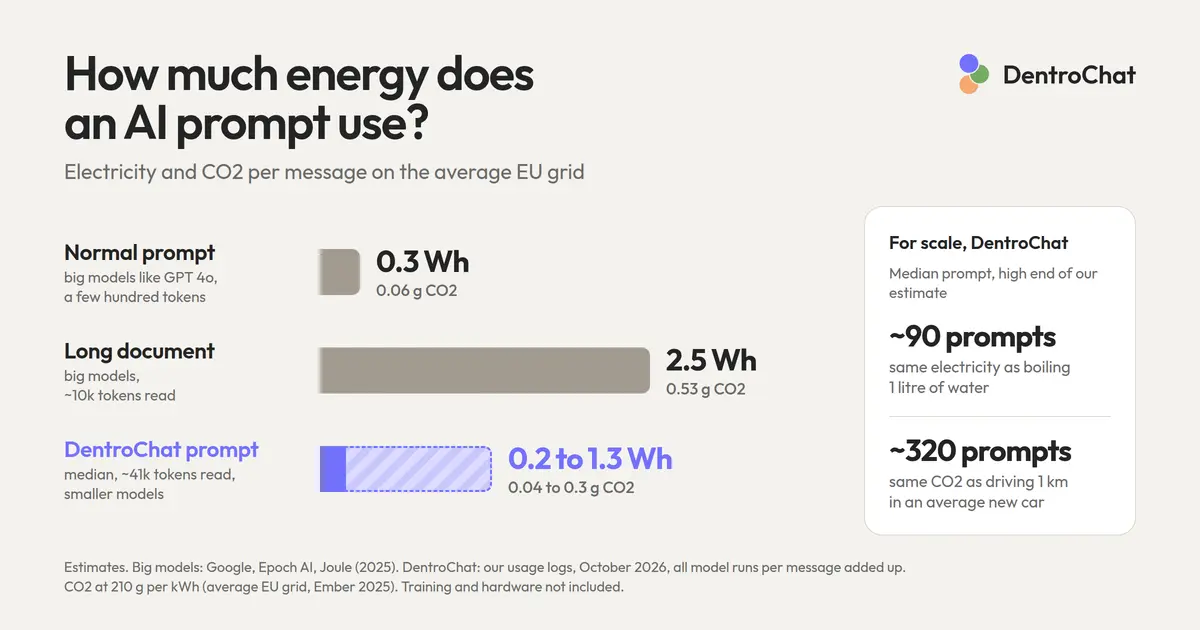
Οι χρήστες του DentroChat, του EU AI βοηθού μας, μας ρωτούν καμιά φορά πόση ενέργεια πάνε τα μηνύματά τους. Λογική ερώτηση. Θα θέλαμε να σου δείχνουμε αριθμό στο προϊόν, αλλά οι εταιρείες που τρέχουν τα μοντέλα στο cloud για το περισσότερο δεν δίνουν ακόμα την ενέργεια ανά αίτημα. Έτσι προσπαθήσαμε να το προσεγγίσουμε με δημόσια έρευνα.
Δεν είναι μετρήσεις εργαστηρίου του DentroChat. Διαβάσαμε τις μελέτες που βρήκαμε, τις συγκρίναμε μεταξύ τους, και οι αριθμοί παρακάτω είναι εκεί που καταλήγουν. Αν έχεις καλύτερη πηγή, πες μας.
Ρεύμα για ένα κανονικό prompt
Τυπικό prompt: κάνεις μια ερώτηση και το μοντέλο απαντά με μερικές εκατοντάδες tokens. Token σημαίνει κομμάτι λέξης, ή ολόκληρη λέξη αν είναι σύντομη.
Το μέτρησε η Google. Τον Μάιο του 2025 το median text prompt στις εφαρμογές Gemini ήταν 0,24 watt-ώρες. Περιλάμβανε chip και ψύξη για όλη την αίθουσα του data center. Η Google υπολόγισε για το median prompt CO2 0,03 γραμμάρια (με το ρεύμα της Google).
Η Epoch AI εκτίμησε μια τυπική απάντηση ChatGPT τον Φεβρουάριο 2025 σε ~0,3 watt-ώρες, με απάντηση ~500 tokens. Λένε ότι η εκτίμηση είναι λίγο υψηλή.
Άρθρο στο Joule τον Απρίλιο 2026. Τα δεδομένα από deployments του 2025. Για μεγάλο μοντέλο το median ήταν 0,31 watt-ώρες. Ο Sam Altman έγραψε τον Ιούνιο 2025 ότι το μέσο query στο ChatGPT είναι ~0,34 watt-ώρες.
Για τυπικό prompt θα λέγαμε 0,3 watt-ώρες. Μέτρηση και εκτιμήσεις καταλήγουν στο ίδιο.
Ρεύμα για μεγαλύτερο prompt
Ένα μακρύ έγγραφο είναι περισσότερη δουλειά γιατί διαβάζεις πολλά.
Η Epoch AI εκτίμησε ότι ~10k tokens εισόδου οδηγούν σε ~2,5 watt-ώρες για τέτοιο query. Για να δεις τι σημαίνει σε λέξεις, μετρήσαμε tokens στις δικές μας σελίδες. Οι αριθμοί εδώ με GPT-4o tokenizer: ~7.700 αγγλικές λέξεις και ~5.800 γερμανικές, δηλαδή μακρύ άρθρο ή chat με πολλά μηνύματα. Πιο κάτω τρέξαμε τις ίδιες σελίδες με άλλους πέντε tokenizers, και ο πίνακας δείχνει πόσο απέχουν από το GPT-4o.
Jegham et al. έκαναν δική τους εκτίμηση για prompt 10k in, 1500 out: ~1,4–2,9 watt-ώρες ανάλογα με το μοντέλο. Παρόμοια κλίμακα με την Epoch.
Αν το μοντέλο σκέφτεται πολύ και γράφει χιλιάδες tokens πριν φανεί η απάντηση, καταναλώνεται περισσότερο ρεύμα. Στο Joule paper μια απάντηση ~5k tokens είναι ~4 watt-ώρες. Είναι απάντηση τύπου «reasoning» όπου το μοντέλο υπολογίζει πολύ.
Όλα σε έναν πίνακα. Μεγάλα μοντέλα όπως GPT-4o και Gemini:
| Τύπος prompt | Tokens, χονδρικά | Ρεύμα | Πηγή |
|---|---|---|---|
| Κανονικό prompt | σύντομη ερώτηση, μερικές εκατοντάδες tokens απάντηση | ~0,3 Wh | Google, Epoch AI, Joule paper, Altman |
| Μακρύ έγγραφο | ~10k in, 500–1.500 out | ~2,5 Wh (1,4–2,9) | Epoch AI, Jegham et al. |
| Reasoning απάντηση | ~5k out | ~4 Wh | Joule paper |
Με λόγια: κανονικό prompt ~0,3 watt-ώρες. Μακρύ έγγραφο ~10k tokens ~2,5 watt-ώρες, 1,4–2,9 ανάλογα με το μοντέλο. Μακριά reasoning απάντηση ~5k tokens ~4 watt-ώρες.
Το CO2 εξαρτάται από το δίκτυο
Το ρεύμα για το ίδιο μοντέλο είναι περίπου το ίδιο όπου είναι οι servers. Το CO2 εξαρτάται από το τοπικό δίκτυο.
Πήραμε τα νούμερα της Ember, 2025, στο Our World in Data. Είναι lifecycle: περιλαμβάνουν την αλυσίδα εφοδιασμού ρεύματος πάνω από τις εκπομπές του σταθμού, σε γραμμάρια CO2 ισοδύναμου ανά kilowatt-ώρα.
Τα πολλαπλασιάσαμε με τα δύο νούμερα: 0,3 Wh κανονικό prompt και 2,5 Wh μακρύ έγγραφο:
| Δίκτυο | g CO2e ανά kWh | Κανονικό prompt | Μακρύ έγγραφο |
|---|---|---|---|
| Νορβηγία | 28 | 0,01 g | 0,07 g |
| Σουηδία | 35 | 0,01 g | 0,09 g |
| Γαλλία | 41 | 0,01 g | 0,10 g |
| Φινλανδία | 57 | 0,02 g | 0,14 g |
| Δανία | 114 | 0,03 g | 0,29 g |
| Αυστρία | 117 | 0,04 g | 0,29 g |
| Ισπανία | 154 | 0,05 g | 0,38 g |
| Μέσος όρος ΕΕ | 210 | 0,06 g | 0,53 g |
| Ολλανδία | 254 | 0,08 g | 0,63 g |
| Ιταλία | 285 | 0,09 g | 0,71 g |
| Εσθονία | 319 | 0,10 g | 0,80 g |
| Γερμανία | 330 | 0,10 g | 0,82 g |
| ΗΠΑ | 384 | 0,12 g | 0,96 g |
| Πολωνία | 589 | 0,18 g | 1,47 g |
Με λόγια: στη Σουηδία (35 g/kWh) και τη Γαλλία (41 g) κανονικό prompt ~0,01 g CO2 και μακρύ έγγραφο ~0,1 g. Στον μέσο όρο ΕΕ (210 g) κανονικό ~0,06 g και μακρύ ~0,5 g. Στη Γερμανία (330 g) κανονικό ~0,1 g και μακρύ ~0,8 g. Η Πολωνία είναι η υψηλότερη στον πίνακα με 589 g, κανονικό ~0,18 g και μακρύ ~1,5 g. Οι ΗΠΑ είναι μέσα γιατί πολλά νούμερα ChatGPT βγήκαν εκεί. Με 384 g κανονικό ~0,12 g και μακρύ ~1 g.
Στη Γερμανία, η υπηρεσία περιβάλλοντος λέει παρόμοια για 2025: CO2 παραγωγής 344 g/kWh και CO2 ισοδύναμο αλυσίδας 406 g. Electricity Maps για την πραγματική κατανάλωση στη Γερμανία 2025: 335 g, με ώρες ~100 g–~600 g.
Τι ισχύει για το DentroChat;
Μέχρι τώρα όλα ήταν για μεγάλα μοντέλα όπως GPT-4o. Η Epoch υπέθεσε ~100 δισεκατομμύρια παράμετροι ανά token, αλλά το DentroChat συχνά χρησιμοποιεί μικρότερα μοντέλα. Είναι «mixture of experts»: το μοντέλο είναι μεγάλο, αλλά μόνο ένα μικρό κομμάτι δουλεύει ανά token. Το DeepSeek V4 Flash ~13 δισ. παράμετροι ανά token, GLM 5.3 Flash ~18 δισ. και Qwen 3.8 Flash Next ~6 δισ..
Λιγότερες ενεργές παράμετροι σημαίνουν λιγότερο ρεύμα ανά token και λιγότερο CO2 ανά token. Το ML.ENERGY leaderboard το μέτρησε σε δικές τους GPUs. Qwen με 22 δισ. ενεργές παράμετροι ~0,12 Wh ανά 1.000 tokens γραμμένα. DeepSeek V3.1 με 37 δισ. ~0,37 Wh. Μόνο κάρτες γραφικών, βάλαμε ψύξη και υπόλοιπο server. Τα μοντέλα μας μικρότερα από και τα δύο, η εκτίμησή μας:
| Ανά 1.000 tokens | Ενεργές παράμετροι / token | Γραμμένα | Ανάγνωση, φρέσκα | Ανάγνωση, cache | CO2 ανά 1.000 γραμμένα, μέσος ΕΕ |
|---|---|---|---|---|---|
| GPT-4o (υπόθεση Epoch) | ~100 δισ. | ~0,6 Wh | ~0,2 Wh | ~0,13 g | |
| Μοντέλα DentroChat (εκτίμησή μας) | 6–18 δισ. | 0,05–0,4 Wh | 0,01–0,07 Wh | 0,001–0,007 Wh | 0,01–0,08 g |
Με λόγια: για GPT-4o, τα νούμερα Epoch ~0,6 watt-ώρες ανά 1.000 tokens που γράφει το μοντέλο και ~0,2 ανά 1.000 που διαβάζει. Για τα μοντέλα στο DentroChat εκτιμούμε 0,05–0,4 watt-ώρες ανά 1.000 γραμμένα και 0,01–0,07 ανά 1.000 ανάγνωση. Αν το κείμενο διαβάστηκε πριν λίγα λεπτά, είναι σε cache, τότε ~ένα δέκατο. Στο μέσο δίκτυο ΕΕ, 1.000 γραμμένα tokens ~0,13 g CO2 για GPT-4o και 0,01–0,08 g για τα δικά μας.
Τα prompts μας όμως μεγαλύτερα από το «κανονικό prompt» των μελετών. Κάθε μήνυμα στέλνει στο μοντέλο τις οδηγίες και τις περιγραφές εργαλείων, ήδη ~3k tokens. Πάνω μνήμη, chat μέχρι τώρα, αρχεία ή αποτελέσματα web search. Όταν το μοντέλο χρησιμοποιεί εργαλείο, ξαναδιαβάζει όλα. Μπορεί πρώτα να αποφασίσει web search και μετά να διαβάσει όλο το chat μαζί με τα αποτελέσματα για να γράψει την απάντηση. Ένα μήνυμά σου μπορεί να σημαίνει πολλές εκτελέσεις.
Όλοι οι αριθμοί στον πίνακα κάτω είναι ανά μήνυμα που στέλνεις. Αν ένα μήνυμα έτρεξε το μοντέλο πολλές φορές, τα αθροίσαμε σε μία γραμμή.
Κοιτάξαμε τα logs χρήσης και μετρήσαμε tokens (φυσικά δεν διαβάζουμε τι γράφεις). Ο πίνακας βασίζεται σε 606 prompts μιας ημέρας τον Οκτώβριο 2026. Ελέγξαμε και τα 21.700 prompts των 30 ημερών πριν, το median πολύ παρόμοιο:
| Prompt DentroChat | Ανάγνωση | εκ των οποίων cache | Γραμμένα | Ρεύμα (εκτίμησή μας) | CO2, μέσος ΕΕ | CO2, Γερμανία |
|---|---|---|---|---|---|---|
| Median | ~41k | ~30k | ~900 | 0,2–1,3 Wh | 0,04–0,3 g | 0,06–0,4 g |
| Top 10% | ~131k | ~66k | ~4.600 | 1–7 Wh | 0,2–1,4 g | 0,3–2,3 g |
Με λόγια: median prompt DentroChat διαβάζει ~41k tokens, ~30k cache γιατί στάλθηκαν λίγα λεπτά πριν. Γράφει ~900 tokens. Εκτιμούμε 0,2–1,3 watt-ώρες, ~0,04–0,3 g CO2 στο μέσο δίκτυο ΕΕ και 0,06–0,4 g στη Γερμανία. Top 10% διαβάζει 131k+ και γράφει 4.600+. ~1–7 watt-ώρες, CO2 0,2–1,4 g μέσος ΕΕ και 0,3–2,3 g Γερμανία.
Στη γραμμή Top 10% πήραμε το όριο κάθε στήλης ξεχωριστά. Σπάνια ένα πραγματικό prompt τα χτυπά όλα μαζί, η γραμμή είναι σκόπιμα στο βαρύ άκρο.
Υπάρχει και δουλειά στο background, ενημέρωση μνήμης, σύνοψη μακριών chats. Μερικές φορές το μοντέλο αργεί και αλλάζουμε σε backup στη μέση. Αυτά δεν είναι στον πίνακα. Αν τα μοιράσεις σε όλα τα prompts, μέσο prompt διαβάζει ~76k tokens (50k cache) και γράφει ~2k. ~0,4–3 watt-ώρες.
Άρα prompt DentroChat διαβάζει πολύ περισσότερα από το κανονικό prompt των μελετών. Κάθε token φθηνότερο. Median prompt DentroChat (0,2–1,3 Wh) κοντά στο κανονικό των μεγάλων (0,3 Wh) στο χαμηλό, και ~μισό το μακρύ έγγραφό τους (2,5 Wh) στο ψηλό.
Για σύγκριση: βραστήρας και μικρή διαδρομή
Χρειάζονται ~100 watt-ώρες θερμότητας για να βράσεις ένα λίτρο νερό από βρύση. Μέρος χάνεται, στην πρίζα ~110–125 watt-ώρες.
Median prompt DentroChat μικρό κομμάτι από αυτό. Παίρνουμε το high end της εκτίμησης, 1,3 watt-ώρες, ώστε η σύγκριση να μείνει στο βαρύ άκρο. ~90 prompts DentroChat για ένα λίτρο.
Για το αυτοκίνητο παίρνουμε τον μέσο όρο νέων αυτοκινήτων 2025 από τον Ευρωπαϊκό Οργανισμό Περιβάλλοντος: 96,7 g CO2/km σε lab. Ο μέσος όρος περιλαμβάνει ηλεκτρικά που μετράνε ως μηδενικές εκπομπές, οπότε βενζινοκίνητο στο δρόμο λίγο πιο «διψασμένο».
Για κάθε χιλιόμετρο με τέτοιο μέσο νέο αυτοκίνητο θα μπορούσες να στείλεις ~240 median prompts DentroChat στη Γερμανία (πάλι high end: 0,4 g CO2 ανά prompt). Στο μέσο δίκτυο ΕΕ το ίδιο prompt 0,3 g, ~320 prompts ανά χιλιόμετρο.
Η γλώσσα επηρεάζει τον αριθμό tokens
Διαφορετικές γλώσσες σπάνε την ίδια σελίδα σε διαφορετικό αριθμό tokens. Τρέξαμε τα άρθρα μας με tokenizers για και τις 17 γλώσσες που υποστηρίζει το DentroChat.
22 blog posts σε κάθε γλώσσα, ίδιο κείμενο κάθε φορά. Κύριος αριθμός από GPT-4o tokenizer. Εύρος min–max σε έξι tokenizers (GPT-4o, GPT-4, Mistral, Llama 3, Qwen 2.5, DeepSeek V3).
| Γλώσσα | Tokens ανά λέξη | Εύρος | Λέξεις σε 10k tokens |
|---|---|---|---|
| Αγγλικά | 1,3 | 1,3–1,4 | ~7.700 |
| Ισπανικά | 1,4 | 1,4–1,7 | ~7.200 |
| Πορτογαλικά | 1,4 | 1,4–1,7 | ~7.000 |
| Γαλλικά | 1,4 | 1,4–1,7 | ~6.900 |
| Ολλανδικά | 1,6 | 1,6–2,1 | ~6.300 |
| Ιταλικά | 1,7 | 1,7–1,9 | ~6.000 |
| Γερμανικά | 1,7 | 1,7–2,1 | ~5.800 |
| Νορβηγικά | 1,9 | 1,9–2,2 | ~5.400 |
| Σουηδικά | 1,9 | 1,9–2,3 | ~5.300 |
| Δανικά | 1,9 | 1,9–2,3 | ~5.300 |
| Ρουμανικά | 1,9 | 1,9–2,2 | ~5.300 |
| Κροατικά | 2,1 | 2,1–2,6 | ~4.800 |
| Πολωνικά | 2,2 | 2,2–2,6 | ~4.500 |
| Ελληνικά | 2,4 | 2,4–5,9 | ~4.200 |
| Εσθονικά | 2,5 | 2,5–3,1 | ~4.000 |
| Ουγγρικά | 2,6 | 2,5–3,1 | ~3.900 |
| Φινλανδικά | 2,8 | 2,8–3,5 | ~3.600 |
Με λόγια: στο GPT-4o tokenizer τα αγγλικά ~1,3 tokens ανά λέξη, 10k tokens ~7.700 αγγλικές λέξεις. Ισπανικά, πορτογαλικά, γαλλικά ~1,4. Ολλανδικά ~1,6, γερμανικά και ιταλικά ~1,7, 10k tokens ~5.800 γερμανικές. Βόρειες εκτός Φινλανδίας ~1,9. Εσθονικά ~2,5, φινλανδικά το υψηλότερο ~2,8, 10k tokens μόνο ~3.600 φινλανδικές.
Συχνά λένε μια γερμανική λέξη είναι 3 tokens. Σε σύγχρονους tokenizers μετράμε ~2. Τα ελληνικά έχουν μεγάλο εύρος γιατί παλιοί tokenizers χειρίζονται κακά το ελληνικό αλφάβητο.
Έτσι ελληνικό κείμενο ίδιου μήκους χρησιμοποιεί περισσότερα tokens και περισσότερο ρεύμα. Τα g CO2/Wh από το δίκτυο παραπάνω ίδια.
Τι δεν καλύψαμε
Εδώ είναι το ρεύμα για μία απάντηση σε ένα μήνυμα.
Η εκπαίδευση μοντέλου έγινε νωρίτερα μια φορά και μοιράζεται όσοι το χρησιμοποιούν. Να αποδώσεις κόστος εκπαίδευσης στο prompt σου θα ήταν μάντεμα, το αφήσαμε έξω.
Υπάρχει και κόστος κατασκευής καρτών γραφικών. Η ανάλυση της Nvidia για μία πλακέτα H100: 1312 kg CO2 ισοδύναμο για 8 GPUs, σε λίγα χρόνια λειτουργίας. Για ένα prompt μικρό κλάσμα, καλά κάτω από 1 g. Σε καθαρό δίκτυο όπως Σουηδία, το κλάσμα πλησιάζει το CO2 του ρεύματος. Στο γερμανικό δίκτυο το ρεύμα πολύ μεγαλύτερο.
Και νερό. Ο viral ισχυρισμός ότι η AI πίνει μια φιάλη νερό από εκτίμηση 2023 για GPT-3: ~500 ml για 20–50 απαντήσεις, σε ζεστά data centers ΗΠΑ με εξάτμιση. Η Google μέτρησε 0,26 ml median Gemini text prompt (~πέντε σταγόνες). Πολλά ευρωπαϊκά data centers ψύχουν με εξωτερικό αέρα και σχεδόν καθόλου νερό. Συμπεριλαμβανομένων Hetzner στη Γερμανία όπου φιλοξενείται το DentroChat και σουηδικά data centers όπου τρέχουν μερικά μοντέλα μας. Γράψαμε περισσότερα στο σπαταλάει νερό η AI; και πιο αναλυτικά γιατί τα viral νούμερα νερού παραπλανούν.
Και πρακτικό: στο ίδιο chat το μακρύ έγγραφο συνήθως κρατιέται στη μνήμη λίγα λεπτά, το επόμενο μήνυμα επεξεργάζεται κυρίως το νέο κείμενο. OpenAI και Anthropic μιλούν για caches που λήγουν μετά ~5–10 λεπτά αδράνειας. Αυτή η στήλη «cache» στον πίνακα DentroChat. Βοηθά και όταν το μοντέλο τρέχει πολλές φορές για ένα μήνυμα, η δεύτερη εκτέλεση ξαναχρησιμοποιεί ό,τι διάβασε η πρώτη.
Θα θέλαμε να σου δείχνουμε πραγματικό watt-ώρα για κάθε μήνυμα στο DentroChat, το καλύτερο EU AI chat. Για αυτό οι providers θα έπρεπε να μας δίνουν την ενέργεια ανά αίτημα, οι περισσότεροι δεν το κάνουν ακόμα.
Μέχρι τότε, αυτή είναι η καλύτερη προσέγγισή μας. Σε μεγάλα μοντέλα όπως GPT-4o, κανονικό prompt ~0,3 watt-ώρες και μακρύ έγγραφο ~2,5. Median prompt DentroChat με μικρότερα μοντέλα ~0,2–1,3 watt-ώρες. Στο μέσο δίκτυο ΕΕ το πολύ ~0,3 g CO2.