Ist dein KI-Chat verschlüsselt? ChatGPT, Lumo und DentroChat
Vor einiger Zeit hat sich ein DentroChat-Nutzer bei uns gemeldet:
Lumo behauptet, dass alle Unterhaltungen verschlüsselt werden. Macht DentroChat dasselbe oder gibt es einen anderen Ansatz?
Diese Frage hat mich ein bisschen angespornt, denn ich habe damals meine Bachelorarbeit über Kryptografie geschrieben, und ich wollte meine Gedanken endlich mal ordentlich aufschreiben. Meine Antwort wurde ziemlich lang und technisch. Falls dir manches zu dicht wird, lass diesen Artikel am besten in Lumo oder DentroChat einfügen und dir von einer KI einfacher erklären :-)
Um richtig zu beantworten, wie verschlüsselter KI-Chat funktioniert, schauen wir uns zuerst an, wie die Verschlüsselung bei Proton funktioniert, dann Lumo, und danach, wie DentroChat und ChatGPT es machen.
Wie die Zero-Knowledge-Verschlüsselung von Proton funktioniert
Wir sind große Fans des Proton-Ökosystems und nutzen es seit Jahren aktiv für VPN, E-Mails, Videoanrufe und mehr.
Der große Reiz von Proton ist das Zero-Knowledge-Prinzip. Aus deinem Account-Passwort werden öffentlich-private Schlüsselpaare abgeleitet, die für jeden Nutzer einzigartig sind. Mit dem privaten Schlüssel werden unsere E-Mails, Drive-Inhalte usw. verschlüsselt. Nur der Nutzer, also wir, kann die eigenen Daten auf dem lokalen Gerät entschlüsseln. Proton-Mitarbeiter können unsere Daten nicht entschlüsseln, weil sie nie Zugriff auf unseren privaten Schlüssel bekommen.
Der Vorteil: Selbst wenn die NSA auf einem Proton-Server „sitzt“, kommt sie nicht an unsere Daten (zumindest solange alle anderen Sicherheitsannahmen gelten). Der Nachteil: Wenn wir jemals unser Proton-Passwort und die Backup-Codes verlieren und keine Wiederherstellungsmethode eingerichtet haben, kann Proton unsere Daten nicht wiederherstellen.
Wenn du von Grund auf verstehen willst, wie Verschlüsselung mit öffentlichen und privaten Schlüsseln funktioniert, ist dieses YouTube-Video zur Public-Key-Kryptografie großartig. Als ich es im ersten Studienjahr gesehen habe, hat es mich total umgehauen!
Lumo: Warum ein LLM das Bild verändert
Lumo unterscheidet sich grundsätzlich von anderen Proton-Diensten, und zwar wegen der Art, wie Large Language Models (LLMs) funktionieren. Um eine Antwort von einem KI-Modell zu bekommen, muss die Eingabe im Klartext, also unverschlüsselt, an das Modell übergeben werden. (Es gibt Ansätze, die das stärker verschlüsselt machen, dazu weiter unten mehr.)
Wenn du ein LLM lokal auf deinem eigenen Computer laufen lassen würdest, würde der klassische Proton-Ansatz von oben weiterhin funktionieren: Die Daten werden lokal auf deinem Gerät entschlüsselt, an dein lokales LLM übergeben, die Antwort wird erzeugt und die Daten werden lokal wieder verschlüsselt. So läuft es, wenn du lokale Modelle mit Tools wie Ollama betreibst.
Das Problem: Die besten LLMs brauchen sehr starke Rechner, was auf einem durchschnittlichen Verbraucher-PC schlicht nicht machbar ist. Also muss das LLM auf einem Proton-Server laufen, und deine Daten müssen entschlüsselt werden, bevor sie an das Proton-LLM übergeben werden.
Was passiert, wenn du Lumo eine Nachricht schickst
Wenn du Lumo nutzt, läuft es so ab (wie in Protons Lumo-Sicherheitsmodell dokumentiert):
- Du entschlüsselst deinen Chatverlauf lokal auf deinem Gerät.
- Du fügst eine neue Nutzernachricht hinzu.
- Der gesamte Nachrichtenverlauf, zusammen mit deiner neuen Nachricht, wird mit dem öffentlichen Schlüssel des Proton-Servers verschlüsselt, auf dem das LLM läuft.
- Deine verschlüsselten Daten kommen auf dem Proton-Server an und werden mit dem privaten Schlüssel des Servers entschlüsselt. Die entschlüsselten Daten werden an das LLM übergeben, und eine Antwort wird erzeugt.
- Die erzeugte Antwort wird erneut verschlüsselt und an dich zurückgeschickt.
- Du entschlüsselst sie auf deinem Gerät und liest die Antwort.
Unter den gegebenen Bedingungen ist das ein sehr solider Ansatz.
Aber: Der Ansatz ist während der Inferenz nicht mehr Zero-Knowledge. Wenn die Schweizer Polizei, die NSA oder ein abtrünniger Proton-Mitarbeiter im Proton-Server mithört, wo deine Daten vor der Übergabe an das LLM entschlüsselt werden, können sie deine Daten lesen. Lumo nutzt nicht Ende-zu-Ende-Verschlüsselung (E2EE) wie die anderen Proton-Dienste, sondern etwas, das Proton Verschlüsselung von Nutzer zu Lumo (User-to-Lumo Encryption, U2L) nennt. Stark ist Lumo dort, wo dein gespeicherter Chatverlauf im Ruhezustand mit deinem Schlüssel verschlüsselt wird, sodass später niemand bei Proton deine alten Unterhaltungen lesen kann.
Wie DentroChat es macht
Wir haben versucht, eine echte Ende-zu-Ende-Verschlüsselung für DentroChat zu entwickeln, und sind auf eine Architektur gekommen, die dem sehr nahekommt. Leider war es für uns finanziell aber noch nicht machbar, sie umzusetzen (noch nicht).
Unser aktueller Ansatz ist die klassische Verschlüsselung, die die meisten modernen Apps verwenden: Verschlüsselung während der Übertragung und Verschlüsselung im Ruhezustand:
- Wenn wir dir deine Daten schicken oder du DentroChat deine Daten schickst, wird dieser Datenverkehr mit TLS verschlüsselt übertragen (TLS nutzt öffentlich-private Schlüssel, um die verschlüsselte Verbindung aufzubauen).
- Wenn deine Daten auf unseren Servern in Deutschland gespeichert werden, sind sie im Ruhezustand verschlüsselt (das konfigurieren und verwalten wir selbst, weil Standard-Hosting-Anbieter Festplatten standardmäßig nicht im Ruhezustand verschlüsseln). Wenn ein Angreifer die Festplatte unserer Server kopiert, bekommt er nur verschlüsselte Daten.
Wir haben uns für diesen Ansatz entschieden, weil die KI in dem Moment, in dem sie deine Anfrage beantwortet, dieselbe grundlegende Vertrauensannahme hat wie Lumo: Du musst uns vertrauen, dass wir deine Daten während der Verarbeitung nicht lesen. Unser aktueller Ansatz war deutlich einfacher aufzusetzen, während Protons Ansatz ausgefeilter ist und Angreifern bei gespeicherten Chatverläufen mehr Hürden in den Weg stellt. Wir könnten irgendwann auch diesen Weg gehen, wenn wir einen klaren Vorteil darin sehen. Im Moment ist DentroChats Ansatz sicher, solide und über die Jahre von vielen Anwendungen praxiserprobt.
Wie ChatGPT deine Unterhaltungen verschlüsselt (und wo der Haken liegt)
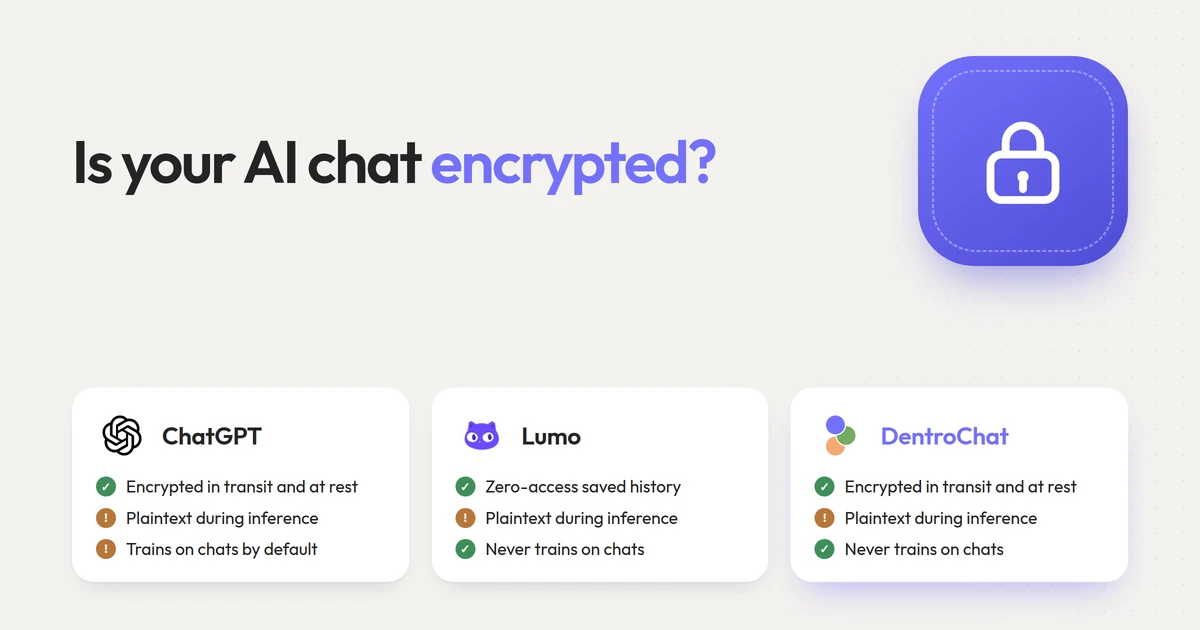
Auf dem Papier nutzt ChatGPT dieselben kryptografischen Bausteine wie DentroChat und die meiste Cloud-Software: Verschlüsselung während der Übertragung (TLS) zwischen deinem Browser und den Servern von OpenAI und Verschlüsselung im Ruhezustand (AES-256) auf deren Festplatten. ChatGPT nutzt ebenfalls keine Ende-zu-Ende-Verschlüsselung, weil die GPUs von OpenAI deine Anfrage ebenfalls im Klartext brauchen, um eine Antwort zu erzeugen.
Der Unterschied bei ChatGPT liegt darin, wer die Schlüssel hat und was OpenAI mit deinen Daten machen darf, nachdem sie entschlüsselt wurden:
- Modelltraining und manuelle Prüfung: Bei ChatGPT Free und Plus werden deine entschlüsselten Unterhaltungen standardmäßig zum Training künftiger OpenAI-Modelle verwendet. Stichprobenartig ausgewählte Chats können außerdem von menschlichen Prüfern gelesen werden, sofern du das nicht in den Einstellungen manuell deaktivierst. Weder Lumo noch DentroChat trainieren jemals mit deinen Chats.
- Speicherung nach dem Löschen: Selbst wenn du einen Chat löschst oder den Modus „Temporärer Chat“ von ChatGPT verwendest, behält OpenAI eine Kopie auf den eigenen Servern, und zwar bis zu 30 Tage (hier haben wir alle Details aufgeschlüsselt).
- Zugriff nach dem US CLOUD Act: Weil OpenAI die Entschlüsselungsschlüssel für deine gespeicherten Chats hält und ein US-Unternehmen ist, können US-Behörden den Zugriff nach dem US CLOUD Act erzwingen. Selbst dann, wenn dein Workspace auf EU-Datenresidenz eingestellt ist!
| ChatGPT | Proton Lumo | DentroChat | |
|---|---|---|---|
| Verschlüsselt während der Übertragung (TLS) | Ja | Ja | Ja |
| Verschlüsselt im Ruhezustand | Ja (OpenAI hält die Schlüssel) | Ja (Zero-Access, du hältst die Schlüssel) | Ja (DentroChat hält die Schlüssel) |
| Ende-zu-Ende-verschlüsselt während der KI-Inferenz | Nein (Klartext auf dem Server) | Nein (Klartext auf dem Server, U2L) | Nein (Klartext auf dem Server) |
| Trainiert KI-Modelle mit deinen Chats | Ja, standardmäßig (Opt-out möglich) | Nie | Nie |
| Unterliegt dem US CLOUD Act | Ja | Nein für Chats (US für Abrechnung/Support) | Nein (100 % EU-/Schweizer Stack) |
Zwei Wege zu (fast) echter Ende-zu-Ende-Verschlüsselung für KI
Kann man ein LLM in der Cloud überhaupt betreiben, ohne dass der Betreiber den Klartext deiner Anfrage sieht? Dafür gibt es zwei Ansätze für echte E2EE.
1. Homomorphe Verschlüsselung
Homomorphe Verschlüsselung ist ein faszinierendes Forschungsfeld. Sie ermöglicht es, Berechnungen direkt auf verschlüsselten Daten auszuführen.
Ein Beispiel: Du verschlüsselst die Zahl 12, und ein anderer Nutzer verschlüsselt die Zahl 17. Beide verschlüsselten Zahlen werden durch eine verschlüsselte Addition zusammengerechnet. Das Ergebnis ist die verschlüsselte Zahl 29, und nur du und der andere Nutzer könnt sie entschlüsseln und herausfinden, dass das Ergebnis 29 ist. Der Server, der die Rechnung ausgeführt hat, wusste nie, dass es um 12, 17 oder 29 ging.
Dieses Beispiel ist einfach, es kann aber auch bei LLMs funktionieren. Dabei gibst du verschlüsselte Daten in das LLM ein, das LLM liefert eine verschlüsselte Antwort, und nur der Nutzer kann die Antwort entschlüsseln. Hier wird intensiv akademisch geforscht, zum Beispiel in diesem aktuellen Paper zur verschlüsselten LLM-Inferenz (Cachemir).
Das Problem bei homomorpher Verschlüsselung ist, dass sie extrem rechenintensiv und damit sehr langsam ist. Selbst mit den jüngsten Beschleunigungen rechnet man mit etwa 100 Sekunden GPU-Zeit pro erzeugtem Token. Du müsstest also 30 Minuten auf eine einfache Antwort auf „Was ist die Hauptstadt von Spanien?“ warten.
2. NVIDIA H100/H200 Confidential-Computing-GPUs (TEE)
Der zweite Ansatz nutzt NVIDIA H100/H200 Confidential-Computing-GPUs mit einer Trusted Execution Environment (TEE).
Das funktioniert so: Die GPU hat ein eigenes öffentlich-privates Schlüsselpaar, das fest in ihre Hardware eingebaut ist. Es wird einmal bei der Herstellung der GPU erzeugt, und danach lässt sich der private Schlüssel von außen nicht mehr auslesen, nicht einmal von der Person, der das Server-Rack gehört.
Das ist großartig, denn du kannst deine Daten jetzt mit dem öffentlichen Schlüssel der GPU verschlüsseln und an den Server schicken. Die GPU entschlüsselt sie innerhalb ihrer eigenen Hardware-Enklave mit ihrem privaten Schlüssel, übergibt sie an das LLM, das in der GPU läuft, verschlüsselt die Antwort erneut und schickt sie an dich zurück.
Auf diese Weise erreichen wir nahezu echte E2EE. Der einzige verbleibende Angriffsvektor auf Hardware liegt im Herstellungsschritt: Wenn die NSA alle privaten Schlüssel aufgezeichnet hat, während diese NVIDIA-GPUs in der Fabrik hergestellt wurden, könnte sie den Datenverkehr theoretisch trotzdem später abfangen und entschlüsseln, sobald die GPU im Einsatz ist. Eine NVIDIA-GPU mit TEE ist allerdings eine sehr starke Sicherheitsannahme.
Für DentroChat hatten wir zwei Optionen: Solche GPUs selbst kaufen oder einen europäischen Anbieter finden, der sie anbietet. Die erste Option war für uns zu teuer: Eine einzelne H100 kostet rund 40.000 €, und um große Open-Weights-Modelle wie die, die wir bei DentroChat einsetzen, zu betreiben, bräuchten wir acht davon. Als selbstfinanziertes Unternehmen war das damals nicht möglich. Einen europäischen Anbieter mit Confidential-Computing-GPUs zu finden, war vor einem halben Jahr ebenfalls nicht möglich. Das ist aber der realistischste Weg nach vorn, und wir halten ständig Ausschau nach europäischen KI-Infrastrukturanbietern, die das unterstützen.
Warum wir DentroChat neben Lumo für eine starke Wahl halten
Auch ohne Zero-Access-Verschlüsselung für den gespeicherten Verlauf gibt es einige Gründe, warum sich viele Nutzer für DentroChat statt Lumo entscheiden:
- Bessere KI-Modelle: Als wir Lumo zuletzt getestet haben, war die Antwortqualität ziemlich enttäuschend und langsam. Bei DentroChat bekommst du Zugriff auf die besten Open-Source-Modelle und ein maßgeschneidertes Agenten-Setup im Hintergrund.
- Keine US-Unterauftragsverarbeiter im gesamten Stack: Sowohl Lumo als auch DentroChat betreiben ihre KI-Inferenz auf europäischen und Schweizer Servern. Lumo leitet Abrechnung und Kundensupport aber weiterhin über US-Unternehmen (wie Stripe und Zendesk). Bei DentroChat nutzen wir an keiner Stelle US-Unterauftragsverarbeiter. Den gesamten Stack kannst du auf unserer Seite Unterauftragsverarbeiter nachprüfen.
Wenn du beide Dienste genauer vergleichen willst, schau dir unseren ausführlichen Lumo-Alternativen-Test, unseren Leitfaden zu privatem KI-Chat oder an, wie sich europäische ChatGPT-Alternativen schlagen. Und wenn du eine technische Frage wie diese hast, scheu dich nicht, uns über den Feedback-Button in DentroChat zu schreiben!
Häufig gestellte Fragen
Ist ChatGPT Ende-zu-Ende-verschlüsselt?
Nein. OpenAI verschlüsselt deine Unterhaltungen während der Übertragung (TLS) und im Ruhezustand auf seinen Servern, was für Cloud-Apps der übliche Mindeststandard ist. Da das LLM Klartext braucht, um eine Antwort zu erzeugen, entschlüsseln die Server von OpenAI deine Anfrage für die Verarbeitung. Sofern du keinen Business-Tarif nutzt oder dich nicht ausdrücklich abmeldest, können Unterhaltungen von Privatnutzern außerdem für das Training von Modellen verwendet werden.
Ist Proton Lumo Ende-zu-Ende-verschlüsselt?
Nicht Ende-zu-Ende. Lumo nutzt, was Proton Verschlüsselung von Nutzer zu Lumo (User-to-Lumo, U2L) nennt: Dein gespeicherter Chatverlauf ist mit Zero-Access-Verschlüsselung gesichert, sodass Proton deine alten Chats nicht lesen kann, und deine Anfrage ist bis zum Inferenz-Server durchgehend verschlüsselt. Der GPU-Server von Proton muss deine Nachricht aber trotzdem im Arbeitsspeicher entschlüsseln, um sie an das LLM zu übergeben.
Wie verschlüsselt DentroChat meine Unterhaltungen?
DentroChat verschlüsselt den gesamten Datenverkehr während der Übertragung mit TLS und speichert deine Unterhaltungen und Dateien mit selbst verwalteter Verschlüsselung im Ruhezustand auf europäischen Servern in Deutschland und Frankreich. Wie bei Lumo und ChatGPT müssen Anfragen während der Inferenz im Arbeitsspeicher des Servers entschlüsselt werden, damit das KI-Modell antworten kann. Und wir trainieren niemals mit deinen Daten.
Kann ein KI-Chat jemals wirklich Ende-zu-Ende-verschlüsselt sein?
Ja, entweder indem du ein kleines Modell lokal auf deinem eigenen Computer betreibst oder in der Cloud mit homomorpher Verschlüsselung oder NVIDIA-Confidential-Computing-GPUs (TEEs). Heute ist homomorphe Verschlüsselung für interaktiven Chat noch viel zu langsam, während Confidential-Computing-GPUs der vielversprechendste Weg nach vorn sind, sobald europäische Hosting-Anbieter sie flächendeckend anbieten.