Wie viel Strom verbraucht eine KI-Anfrage?
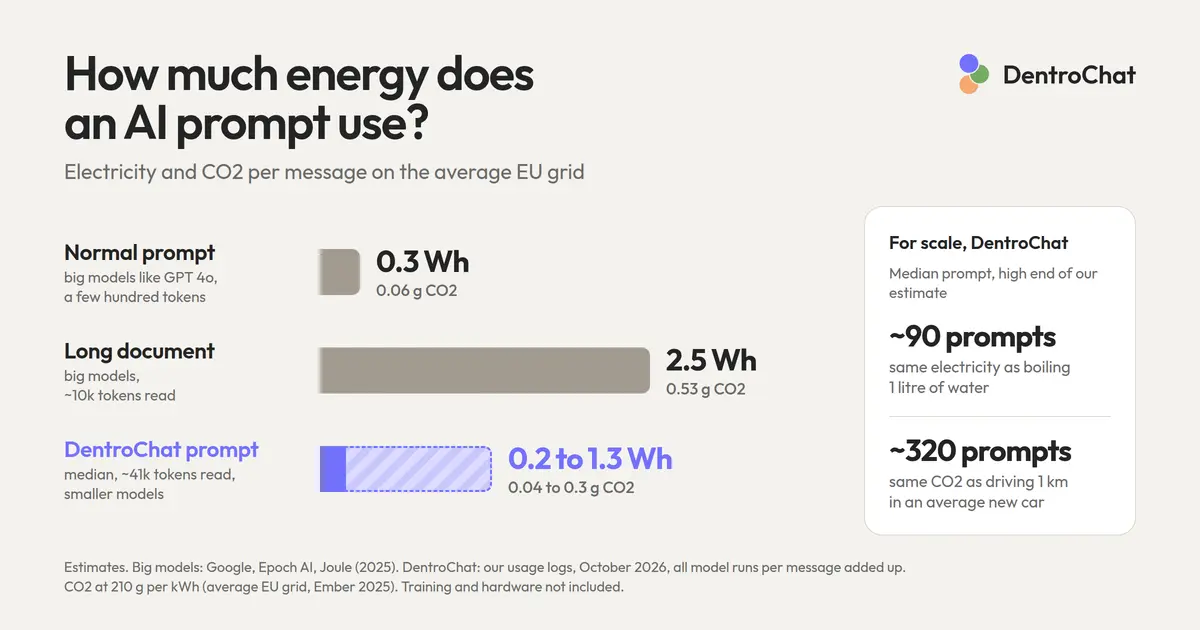
Nutzer von DentroChat, unserem EU KI Assistenten, fragen uns ab und zu, wie viel Strom ihre Nachrichten kosten. Die Frage ist berechtigt, und gern würden wir dir im Produkt eine Zahl zeigen. Die Cloud-Anbieter geben den Verbrauch pro Anfrage aber meist noch nicht an, deshalb haben wir uns mit öffentlicher Forschung so gut wie möglich angenähert.
In diesem Artikel sind zwar keine Labormessungen von DentroChat selbst, aber Werte aus Studien, die wir gegeneinander gehalten haben. Schreib uns gern, solltest du bessere Quellen kennen.
Strom für eine normale Anfrage
Typisch stellst du eine Frage und bekommst eine Antwort mit ein paar hundert Tokens. Ein Token ist ein Wortteil, bei kurzen Wörtern manchmal auch ein ganzes Wort.
Google hat das gemessen. Im Mai 2025 lag der mediane Text-Prompt in den Gemini-Apps bei 0,24 Wattstunden, inklusive Chip und Kühlung für die ganze Halle im Rechenzentrum. Für den medianen Prompt rechnete Google mit 0,03 Gramm CO2, bezogen auf den Strommix von Google.
Epoch AI schätzte im Februar 2025 eine typische ChatGPT-Antwort auf grob 0,3 Wattstunden, ausgehend von etwa 500 Tokens Antwort, wobei sie selbst meinen, die Zahl liege etwas hoch.
Im April 2026 erschien ein Paper in Joule mit Daten aus Deployments von 2025, und für ein großes Modell liegt der Median bei 0,31 Wattstunden. Sam Altman schrieb im Juni 2025 von etwa 0,34 Wattstunden pro durchschnittlicher ChatGPT-Anfrage.
Für eine typische Anfrage würden wir deshalb 0,3 Wattstunden sagen, weil Messung und Schätzungen ungefähr am selben Fleck landen.
Strom bei längeren Anfragen
Ein langes Dokument ist mehr Arbeit, weil viel gelesen werden muss.
Epoch AI schätzte für solche Anfragen etwa 2,5 Wattstunden bei 10.000 Tokens Input. Damit klar ist, was das in Wörtern heißt, haben wir Tokens auf unseren eigenen Seiten gezählt. Die Zahlen hier kommen vom GPT-4o-Tokenizer: etwa 7.700 englische Wörter und etwa 5.800 deutsche Wörter, also ein langer Artikel oder ein Chat mit vielen Nachrichten. Weiter unten haben wir dieselben Seiten auch durch fünf weitere Tokenizer geschickt, und die Tabelle zeigt, wie weit die vom GPT-4o-Tokenizer abweichen.
Jegham et al. haben für so einen Prompt mit 10.000 rein und 1.500 raus eine eigene Schätzung gemacht und je nach Modell etwa 1,4 bis 2,9 Wattstunden erhalten, also ungefähr dieselbe Größenordnung wie bei Epoch.
Wenn das Modell lange nachdenkt und Tausende Tokens schreibt, bevor die Antwort kommt, steigt der Verbrauch wieder. Im Joule-Paper liegt eine Antwort mit etwa 5.000 Tokens bei ungefähr 4 Wattstunden, also „Reasoning“, bei dem das Modell viel nachrechnet.
Hier alles in einer Tabelle. Gemeint sind große Modelle wie GPT-4o und Gemini:
| Art der Anfrage | Tokens, grob | Strom | Quelle |
|---|---|---|---|
| Normale Anfrage | kurze Frage, ein paar hundert Tokens Antwort | ~0,3 Wh | Google, Epoch AI, Joule-Paper, Altman |
| Langes Dokument | ~10k rein, 500 bis 1.500 raus | ~2,5 Wh (1,4 bis 2,9) | Epoch AI, Jegham et al. |
| Reasoning-Antwort | ~5k raus | ~4 Wh | Joule-Paper |
Kurz: Eine normale Anfrage braucht etwa 0,3 Wattstunden. Ein langes Dokument mit etwa 10.000 Tokens braucht etwa 2,5 Wattstunden, je nach Modell zwischen 1,4 und 2,9. Eine lange Reasoning-Antwort mit etwa 5.000 Tokens liegt bei etwa 4 Wattstunden.
CO2 je nach Stromnetz
Der Strom für dasselbe Modell ist ungefähr überall gleich, wo die Server stehen, aber das CO2 hängt vom örtlichen Stromnetz ab.
Wir haben die Zahlen von Ember für 2025 genommen, einsehbar bei „Our World in Data“. Das sind Lebenszykluswerte: Sie zählen die Lieferkette des Stroms obendrauf auf die Emissionen des Kraftwerks, gemessen in Gramm CO2-Äquivalent pro Kilowattstunde.
Damit haben wir unsere zwei Größen multipliziert: 0,3 Wh für eine normale Anfrage und 2,5 Wh für ein langes Dokument:
| Stromnetz | g CO2e pro kWh | Normale Anfrage | Langes Dokument |
|---|---|---|---|
| Norwegen | 28 | 0,01 g | 0,07 g |
| Schweden | 35 | 0,01 g | 0,09 g |
| Frankreich | 41 | 0,01 g | 0,10 g |
| Finnland | 57 | 0,02 g | 0,14 g |
| Dänemark | 114 | 0,03 g | 0,29 g |
| Österreich | 117 | 0,04 g | 0,29 g |
| Spanien | 154 | 0,05 g | 0,38 g |
| EU-Durchschnitt | 210 | 0,06 g | 0,53 g |
| Niederlande | 254 | 0,08 g | 0,63 g |
| Italien | 285 | 0,09 g | 0,71 g |
| Estland | 319 | 0,10 g | 0,80 g |
| Deutschland | 330 | 0,10 g | 0,82 g |
| USA | 384 | 0,12 g | 0,96 g |
| Polen | 589 | 0,18 g | 1,47 g |
Kurz: In Schweden (35 g pro kWh) und Frankreich (41 g) kostet eine normale Anfrage etwa 0,01 Gramm CO2 und ein langes Dokument etwa 0,1 Gramm. Beim EU-Durchschnitt (210 g) sind es 0,06 Gramm bzw. 0,5 Gramm, in Deutschland (330 g) 0,1 Gramm bzw. 0,8 Gramm. Polen hat mit 589 g den höchsten Wert in der Tabelle, dort etwa 0,18 Gramm pro normaler Anfrage und etwa 1,5 Gramm pro langem Dokument. Die USA stehen drin, weil viele ChatGPT-Zahlen von dort kommen, und bei 384 g sind es 0,12 Gramm bzw. etwa 1 Gramm.
Das Umweltbundesamt sagt für 2025 Ähnliches: 344 g CO2 pro Kilowattstunde aus der Erzeugung und 406 g CO2-Äquivalent mit Lieferkette. Electricity Maps setzen den Stromverbrauch in Deutschland 2025 auf 335 g, wobei einzelne Stunden zwischen etwa 100 g und 600 g schwanken.
Was gilt für DentroChat?
Bisher galten große Modelle wie GPT-4o, für die Epoch von etwa 100 Milliarden Parametern pro Token ausging. DentroChat nutzt oft kleinere „Mixture of Experts“-Modelle: Das Gesamtmodell ist groß, aber pro Token arbeitet nur ein kleiner Teil. DeepSeek V4 Flash nutzt etwa 13 Milliarden Parameter pro Token, GLM 5.3 Flash und Qwen 3.8 Flash Next etwa 18 bzw. 6 Milliarden.
Weniger aktive Parameter bedeuten weniger Strom und damit weniger CO2 pro Token, und das ML.ENERGY Leaderboard hat das an echten GPUs gemessen. Ein Qwen-Modell mit 22 Milliarden aktiven Parametern brauchte etwa 0,12 Wh pro 1.000 geschriebene Tokens, DeepSeek V3.1 mit 37 Milliarden etwa 0,37 Wh (nur Grafikkarten, dazu Kühlung und der Rest der Server). Unsere Modelle sind kleiner als beide, deshalb unsere Schätzung:
| Pro 1.000 Tokens | Aktive Parameter pro Token | Geschrieben | Gelesen, frisch | Gelesen, gecacht | CO2 pro 1.000 geschrieben, EU-Durchschnitt |
|---|---|---|---|---|---|
| GPT-4o (Epoch-Annahme) | ~100 Mrd. | ~0,6 Wh | ~0,2 Wh | ~0,13 g | |
| DentroChat-Modelle (unsere Schätzung) | 6 bis 18 Mrd. | 0,05 bis 0,4 Wh | 0,01 bis 0,07 Wh | 0,001 bis 0,007 Wh | 0,01 bis 0,08 g |
Kurz: Bei GPT-4o ergeben Epochs Zahlen etwa 0,6 Wattstunden pro 1.000 geschriebene Tokens. Pro 1.000 gelesene Tokens sind es etwa 0,2. Bei den Modellen in DentroChat schätzen wir 0,05 bis 0,4 Wattstunden pro 1.000 geschriebene Tokens. Pro 1.000 gelesene liegen wir bei 0,01 bis 0,07. Wurde der Text vor ein paar Minuten schon gelesen, liegt er im Cache. Dann kostet es ungefähr ein Zehntel davon. Beim EU-Durchschnittsnetz sind 1.000 geschriebene Tokens etwa 0,13 Gramm CO2 bei GPT-4o. Bei unseren Modellen 0,01 bis 0,08 Gramm.
Unsere Prompts sind aber größer als die „normale Anfrage“ in den Studien, weil jede Nachricht dem Modell seine Anweisungen und Tool-Beschreibungen mitschickt (schon etwa 3.000 Tokens) und obendrauf Memory, bisheriger Chat sowie manchmal Dateien oder Websuchergebnisse kommen. Nutzt das Modell ein Tool, liest es alles nochmal, und es kann sich zuerst für eine Websuche entscheiden und danach den ganzen Chat plus Suchergebnisse lesen, bevor es antwortet. Eine Nachricht von dir kann deshalb mehrere Modell-Läufe bedeuten.
Alle Zahlen in der Tabelle unten gelten pro Nachricht, die du schickst, und wenn eine Nachricht das Modell mehrfach laufen ließ, haben wir die Läufe in einer Zeile zusammengerechnet. Dafür haben wir in unsere Nutzungslogs geschaut und Tokens gezählt (was du schreibst, lesen wir natürlich nicht). Die Tabelle basiert auf 606 beantworteten Prompts an einem Tag im Oktober 2026, und die 21.700 Prompts der 30 Tage davor hatten einen sehr ähnlichen Median:
| DentroChat-Anfrage | Gelesen | davon gecacht | Geschrieben | Strom (unsere Schätzung) | CO2, EU-Durchschnitt | CO2, Deutschland |
|---|---|---|---|---|---|---|
| Median | ~41k | ~30k | ~900 | 0,2 bis 1,3 Wh | 0,04 bis 0,3 g | 0,06 bis 0,4 g |
| Obere 10 % | ~131k | ~66k | ~4.600 | 1 bis 7 Wh | 0,2 bis 1,4 g | 0,3 bis 2,3 g |
Kurz: Der mediane DentroChat-Prompt liest etwa 41.000 Tokens. Davon sind etwa 30.000 gecacht. Sie wurden wenige Minuten vorher schon mitgeschickt. Geschrieben werden etwa 900 Tokens. Unsere Schätzung: 0,2 bis 1,3 Wattstunden. Im EU-Durchschnittsnetz sind das etwa 0,04 bis 0,3 Gramm CO2. In Deutschland 0,06 bis 0,4 Gramm. Die oberen 10 % lesen 131.000 Tokens oder mehr. Sie schreiben 4.600 Tokens oder mehr. Das sind etwa 1 bis 7 Wattstunden. CO2 liegt im EU-Durchschnitt bei 0,2 bis 1,4 Gramm. In Deutschland bei 0,3 bis 2,3 Gramm.
Bei der Zeile „Obere 10 %“ haben wir pro Spalte den 90.‑Perzentil-Wert genommen, und ein echter Prompt trifft selten alle Werte gleichzeitig, deshalb ist die Zeile absichtlich auf der schweren Seite.
Im Hintergrund läuft noch anderes, etwa Memory-Updates oder Zusammenfassungen langer Chats, und manchmal wechseln wir mittendrin auf ein Backup-Modell, wenn eins zu langsam ist. Diese Läufe stehen nicht in der Tabelle. Verteilt man sie auf alle Prompts, liest der Durchschnittsprompt etwa 76.000 Tokens (davon etwa 50.000 gecacht) und schreibt etwa 2.000 Tokens, insgesamt etwa 0,4 bis 3 Wattstunden.
Ein DentroChat-Prompt liest also deutlich mehr als die normale Anfrage in den Studien, ist pro Token aber günstiger, sodass der Median zwischen 0,2 und 1,3 Wh liegt: unten nahe an 0,3 Wh der großen Modelle, oben bei etwa der Hälfte ihres langen Dokuments mit 2,5 Wh.
Zum Vergleich: Wasserkocher und kurze Fahrten
Einen Liter Wasser von Leitungswärme bis zum Kochen brauchst du grob 100 Wattstunden Wärme. Weil jedoch ein Teil verloren geht, sind es an der Steckdose eher 110 bis 125 Wattstunden. Ein medianer DentroChat-Prompt ist davon nur ein kleiner Bruchteil, und wir nehmen die obere Kante unserer Schätzung mit 1,3 Wattstunden, damit der Vergleich auf der schweren Seite bleibt. So kommen wir auf etwa 90 DentroChat-Anfragen für einen Liter.
Beim Auto nehmen wir den Durchschnitt für Neuwagen 2025 der Europäischen Umweltagentur mit 96,7 g CO2 pro Kilometer laut Labortest, und im Durchschnitt stecken auch Elektroautos drin, die als null Abgas zählen, weshalb ein Benziner auf der Straße etwas mehr verbraucht. Pro Kilometer in so einem durchschnittlichen Neuwagen könntest du in Deutschland etwa 240 mediane DentroChat-Anfragen schicken (wieder obere Kante: 0,4 Gramm CO2 pro Anfrage), im EU-Durchschnittsnetz bei 0,3 Gramm pro Anfrage etwa 320 Anfragen pro Kilometer.
Sprache und Token-Anzahl
Verschiedene Sprachen zerlegen dieselbe Seite in unterschiedlich viele Tokens, deshalb haben wir unsere Artikel durch Tokenizer für alle 17 Sprachen gejagt, die DentroChat unterstützt. Grundlage sind 22 Blogposts in jeder Sprache (immer derselbe Text), und die Hauptzahl kommt vom GPT-4o-Tokenizer, die Spanne ist Minimum und Maximum über sechs Tokenizer (GPT-4o, GPT-4, Mistral, Llama 3, Qwen 2.5 und DeepSeek V3).
| Sprache | Tokens pro Wort | Spanne | Wörter in 10k Tokens |
|---|---|---|---|
| Englisch | 1,3 | 1,3 bis 1,4 | ~7.700 |
| Spanisch | 1,4 | 1,4 bis 1,7 | ~7.200 |
| Portugiesisch | 1,4 | 1,4 bis 1,7 | ~7.000 |
| Französisch | 1,4 | 1,4 bis 1,7 | ~6.900 |
| Niederländisch | 1,6 | 1,6 bis 2,1 | ~6.300 |
| Italienisch | 1,7 | 1,7 bis 1,9 | ~6.000 |
| Deutsch | 1,7 | 1,7 bis 2,1 | ~5.800 |
| Norwegisch | 1,9 | 1,9 bis 2,2 | ~5.400 |
| Schwedisch | 1,9 | 1,9 bis 2,3 | ~5.300 |
| Dänisch | 1,9 | 1,9 bis 2,3 | ~5.300 |
| Rumänisch | 1,9 | 1,9 bis 2,2 | ~5.300 |
| Kroatisch | 2,1 | 2,1 bis 2,6 | ~4.800 |
| Polnisch | 2,2 | 2,2 bis 2,6 | ~4.500 |
| Griechisch | 2,4 | 2,4 bis 5,9 | ~4.200 |
| Estnisch | 2,5 | 2,5 bis 3,1 | ~4.000 |
| Ungarisch | 2,6 | 2,5 bis 3,1 | ~3.900 |
| Finnisch | 2,8 | 2,8 bis 3,5 | ~3.600 |
Kurz: Beim GPT-4o-Tokenizer sind es auf Englisch etwa 1,3 Tokens pro Wort. 10.000 Tokens sind etwa 7.700 englische Wörter. Spanisch, Portugiesisch und Französisch liegen knapp dahinter bei etwa 1,4. Niederländisch etwa 1,6. Deutsch und Italienisch etwa 1,7. In 10.000 Tokens passen etwa 5.800 deutsche Wörter. Die nordischen Sprachen außer Finnisch liegen bei etwa 1,9. Estnisch etwa 2,5. Finnisch am höchsten mit etwa 2,8. In 10.000 Tokens passen nur etwa 3.600 finnische Wörter.
Oft heißt es, ein deutsches Wort sei drei Tokens, auf modernen Tokenizern messen wir eher zwei, und Griechisch hat die große Spanne, weil ältere Tokenizer das griechische Alphabet schlecht behandeln. Ein finnisches Dokument gleicher Länge braucht deshalb mehr Tokens und damit mehr Strom, während Gramm CO2 pro Wattstunde die vom Netz oben bleiben.
Was wir weggelassen haben
Hier geht es um den Strom für eine Antwort auf eine Nachricht.
Das Training des Modells war früher einmal und teilen sich alle, die das Modell nutzen, und den Trainingsanteil deinem Prompt zuzuordnen wäre Raten, deshalb fehlt er.
Dazu kommen die Grafikkarten selbst: Nvidia nennt für ein H100-Board 1.312 kg CO2-Äquivalent für acht GPUs, verteilt über ein paar Jahre Betrieb, sodass pro Prompt nur ein winziger Bruchteil anfällt, deutlich unter 1 Gramm. In einem sauberen Netz wie Schweden kann dieser Anteil an das CO2 des Stroms herankommen, im deutschen Netz überwiegt der Strom deutlich.
Und Wasser: Die virale Behauptung, KI trinke eine Flasche Wasser, stammt aus einer Schätzung von 2023 für GPT-3 (grob 500 ml für 20 bis 50 Antworten) für heiße US-Rechenzentren mit Verdunstungskühlung, während Google 0,26 ml für einen medianen Gemini-Text-Prompt maß, etwa fünf Tropfen. Viele europäische Rechenzentren kühlen mit Außenluft und verbrauchen fast kein Wasser, darunter Hetzner in Deutschland, wo DentroChat liegt, und die schwedischen Rechenzentren, in denen ein Teil unserer Modelle läuft. Mehr dazu in Verschwendet KI Wasser? und ausführlicher in KI-Wasserverbrauch: Warum die viralen Zahlen irreführend sind.
Praktisch noch: Bleibst du im selben Chat, liegt das lange Dokument meist ein paar Minuten im Speicher, sodass die nächste Nachricht vor allem den neuen Text verarbeitet. OpenAI und Anthropic beschreiben Caches, die nach etwa 5 bis 10 Minuten ohne Aktivität ablaufen, und das ist die Spalte „gecacht“ in unserer DentroChat-Tabelle. Es hilft auch, wenn das Modell für eine Nachricht mehrfach läuft, weil der zweite Lauf nutzen kann, was der erste schon gelesen hat.
Wir würden dir gern für jede Nachricht in DentroChat, dem EU KI Chat, den wir am liebsten nutzen, eine echte Wattstunden-Zahl anzeigen, dafür müssten die Anbieter uns den Energieverbrauch pro Anfrage nennen, was die meisten noch nicht tun. Bis dahin ist das hier unsere beste Annäherung: Bei großen Modellen wie GPT-4o braucht eine normale Anfrage etwa 0,3 Wattstunden und ein langes Dokument etwa 2,5, der mediane DentroChat-Prompt auf unseren kleineren Modellen liegt bei etwa 0,2 bis 1,3 Wattstunden, im EU-Durchschnittsnetz höchstens etwa 0,3 Gramm CO2.