AI zonder training op klantdata: veilige AI voor bedrijven
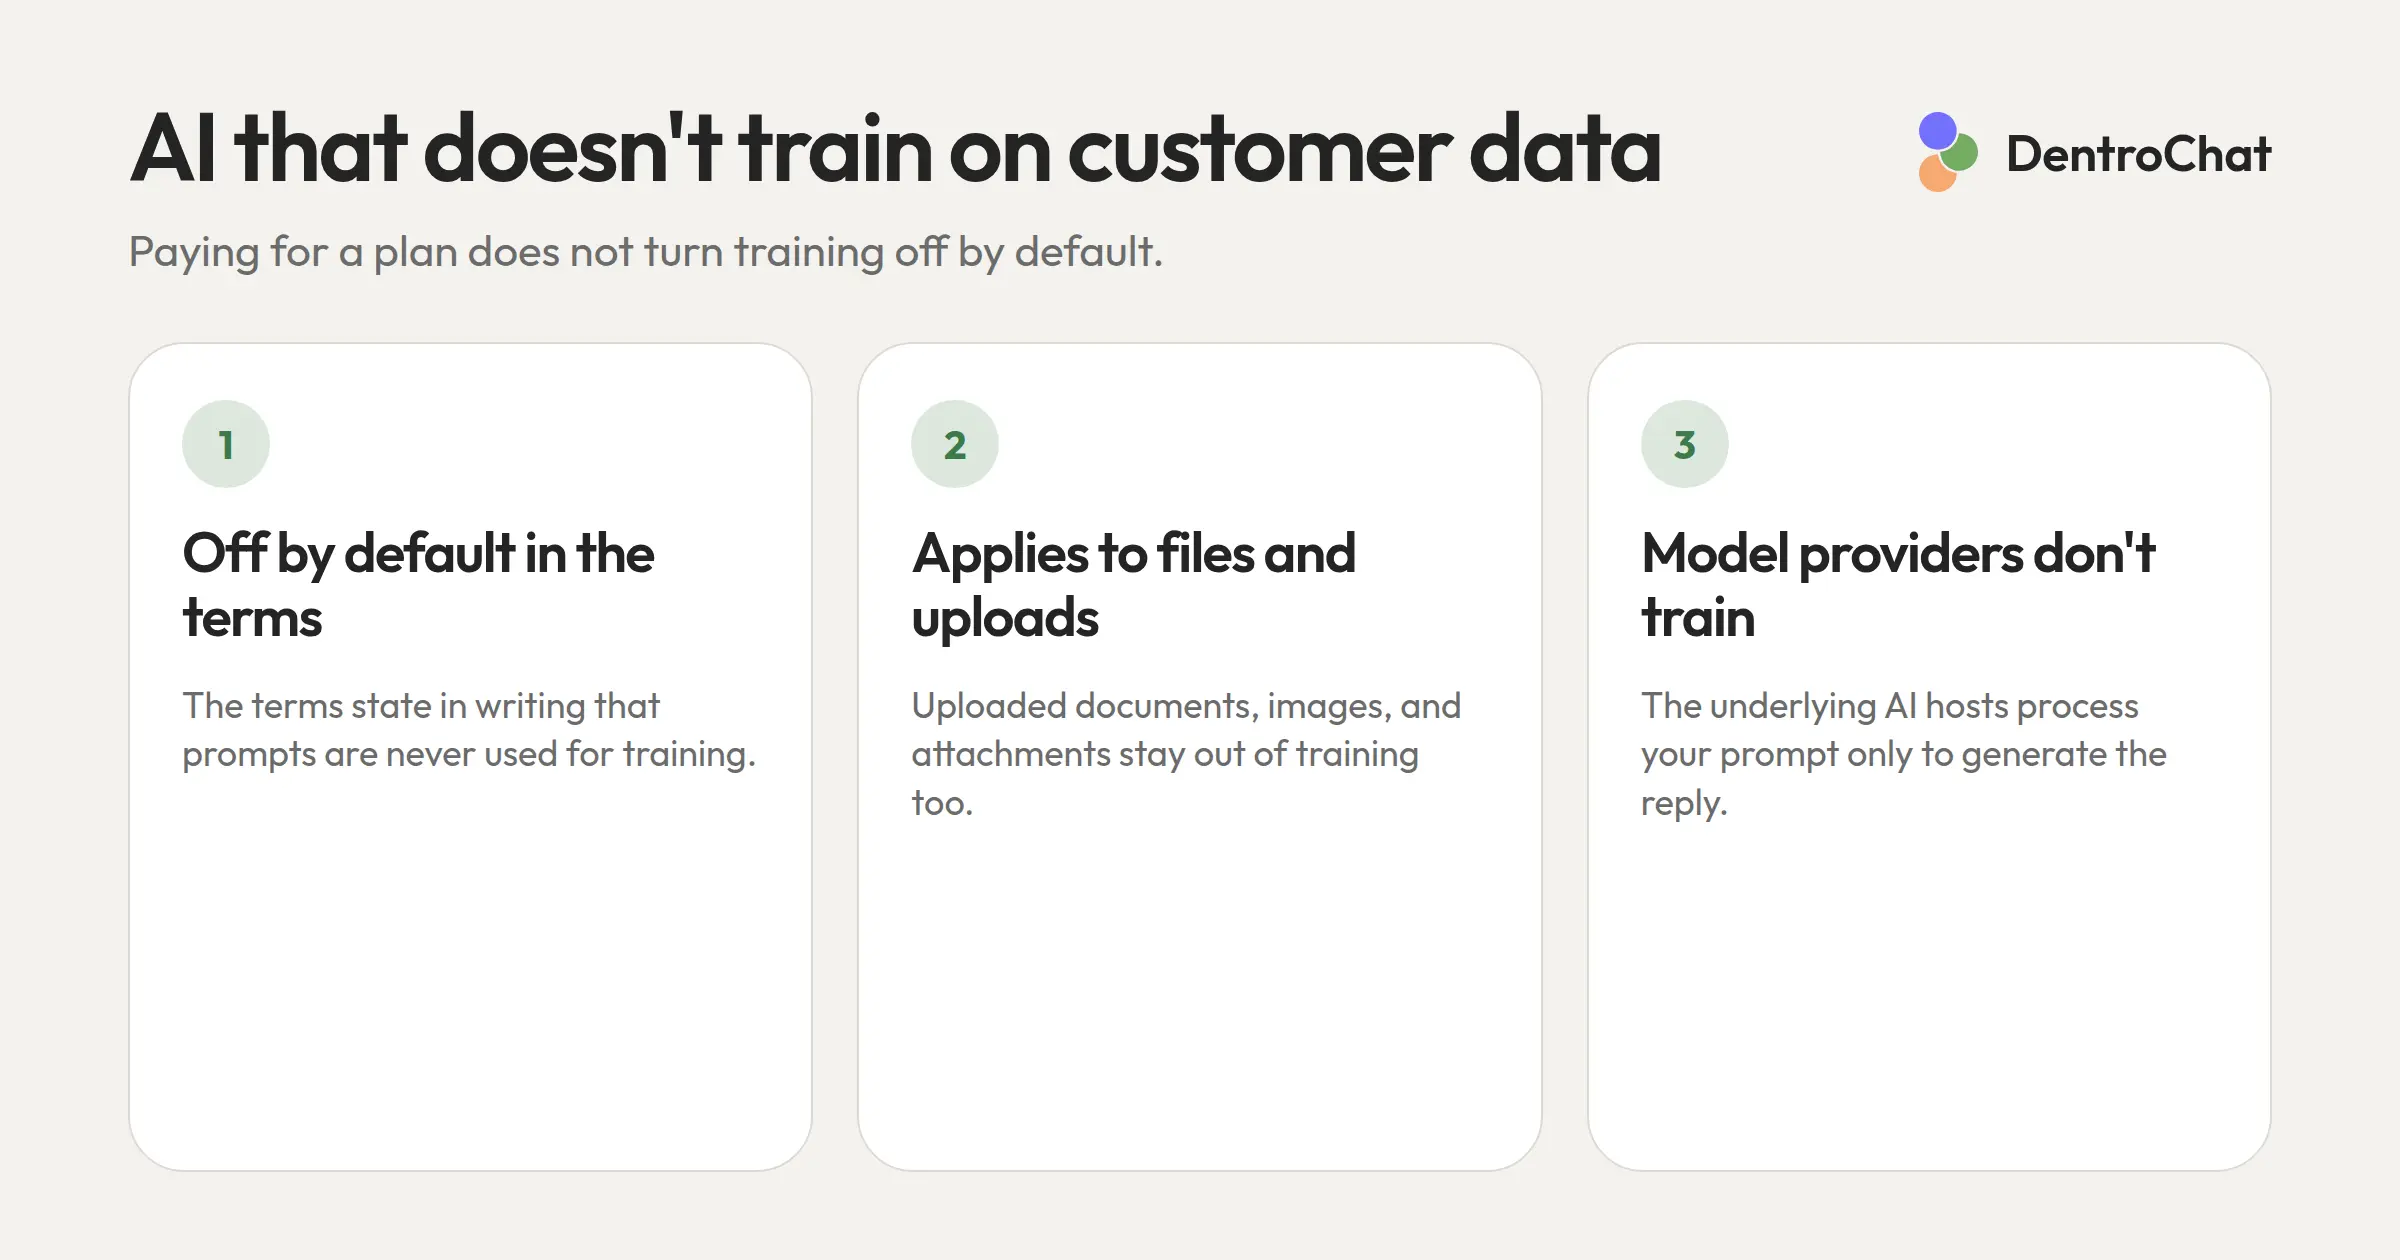
In Nederland en België vinden steeds meer bedrijven het essentieel om AI zonder training op klantgegevens in te zetten.
Als je dagelijks met contractteksten, klantberichten of interne strategiedocumenten werkt, hoor je die informatie niet meer in een systeem te stoppen dat het gebruikt om toekomstige AI-versies te trainen.
De AVG biedt veel waarborgen. Toch komt de technische werkelijkheid van veel populaire AI-oplossingen vaak niet overeen met de marketing.
Deze gids helpt je begrijpen waar je op moet letten bij veilige AI-tools. Welke rode vlaggen in de voorwaarden. Welke concrete stappen je meteen kunt nemen om je AI-gebruik veiliger te maken.
Waarom AI zonder training op klantgegevens ertoe doet
In je dagelijkse werk met AI-tools typ je waarschijnlijk meer dan een beetje tekst. Klantnamen. Contractdetails. Supportvragen. Interne notities. De vraag is niet óf je data ergens wordt ingevoerd, maar wáár, en wat er daarna mee gebeurt.
Wat er met je data gebeurt bij ChatGPT en vergelijkbare tools
Veel aanbieders formuleren hun voorwaarden zo dat je invoer gebruikt mag worden om modellen te trainen. Je prompt over klantdata kan in de trainingset voor een toekomstige versie belanden.
Het model leert niet meteen, maar de volgende release kan data teruggeven die jij ooit invoerde. Als iemand in Mexico plots de klantgegevens van Hans Kreutzer krijgt, is het feest voorbij.
Gratis vs betaald? Niet het hoofdpunt
Veel mensen denken ten onrechte dat betalen voor een abonnement automatisch betere privacy betekent.
Fout.
Zelfs met ChatGPT Plus kunnen trainingsopties aan blijven staan tot je ze zelf uitzet. Voor AI zonder training op klantgegevens moet je dieper kijken dan het abonnement. Privacy-instellingen en wat de aanbieder echt belooft tellen mee.
Particulier vs enterprise: waar de echte grens ligt
De nuttige scheiding is niet gratis versus betaald, maar persoonlijk versus enterprise. Persoonlijke accounts, inclusief Plus of Pro, beloven vaak weinig privacy standaard. Enterprise-aanbiedingen zoals ChatGPT Enterprise of Microsoft Copilot for Business zeggen vaker expliciet dat invoer niet voor modeltraining wordt gebruikt. Check dit:
-
Duidelijke voorwaarden: prompts worden standaard niet voor training gebruikt
-
Dezelfde bescherming voor geüploade bestanden, PDF’s en bijlagen
-
Ook de modelproviders in de stack (subverwerkers) trainen niet op je invoer
-
Geen verborgen opt-out-schakelaars of uitzonderingen via feedbackknoppen
Platformen zoals dentro.chat zijn gebouwd voor precies dit scenario: zakelijk gebruik waarbij klantdata niet in de modeltraining terechtkomt.
Juridische risico’s bij AI met klantgegevens
AVG en AI-gebruik
Zodra je persoonsgegevens in een AI-dienst stopt, geldt de AVG volledig, zonder uitzondering of grace period. Elke prompt met een klantnaam, e-mailadres of contractdetail telt. Wie de tool gebruikt, verwerkt data onder de AVG en moet doelbinding en dataminimalisatie respecteren: invoer mag alleen dienen om het antwoord te berekenen, niet voor latere modeltraining. Ook belangrijk: welke derden meekijken en welk rechtssysteem geldt. Veel teams snappen pas wat AVG-naleving voor AI op het werk betekent nadat er iets misging. Boetes kunnen hoog zijn.
US CLOUD Act: waarom serverlocatie niet genoeg is
Veel bedrijven vertrouwen erop dat hun AI-leverancier servers in de Europese Unie gebruikt. De serverlocatie dekt maar een deel van de vraag.
Een Amerikaanse chat kan nog steeds passen als die niet traint op jouw data. Voor gegevensbescherming in het geheel is het beter om Amerikaanse subprocessors te vermijden.
Amerikaanse bedrijven vallen onder de US CLOUD Act, die hen kan verplichten data aan Amerikaanse autoriteiten te geven, ongeacht waar die fysiek staan. Een node in Frankfurt haalt die blootstelling niet weg.
Amerikaanse autoriteiten kunnen ook geheimhouding opleggen. Dat gebeurde 1.823 keer bij Microsoft alleen al in de eerste helft van 2025.
Veilige AI-tools herkennen
Wat je elke leverancier moet vragen
Voordat je een AI-tool uitrolt in je bedrijf, stel concrete vragen:
-
Is modeltraining standaard uitgesloten voor chats en geüploade bestanden?
-
Geldt het trainingsverbod ook voor de modelproviders (subverwerkers)?
-
Hoe lang worden prompts bewaard voor misbruikcontrole, en wie heeft toegang?
-
Waar staan servers fysiek en welk recht geldt voor de operator?
Een leverancier die schriftelijk concreet antwoordt, laat zien dat privacy in het product zit.
Zelfs zonder training: bewaren voor misbruikcontrole
Zelfs als training uit staat, wissen veel grote aanbieders je invoer niet direct na het antwoord. Veel diensten bewaren prompts 30 dagen of langer voor misbruik en veiligheid, soms met menselijke reviewers. Voer je vertrouwelijke klantdata in, check dan hoe lang invoer wordt gelogd, of oude chats automatisch verdwijnen en wie toegang krijgt bij support.
Rode vlaggen in de voorwaarden
Bepaalde formuleringen moeten je meteen stoppen. «Om onze modellen te verbeteren» of «om onze AI te versterken» over je invoer en chatinhoud betekent dat prompts in toekomstige trainingsdata kunnen belanden. Let op: vergelijkbare zinnen kunnen alleen anonieme statistieken bedoelen, niet chatinhoud. Context telt, kijk waar «verbetering» op slaat. Vage privacyverklaringen zonder locatie of bewaartermijnen, of zonder opt-out voor training, zijn slechte tekenen.
Positieve signalen tellen net zo mee. Een serieuze privacyverklaring zegt duidelijk dat invoer niet wordt gebruikt om AI-modellen te trainen. Ze noemt waar data staat en somt elke subverwerker met locatie op. Het privacybeleid van DentroChat doet dat: geen training op chats, subverwerkers in de EU, geen US-subverwerkers.
Als je zulke duidelijke toezeggingen niet vindt, is dat al een antwoord. Wil je geen vreemde privacyverklaring regel voor regel lezen, dan helpt onze Privacy Policy Analyzer trainingclausules en doorgiften snel te vinden.
AI veiliger gebruiken: praktische strategieën
Zelfs zonder perfecte tool kun je je AI-gebruik meteen veiliger maken. Twee maatregelen hebben het meeste effect.
Anonimiseren voordat je typt
Vervang echte namen, bedrijven en contactgegevens door placeholders («Klant A», «Bedrijf X»). Het voelt wat onhandig, maar kost seconden en verlaagt het risico sterk, vooral zonder tool die expliciet belooft geen invoer voor training te gebruiken. Voor concepten of samenvattingen is anonimiseren vaak genoeg.
Interne regels voor je team
Individuele voorzichtigheid helpt weinig als collega’s klantdata in willekeurige AI-tools plakken. Leg vast welke datatypes in welke tools mogen en welke taboe zijn. Europese toezichthouders verwachten technische en organisatorische maatregelen (TOM) bij elke AI-uitrol. Korte teamtrainingen creëren bewustzijn zonder processen te vertragen.
DentroChat: AI zonder training op klantgegevens
Wil je alles hierboven consequent toepassen, dan heb je een platform nodig dat privacy vanaf het begin inbouwt. DentroChat is een Europees AI-alternatief voor privacybewuste gebruikers.
Hoe DentroChat privacy regelt
DentroChat draait volledig op Europese infrastructuur en verwerkt data alleen in de EU en Zwitserland. Geen US-subverwerkers, dus je invoer valt niet onder de US CLOUD Act. Dat is een structureel verschil met veel populaire alternatieven. Bovendien is AI zonder training op klantgegevens vast onderdeel van het aanbod.
Voor wie het het meest loont
Vooral bedrijven in Nederland, België en Europa die vaak met gevoelige klant- of contractdata werken. Advocaten, bureaus, consultancies. Teams onder de AVG. Zoek je iets compliant dat in het dagelijks werk werkt zonder technische trucs, dan is DentroChat een solide optie.
AI zonder modeltraining op klantgegevens is geen nice-to-have. Het is een basis die elk zakelijk AI-gebruik moet halen wanneer echte klantdata in het spel is. AVG, CLOUD Act en groeiende gevoeligheid bij klanten: nu koers zetten is beter dan later duur bijsturen.
Je volgende stap kan snel zijn. Lees de voorwaarden van je huidige AI-tools. Stel de vragen uit dit artikel. Als antwoorden vaag of afwezig zijn, weet je wat dat betekent.