Hoeveel energie gebruikt een AI-prompt?
Gebruikers van DentroChat, onze EU AI-assistent, vragen ons soms hoeveel stroom er in hun berichten zit. Begrijpelijke vraag. We zouden graag een getal in het product tonen, maar de partijen die de modellen in de cloud draaien geven het energieverbruik per request meestal nog niet door. Daarom hebben we ons best gedaan om het te benaderen met openbaar onderzoek.
Dit zijn geen labmetingen van DentroChat zelf. We hebben studies doorgenomen die we konden vinden, ze tegen elkaar aangehouden, en de cijfers hieronder zijn waar ze samenkomen. Ken je een betere bron? Laat het ons weten.
Stroom voor een normale prompt
Typisch stel je een vraag en krijg je een antwoord van een paar honderd tokens. Een token is een stukje woord, of bij korte woorden soms een heel woord.
Google heeft dit gemeten. In mei 2025 was de mediane tekstprompt in hun Gemini-apps 0,24 wattuur. Daarin zaten chip en koeling voor de hele hal in het datacenter. Voor de mediane prompt rekende Google met 0,03 gram CO2 (voor de stroom van Google).
Epoch AI schatte in februari 2025 een typisch ChatGPT-antwoord op ongeveer 0,3 wattuur, uitgaande van zo’n 500 tokens antwoord. Ze geven zelf aan dat hun schatting iets aan de hoge kant ligt.
In april 2026 verscheen een paper in Joule met data uit deployments van 2025. Voor een groot model lag de mediane waarde op 0,31 wattuur. Sam Altman schreef in juni 2025 dat een gemiddelde ChatGPT-query ongeveer 0,34 wattuur kost.
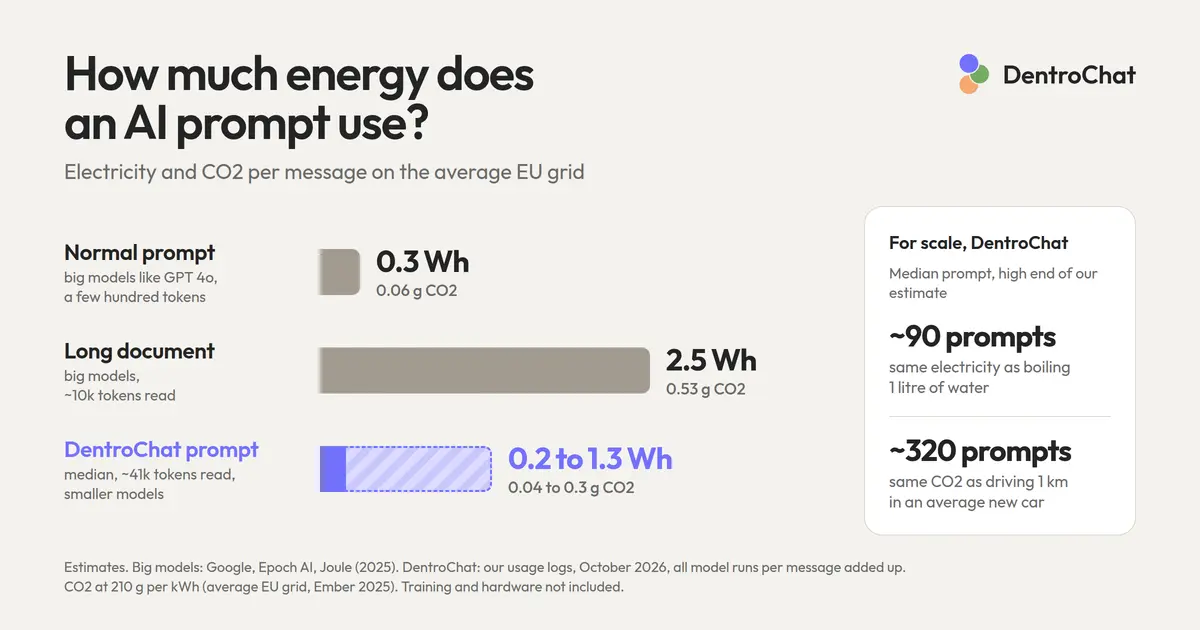
Voor een typische prompt zouden we dus 0,3 wattuur zeggen: meting en schattingen komen ongeveer op hetzelfde uit.
Stroom bij een langere prompt
Een lang document is meer werk, omdat er veel gelezen moet worden.
Epoch AI schatte dat ongeveer 10k tokens input uitkomt op ongeveer 2,5 wattuur voor zo’n query. Om te laten zien wat dat in woorden is, hebben we tokens op onze eigen pagina’s geteld. De tellingen hier gebruiken de GPT-4o-tokenizer: ongeveer 7.700 Engelse woorden en ongeveer 5.800 Duitse woorden, dus een lang artikel of een chat met veel berichten. Verderop hebben we dezelfde pagina’s ook door vijf andere tokenizers gehaald; die tabel laat zien hoe ver ze van GPT-4o afwijken.
Jegham et al. maakten hun eigen schatting voor zo’n prompt met 10k in en 1.500 uit. Afhankelijk van het model kwamen ze uit tussen ongeveer 1,4 en 2,9 wattuur, dus in dezelfde orde van grootte als Epoch.
Als het model lang nadenkt en duizenden tokens schrijft voordat het antwoord verschijnt, gaat er meer stroom in. In het Joule-paper zitten ze met een antwoord van ongeveer 5k tokens op ongeveer 4 wattuur. Dat is een reasoning-antwoord waarbij het model veel rekent.
Hier alles in één tabel. Het gaat om grote modellen zoals GPT-4o en Gemini:
| Soort prompt | Tokens, grof | Stroom | Bron |
|---|---|---|---|
| Normale prompt | korte vraag, een paar honderd tokens terug | ~0,3 Wh | Google, Epoch AI, Joule-paper, Altman |
| Lang document | ~10k in, 500 tot 1.500 uit | ~2,5 Wh (1,4 tot 2,9) | Epoch AI, Jegham et al. |
| Reasoning-antwoord | ~5k uit | ~4 Wh | Joule-paper |
In het kort: een normale prompt gebruikt ongeveer 0,3 wattuur. Een lang document van ongeveer 10k tokens gebruikt ongeveer 2,5 wattuur, ergens tussen 1,4 en 2,9 afhankelijk van het model. Een lang reasoning-antwoord van ongeveer 5k tokens gebruikt ongeveer 4 wattuur.
CO2 hangt af van het net
De stroom voor hetzelfde model is ongeveer overal hetzelfde, waar de servers staan. Maar het CO2 hangt af van het lokale stroomnet.
We hebben de cijfers van Ember, 2025 gebruikt, te zien bij Our World in Data. Dat zijn levenscycluscijfers: ze tellen de toeleveringsketen van stroom bovenop de uitstoot van de centrale. Gemeten in gram CO2-equivalent per kilowattuur.
Daarmee hebben we onze twee getallen vermenigvuldigd: 0,3 Wh voor een normale prompt en 2,5 Wh voor een lang document:
| Net | g CO2e per kWh | Normale prompt | Lang document |
|---|---|---|---|
| Noorwegen | 28 | 0,01 g | 0,07 g |
| Zweden | 35 | 0,01 g | 0,09 g |
| Frankrijk | 41 | 0,01 g | 0,10 g |
| Finland | 57 | 0,02 g | 0,14 g |
| Denemarken | 114 | 0,03 g | 0,29 g |
| Oostenrijk | 117 | 0,04 g | 0,29 g |
| Spanje | 154 | 0,05 g | 0,38 g |
| EU-gemiddelde | 210 | 0,06 g | 0,53 g |
| Nederland | 254 | 0,08 g | 0,63 g |
| Italië | 285 | 0,09 g | 0,71 g |
| Estland | 319 | 0,10 g | 0,80 g |
| Duitsland | 330 | 0,10 g | 0,82 g |
| Verenigde Staten | 384 | 0,12 g | 0,96 g |
| Polen | 589 | 0,18 g | 1,47 g |
In het kort: in Zweden (35 g per kWh) en Frankrijk (41 g) kost een normale prompt ongeveer 0,01 gram CO2 en een lang document ongeveer 0,1 gram. Op het EU-gemiddelde (210 g) is een normale prompt ongeveer 0,06 gram en een lang document ongeveer 0,5 gram. In Duitsland (330 g) ongeveer 0,1 gram en 0,8 gram. Polen heeft met 589 g de hoogste waarde in de tabel: ongeveer 0,18 gram voor een normale prompt en ongeveer 1,5 gram voor een lang document. De VS staan erbij omdat veel ChatGPT-cijfers daar vandaan komen; bij 384 g is het ongeveer 0,12 gram voor een normale prompt en ongeveer 1 gram voor een lang document.
In Duitsland zegt het milieuagentschap voor 2025 iets vergelijkbaars: 344 g CO2 per kilowattuur uit opwekking en 406 g CO2-equivalent met toeleveringsketen. Electricity Maps komt voor het werkelijke stroomverbruik in Duitsland in 2025 uit op 335 g, waarbij losse uren tussen ongeveer 100 g en 600 g kunnen schommelen.
Hoe zit het met DentroChat?
Alles tot nu toe geldt voor grote modellen zoals GPT-4o. Epoch ging uit van ongeveer 100 miljard parameters die per token meedraaien, maar DentroChat gebruikt vaak kleinere modellen. Het zijn mixture-of-experts-modellen: het model is groot, maar per token doet maar een klein deel het werk. DeepSeek V4 Flash gebruikt ongeveer 13 miljard parameters per token, GLM 5.3 Flash ongeveer 18 miljard en Qwen 3.8 Flash Next ongeveer 6 miljard.
Minder actieve parameters betekent minder stroom per token en dus minder CO2 per token. Het ML.ENERGY-leaderboard heeft dat gemeten op echte GPU’s. Een Qwen-model met 22 miljard actieve parameters had ongeveer 0,12 Wh nodig per 1.000 geschreven tokens. DeepSeek V3.1 met 37 miljard ongeveer 0,37 Wh. Dat is alleen de grafische kaarten; daar tellen we koeling en de rest van de servers nog bij op. Onze modellen zijn kleiner dan beide, dus dit is onze schatting:
| Per 1.000 tokens | Actieve parameters per token | Geschreven | Gelezen, vers | Gelezen, gecached | CO2 per 1.000 geschreven, EU-gemiddelde |
|---|---|---|---|---|---|
| GPT-4o (Epoch-annname) | ~100 mld | ~0,6 Wh | ~0,2 Wh | ~0,13 g | |
| DentroChat-modellen (onze schatting) | 6 tot 18 mld | 0,05 tot 0,4 Wh | 0,01 tot 0,07 Wh | 0,001 tot 0,007 Wh | 0,01 tot 0,08 g |
In het kort: voor GPT-4o komen Epochs cijfers uit op ongeveer 0,6 wattuur per 1.000 tokens die het model schrijft, en ongeveer 0,2 per 1.000 tokens die het leest. Voor de modellen in DentroChat schatten we 0,05 tot 0,4 wattuur per 1.000 geschreven tokens en 0,01 tot 0,07 per 1.000 gelezen tokens. Is de tekst een paar minuten eerder al gelezen, dan zit hij in de cache en kost het ongeveer een tiende daarvan. Op het EU-gemiddelde net zijn 1.000 geschreven tokens ongeveer 0,13 gram CO2 voor GPT-4o en 0,01 tot 0,08 gram voor onze modellen.
Onze prompts zijn groter dan de «normale prompt» in de studies. Elke bericht stuurt het model ook zijn instructies en toolbeschrijvingen mee, al ongeveer 3k tokens. Daarbovenop komen je geheugen, de chat tot nu toe, en eventuele bestanden of zoekresultaten. Gebruikt het model een tool, dan leest het alles opnieuw. Het kan bijvoorbeeld eerst besluiten te zoeken op het web en daarna de hele chat plus zoekresultaten lezen om het antwoord te schrijven. Eén bericht van jou kan dus meerdere modelruns betekenen.
Alle cijfers in de tabel hieronder zijn per bericht dat je stuurt. Heeft één bericht het model meerdere keren laten draaien, dan hebben we die runs in één rij opgeteld.
We hebben in onze gebruikslogs gekeken en tokens geteld (wat je schrijft lezen we natuurlijk niet). De tabel gebruikt 606 prompts van één dag in oktober 2026. We hebben ook de 21.700 prompts van de 30 dagen ervoor gecontroleerd; de mediane waarde leek sterk op elkaar:
| DentroChat-prompt | Gelezen | waarvan gecached | Geschreven | Stroom (onze schatting) | CO2, EU-gemiddelde | CO2, Duitsland |
|---|---|---|---|---|---|---|
| Median | ~41k | ~30k | ~900 | 0,2 tot 1,3 Wh | 0,04 tot 0,3 g | 0,06 tot 0,4 g |
| Bovenste 10 % | ~131k | ~66k | ~4.600 | 1 tot 7 Wh | 0,2 tot 1,4 g | 0,3 tot 2,3 g |
In het kort: de mediane DentroChat-prompt leest ongeveer 41k tokens, waarvan ongeveer 30k gecached omdat ze een paar minuten eerder al waren meegestuurd. Geschreven worden ongeveer 900 tokens. Wij schatten dat op 0,2 tot 1,3 wattuur, ongeveer 0,04 tot 0,3 gram CO2 op het EU-gemiddelde net en 0,06 tot 0,4 gram in Duitsland. De bovenste 10 % leest 131k tokens of meer en schrijft 4.600 of meer. Dat is ongeveer 1 tot 7 wattuur, of 0,2 tot 1,4 gram CO2 op het EU-gemiddelde en 0,3 tot 2,3 gram in Duitsland.
Voor de rij «Bovenste 10 %» hebben we per kolom de waarde op zichzelf genomen. Een echte prompt raakt zelden alle kolommen tegelijk, dus die rij is expres aan de zware kant.
Er is ook werk op de achtergrond, zoals het bijwerken van je geheugen en het samenvatten van lange chats. Soms is een model te traag en schakelen we halverwege over op een backupmodel. Die runs staan niet in de tabel. Verdeel je ze over alle prompts, dan leest de gemiddelde prompt ongeveer 76k tokens (50k gecached) en schrijft ongeveer 2k. Dat komt uit op ongeveer 0,4 tot 3 wattuur.
Een DentroChat-prompt leest dus veel meer dan de normale prompt uit de studies. Per token is het goedkoper. De mediane DentroChat-prompt (0,2 tot 1,3 Wh) zit aan de onderkant dicht bij de normale prompt van grote modellen (0,3 Wh) en aan de bovenkant ongeveer op de helft van hun lang document (2,5 Wh).
Ter vergelijking: waterkoker en korte rit
Je hebt grofweg 100 wattuur warmte nodig om een liter water van kraan tot koken te brengen. Een deel komt niet in het water terecht, dus aan het stopcontact is het eerder 110 tot 125 wattuur.
Een mediane DentroChat-prompt is een klein stukje daarvan. We nemen de bovenkant van onze schatting, 1,3 wattuur, zodat de vergelijking aan de zware kant blijft. Zo heb je ongeveer 90 DentroChat-prompts nodig voor één liter.
Voor de auto nemen we het gemiddelde voor nieuwe auto’s in 2025 van de Europese Milieuagentschap: 96,7 g CO2 per kilometer volgens labtests. In het gemiddelde zitten ook elektrische auto’s, die als nul uitlaat tellen, dus een benzineauto op de weg verbruikt waarschijnlijk iets meer.
Per kilometer in zo’n gemiddelde nieuwe auto kun je in Duitsland ongeveer 240 mediane DentroChat-prompts sturen. Weer de zware kant: 0,4 gram CO2 per prompt. Op het EU-gemiddelde net is dezelfde prompt 0,3 gram, dus ongeveer 320 prompts per kilometer.
Taal beïnvloedt het aantal tokens
Verschillende talen tokenizen dezelfde pagina in een verschillend aantal tokens. We hebben onze artikelen door tokenizers gehaald voor alle 17 talen die DentroChat ondersteunt.
We gebruikten 22 blogposts die in elke taal bestaan, dus steeds dezelfde tekst. Het hoofdcijfer komt van de GPT-4o-tokenizer. Het bereik is het laagste en hoogste resultaat over zes tokenizers (GPT-4o, GPT-4, Mistral, Llama 3, Qwen 2.5 en DeepSeek V3).
| Taal | Tokens per woord | Bereik | Woorden in 10k tokens |
|---|---|---|---|
| Engels | 1,3 | 1,3 tot 1,4 | ~7.700 |
| Spaans | 1,4 | 1,4 tot 1,7 | ~7.200 |
| Portugees | 1,4 | 1,4 tot 1,7 | ~7.000 |
| Frans | 1,4 | 1,4 tot 1,7 | ~6.900 |
| Nederlands | 1,6 | 1,6 tot 2,1 | ~6.300 |
| Italiaans | 1,7 | 1,7 tot 1,9 | ~6.000 |
| Duits | 1,7 | 1,7 tot 2,1 | ~5.800 |
| Noors | 1,9 | 1,9 tot 2,2 | ~5.400 |
| Zweeds | 1,9 | 1,9 tot 2,3 | ~5.300 |
| Deens | 1,9 | 1,9 tot 2,3 | ~5.300 |
| Roemeens | 1,9 | 1,9 tot 2,2 | ~5.300 |
| Kroatisch | 2,1 | 2,1 tot 2,6 | ~4.800 |
| Pools | 2,2 | 2,2 tot 2,6 | ~4.500 |
| Grieks | 2,4 | 2,4 tot 5,9 | ~4.200 |
| Estisch | 2,5 | 2,5 tot 3,1 | ~4.000 |
| Hongaars | 2,6 | 2,5 tot 3,1 | ~3.900 |
| Fins | 2,8 | 2,8 tot 3,5 | ~3.600 |
In het kort: op de GPT-4o-tokenizer is Engels ongeveer 1,3 tokens per woord, dus 10k tokens is ongeveer 7.700 Engelse woorden. Spaans, Portugees en Frans zitten er dicht achter met ongeveer 1,4. Nederlands ongeveer 1,6, Duits en Italiaans ongeveer 1,7, dus 10k tokens is ongeveer 5.800 Duitse woorden. De Noord-Europese talen behalve Fins zitten rond 1,9. Estisch ongeveer 2,5 en Fins het hoogst met ongeveer 2,8, dus 10k tokens is slechts ongeveer 3.600 Finse woorden.
Vaak hoor je dat een Duits woord drie tokens is. Op moderne tokenizers meten we eerder twee. Grieks heeft het grote bereik omdat oudere tokenizers het Griekse alfabet slecht aan kunnen.
Een Fins document van dezelfde lengte gebruikt dus meer tokens en daarmee meer stroom. Gram CO2 per Wh blijft wat hierboven staat voor het net.
Wat we niet hebben meegenomen
Dit gaat over de stroom voor één antwoord op één bericht.
Modeltraining gebeurde eerder in één keer en wordt gedeeld door iedereen die het model gebruikt. De trainingskosten aan jouw prompt toeschrijven zou giswerk zijn, dus laten we die weg.
Er is ook de kost om grafische kaarten te maken. Nvidia’s breakdown voor één H100-bord: 1312 kg CO2-equivalent voor 8 GPU’s, verdeeld over een paar jaar gebruik. Voor één prompt draag je maar een klein deel van dat mee, ruim onder 1 g. Op een schoon net zoals Zweden kan dat deel dicht bij het CO2 van de stroom zelf komen. Op het Duitse net is de stroom veel groter.
En water. De virale claim dat AI een fles water drinkt komt uit een schatting uit 2023 voor GPT-3: ongeveer 500 ml voor 20 tot 50 antwoorden, in hete Amerikaanse datacenters die koelen door water te verdampen. Google mat 0,26 ml voor een mediane Gemini-tekstprompt (ongeveer vijf druppels). Veel Europese datacenters koelen met buitenlucht en gebruiken nauwelijks water, waaronder Hetzner in Duitsland waar DentroChat staat, en de Zweedse datacenters waar een deel van onze modellen draait. Meer daarover in Verspilt AI water? en uitgebreider in AI-waterverbruik: waarom virale cijfers misleidend zijn.
Er is ook dit praktische punt. Blijf je in dezelfde chat, dan zit het lange document meestal een paar minuten in het geheugen. De volgende bericht verwerkt vooral de nieuwe tekst. OpenAI en Anthropic beschrijven caches die na ongeveer 5 tot 10 minuten zonder activiteit verlopen. Dat is de kolom «gecached» in onze DentroChat-tabel. Het helpt ook als het model meerdere keren draait voor één bericht, omdat de tweede run kan hergebruiken wat de eerste al las.
We zouden je graag per bericht een echt wattuurnummer tonen in DentroChat, de beste EU AI-chat. Daarvoor zouden de providers die de modellen draaien ons het energieverbruik per request moeten geven, en de meesten doen dat nog niet.
Tot die tijd is dit onze beste benadering. Bij grote modellen zoals GPT-4o gebruikt een normale prompt ongeveer 0,3 wattuur en een lang document ongeveer 2,5. Een mediane DentroChat-prompt op onze kleinere modellen gebruikt ongeveer 0,2 tot 1,3 wattuur. Op het EU-gemiddelde net is dat hooguit ongeveer 0,3 gram CO2.