Quanta energia consuma un prompt IA?
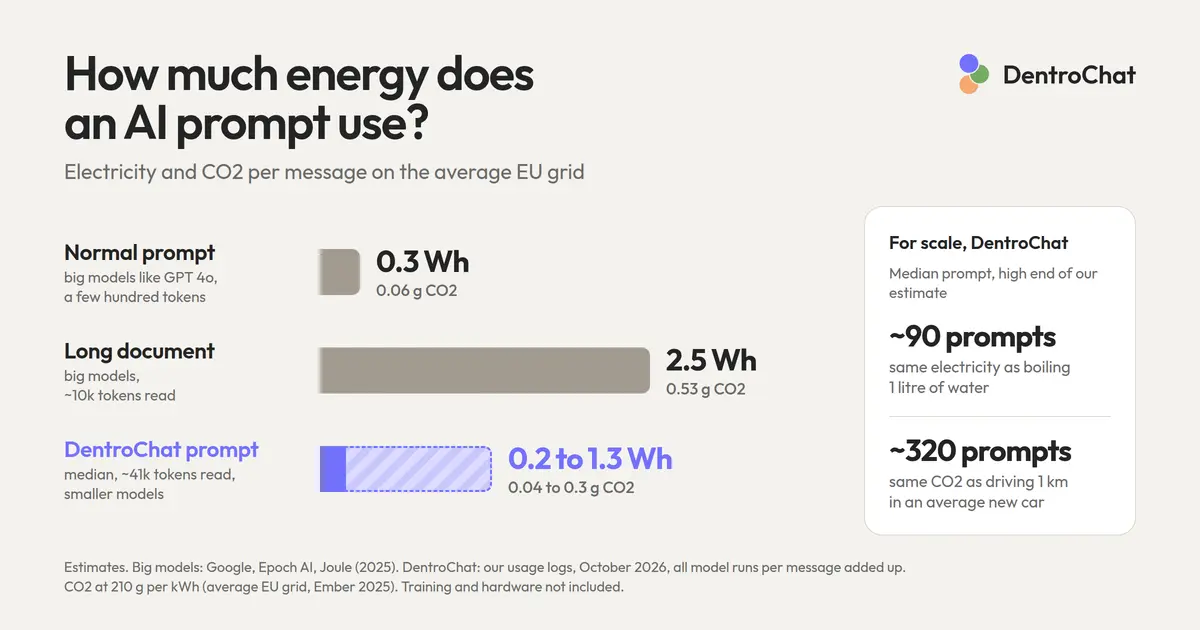
Gli utenti di DentroChat, il nostro assistente IA UE, a volte ci chiedono quanta elettricità consumano i loro messaggi. È una domanda sensata. Ci piacerebbe mostrarti un numero nel prodotto, ma le aziende che fanno girare i modelli nel cloud per lo più non forniscono ancora l’energia di una singola richiesta. Abbiamo quindi fatto del nostro meglio per approssimarla con la ricerca pubblica.
Non sono misure in laboratorio di DentroChat. Abbiamo letto gli studi che abbiamo trovato e li abbiamo confrontati tra loro; i numeri sotto sono dove convergono. Se hai una fonte migliore, faccelo sapere.
Elettricità per un prompt normale
Un prompt tipico: fai una domanda e il modello risponde in qualche centinaio di token. Un token è un pezzo di parola, o una parola intera se è corta.
Google l’ha misurato. A maggio 2025 il prompt testuale mediano nelle app Gemini era 0,24 wattora. Include chip e raffreddamento dell’intera sala del data center. Per il prompt mediano Google calcolava 0,03 grammi di CO2 (sull’elettricità di Google).
Epoch AI ha stimato una risposta tipica in ChatGPT a febbraio 2025 in circa 0,3 wattora, per una risposta di circa 500 token. Dicono che la stima è un po’ alta.
Un articolo su Joule dell’aprile 2026, con dati da deployment del 2025, stima la mediana per un modello grande a 0,31 wattora. Sam Altman ha scritto a giugno 2025 che la query media su ChatGPT è ~0,34 wattora.
Per un prompt tipico diremmo 0,3 wattora. Misura e stime finiscono nello stesso punto.
Elettricità per un prompt più lungo
Un documento lungo è più lavoro perché bisogna leggere molto.
Epoch AI ha stimato che circa 10k token in input portano a circa 2,5 wattora per una query del genere. Per capire cosa significa in parole, abbiamo contato i token sulle nostre pagine. I numeri qui usano il tokenizer GPT 4o: circa 7.700 parole inglesi e circa 5.800 tedesche, quindi un articolo lungo o una chat con molti messaggi. Più sotto abbiamo passato le stesse pagine anche in altri cinque tokenizer, e la tabella mostra quanto distano da GPT 4o.
Jegham et al. hanno fatto la loro stima per un prompt così: 10k in, 1.500 out. Tra ~1,4 e 2,9 wattora a seconda del modello. Stesso ordine di grandezza di Epoch.
Se il modello pensa a lungo e scrive migliaia di token prima che appaia la risposta, si usa più elettricità. Nell’articolo Joule mettono una risposta di circa 5k token a ~4 wattora. È una risposta in stile «reasoning», dove il modello ragiona molto.
Ecco tutto in una tabella. Sono modelli grandi come GPT 4o e Gemini:
| Tipo di prompt | Token, circa | Elettricità | Fonte |
|---|---|---|---|
| Prompt normale | domanda breve, qualche centinaio di token in risposta | ~0,3 Wh | Google, Epoch AI, articolo Joule, Altman |
| Documento lungo | ~10k in, 500–1.500 out | ~2,5 Wh (1,4–2,9) | Epoch AI, Jegham et al. |
| Risposta reasoning | ~5k out | ~4 Wh | Articolo Joule |
In sintesi: un prompt normale usa circa 0,3 wattora. Un documento lungo di circa 10k token usa circa 2,5 wattora, tra 1,4 e 2,9 a seconda del modello. Una lunga risposta reasoning di circa 5k token usa circa 4 wattora.
La CO2 dipende dalla rete
L’elettricità per lo stesso modello è più o meno uguale ovunque stiano i server. Ma la CO2 dipende dalla rete elettrica locale.
Abbiamo preso i numeri di Ember, 2025, visibili su « Our World in Data ». Sono numeri a ciclo di vita: includono la catena di approvvigionamento dell’elettricità oltre alle emissioni della centrale, in grammi di equivalente CO2 per kilowattora.
Li abbiamo moltiplicati per i nostri due numeri, 0,3 Wh per un prompt normale e 2,5 Wh per un documento lungo:
| Rete | g CO2e per kWh | Prompt normale | Documento lungo |
|---|---|---|---|
| Norvegia | 28 | 0,01 g | 0,07 g |
| Svezia | 35 | 0,01 g | 0,09 g |
| Francia | 41 | 0,01 g | 0,10 g |
| Finlandia | 57 | 0,02 g | 0,14 g |
| Danimarca | 114 | 0,03 g | 0,29 g |
| Austria | 117 | 0,04 g | 0,29 g |
| Spagna | 154 | 0,05 g | 0,38 g |
| Media UE | 210 | 0,06 g | 0,53 g |
| Paesi Bassi | 254 | 0,08 g | 0,63 g |
| Italia | 285 | 0,09 g | 0,71 g |
| Estonia | 319 | 0,10 g | 0,80 g |
| Germania | 330 | 0,10 g | 0,82 g |
| Stati Uniti | 384 | 0,12 g | 0,96 g |
| Polonia | 589 | 0,18 g | 1,47 g |
In sintesi: in Svezia (35 g per kWh) e Francia (41 g) un prompt normale è circa 0,01 grammi di CO2 e un documento lungo circa 0,1 grammi. Sulla media UE (210 g) un prompt normale circa 0,06 grammi e un documento lungo circa 0,5 grammi. In Germania (330 g) un prompt normale circa 0,1 grammi e un documento lungo circa 0,8 grammi. La Polonia è la più alta in tabella a 589 g, quindi un prompt normale circa 0,18 grammi e un documento lungo circa 1,5 grammi. Gli Stati Uniti ci sono perché molti numeri ChatGPT nascono lì. A 384 g circa 0,12 grammi per un prompt normale e circa 1 grammo per un documento lungo.
In Germania, l’agenzia ambientale dice cose simili per il 2025: 344 g CO2 per kWh dalla generazione e 406 g di equivalente CO2 con la catena di approvvigionamento. Electricity Maps indica per il consumo reale di elettricità in Germania 335 g nel 2025. Singole ore possono andare da ~100 g a ~600 g.
E DentroChat?
Tutti i numeri fin qui sono per modelli grandi come GPT 4o. Epoch assumeva che circa 100 miliardi di parametri lavorino su ogni token, ma DentroChat usa spesso modelli più piccoli. Sono modelli «mixture of experts»: il modello è grande, ma solo una piccola parte lavora per ogni token. DeepSeek V4 Flash usa circa 13 miliardi di parametri per token, GLM 5.3 Flash circa 18 miliardi e Qwen 3.8 Flash Next circa 6 miliardi.
Meno parametri attivi significa meno elettricità per token e quindi meno CO2 per token. La classifica ML.ENERGY l’ha misurato sulle loro GPU. Un modello Qwen con 22 miliardi di parametri attivi richiedeva circa 0,12 Wh per 1.000 token scritti. DeepSeek V3.1 con 37 miliardi circa 0,37 Wh. Sono solo le schede grafiche, quindi abbiamo aggiunto raffreddamento e il resto dei server. I nostri modelli sono più piccoli di entrambi, da cui la nostra stima:
| Per 1.000 token | Parametri attivi per token | Scritti | Letti, freschi | Letti, in cache | CO2 per 1.000 scritti, media UE |
|---|---|---|---|---|---|
| GPT 4o (ipotesi Epoch) | ~100 mld | ~0,6 Wh | ~0,2 Wh | ~0,13 g | |
| Modelli DentroChat (nostra stima) | 6–18 mld | 0,05–0,4 Wh | 0,01–0,07 Wh | 0,001–0,007 Wh | 0,01–0,08 g |
In sintesi: per GPT 4o, i numeri di Epoch danno circa 0,6 wattora per ogni 1.000 token che il modello scrive e circa 0,2 per ogni 1.000 che legge. Per i modelli in DentroChat stimiamo 0,05–0,4 wattora per 1.000 token scritti e 0,01–0,07 per 1.000 letti. Se il testo era già stato letto qualche minuto prima, è in cache e costa circa un decimo. Sulla rete media UE, 1.000 token scritti sono circa 0,13 grammi di CO2 per GPT 4o e 0,01–0,08 grammi per i nostri modelli.
Ma i nostri prompt sono più grandi del « prompt normale » negli studi. Ogni messaggio invia al modello anche istruzioni e descrizioni degli strumenti, già circa 3k token. Sopra ci sono la tua memoria, la chat finora e file o risultati di ricerca web. Quando il modello usa uno strumento, rilegge tutto. Per esempio decide prima di cercare sul web, poi rilegge tutta la chat con i risultati per scrivere la risposta. Un messaggio tuo può significare più passate del modello.
Tutti i numeri nella tabella sotto sono per messaggio che invii. Se un messaggio ha fatto girare il modello più volte, abbiamo sommato quelle passate in una riga.
Abbiamo guardato i nostri log d’uso e contato i token (quello che scrivi, ovviamente, non lo leggiamo). La tabella usa 606 prompt di un giorno di ottobre 2026. Abbiamo anche controllato i 21.700 prompt dei 30 giorni prima, e la mediana era molto simile:
| Prompt DentroChat | Token letti | di cui in cache | Token scritti | Elettricità (nostra stima) | CO2, media UE | CO2, Germania |
|---|---|---|---|---|---|---|
| Mediana | ~41k | ~30k | ~900 | 0,2–1,3 Wh | 0,04–0,3 g | 0,06–0,4 g |
| Top 10 % | ~131k | ~66k | ~4.600 | 1–7 Wh | 0,2–1,4 g | 0,3–2,3 g |
In sintesi: il prompt mediano DentroChat legge circa 41k token, di cui circa 30k in cache perché inviati pochi minuti prima. Scrive circa 900 token. Lo stimiamo a 0,2–1,3 wattora, circa 0,04–0,3 grammi di CO2 sulla rete media UE e 0,06–0,4 grammi in Germania. Il top 10 % legge 131k token o più e scrive 4.600 o più. Sono circa 1–7 wattora, o 0,2–1,4 grammi di CO2 sulla media UE e 0,3–2,3 grammi in Germania.
Per la riga top 10 % abbiamo preso ogni colonna da sola. Un prompt reale raramente colpisce tutto insieme, quindi la riga è volutamente dal lato pesante.
C’è anche lavoro in background, come aggiornare la memoria o riassumere chat lunghe. A volte un modello è lento e passiamo a un backup a metà strada. Quelle passate non sono in tabella. Spalmate su tutti i prompt, il prompt medio legge circa 76k token (50k in cache) e scrive circa 2k. Finisce a circa 0,4–3 wattora.
Un prompt DentroChat legge quindi molto più del prompt normale degli studi. Ogni token costa meno. La mediana DentroChat (0,2–1,3 Wh) è vicina al prompt normale dei modelli grandi (0,3 Wh) in basso e a circa metà del loro documento lungo (2,5 Wh) in alto.
A titolo di confronto: bollitore e breve tragitto
Servono grosso modo 100 wattora di calore per scaldare un litro d’acqua dal rubinetto fino al bollore. Parte non entra nell’acqua, quindi alla presa sono più 110–125 wattora.
Un prompt mediano DentroChat è una piccola frazione di quello. Usiamo l’estremo alto della stima, 1,3 wattora, così il confronto resta dal lato pesante. A quel ritmo servirebbero circa 90 prompt DentroChat per eguagliare un litro.
Per l’auto prendiamo la media delle auto nuove nel 2025 dell’Agenzia europea dell’ambiente: 96,7 g CO2 per km secondo i test di laboratorio. La media include le elettriche contate a zero allo scarico, quindi una benzina in strada consumerà un po’ di più.
Per ogni chilometro che guidi in quell’auto nuova media potresti inviare circa 240 prompt mediani DentroChat in Germania. Di nuovo l’estremo alto: 0,4 grammi di CO2 per prompt. Sulla rete media UE lo stesso prompt fa 0,3 grammi, quindi circa 320 prompt per chilometro.
Lingua e token
Le lingue usano numeri diversi di token per tokenizzare la stessa pagina. Abbiamo passato i nostri articoli ai tokenizer per tutte le 17 lingue supportate da DentroChat.
Abbiamo usato 22 post del blog, presenti in ogni lingua, quindi lo stesso testo ogni volta. Il numero principale è il tokenizer GPT 4o. L’intervallo è minimo e massimo su sei tokenizer (GPT 4o, GPT 4, Mistral, Llama 3, Qwen 2.5 e DeepSeek V3).
| Lingua | Token per parola | Intervallo | Parole in 10k token |
|---|---|---|---|
| Inglese | 1,3 | 1,3–1,4 | ~7.700 |
| Spagnolo | 1,4 | 1,4–1,7 | ~7.200 |
| Portoghese | 1,4 | 1,4–1,7 | ~7.000 |
| Francese | 1,4 | 1,4–1,7 | ~6.900 |
| Olandese | 1,6 | 1,6–2,1 | ~6.300 |
| Italiano | 1,7 | 1,7–1,9 | ~6.000 |
| Tedesco | 1,7 | 1,7–2,1 | ~5.800 |
| Norvegese | 1,9 | 1,9–2,2 | ~5.400 |
| Svedese | 1,9 | 1,9–2,3 | ~5.300 |
| Danese | 1,9 | 1,9–2,3 | ~5.300 |
| Rumeno | 1,9 | 1,9–2,2 | ~5.300 |
| Croato | 2,1 | 2,1–2,6 | ~4.800 |
| Polacco | 2,2 | 2,2–2,6 | ~4.500 |
| Greco | 2,4 | 2,4–5,9 | ~4.200 |
| Estone | 2,5 | 2,5–3,1 | ~4.000 |
| Ungherese | 2,6 | 2,5–3,1 | ~3.900 |
| Finlandese | 2,8 | 2,8–3,5 | ~3.600 |
In sintesi: sul tokenizer GPT 4o l’inglese è circa 1,3 token per parola, quindi 10k token sono circa 7.700 parole inglesi. Spagnolo, portoghese e francese seguono da vicino con circa 1,4. Olandese circa 1,6, tedesco e italiano circa 1,7, quindi 10k token sono circa 5.800 parole tedesche. Le lingue nordiche tranne il finlandese stanno intorno a 1,9. Estone circa 2,5 e finlandese il più alto con circa 2,8, quindi 10k token sono solo circa 3.600 parole finlandesi.
Spesso si dice che una parola tedesca fa 3 token. Sui tokenizer moderni misuriamo più 2. Il greco ha l’intervallo grande perché i tokenizer vecchi gestiscono male l’alfabeto greco.
Il documento finlandese, per la stessa lunghezza, usa più token e quindi più elettricità. I g CO2/Wh dalla rete restano quelli della tabella sopra.
Cosa non abbiamo trattato
Qui parliamo dell’elettricità per una risposta a un messaggio.
L’addestramento del modello è avvenuto una volta prima ed è condiviso tra tutti coloro che lo usano. Assegnare il costo di training al tuo prompt sarebbe indovinare, quindi l’abbiamo lasciato fuori.
C’è il costo di fabbricazione delle schede grafiche. Il breakdown Nvidia per una scheda H100: 1.312 kg di equivalente CO2 per 8 GPU, su qualche anno di operazione. Per un prompt porti solo una frazione minima, ben sotto 1 g. Su una rete pulita come la Svezia, quella frazione può avvicinarsi alla CO2 dell’elettricità stessa. Sulla rete tedesca l’elettricità pesa molto di più.
Poi c’è l’acqua. L’affermazione virale che l’IA beve una bottiglia d’acqua viene da una stima del 2023 per GPT 3: circa 500 ml per 20–50 risposte, in data center caldi USA con raffreddamento evaporativo. Google ha misurato 0,26 ml per un prompt testuale Gemini mediano (~cinque gocce). Ma molti data center europei raffreddano con aria esterna e usano quasi nessuna acqua !! Include Hetzner in Germania, dove è hostato DentroChat, e i data center svedesi dove girano parte dei nostri modelli. Ne abbiamo scritto in L’IA spreca acqua? e più in dettaglio in Consumo d’acqua dell’IA: perché i numeri virali fuorviano.
C’è anche questo punto pratico. Se resti nella stessa chat, il documento lungo resta di solito in memoria qualche minuto. Il messaggio successivo elabora soprattutto il testo nuovo. OpenAI e Anthropic parlano entrambi di cache che scadono dopo, tipo, 5–10 minuti di inattività. È la colonna « in cache » della nostra tabella DentroChat. Aiuta anche quando il modello gira più volte per un messaggio, perché la seconda passata può riusare ciò che la prima ha già letto.
Vorremmo ancora mostrarti un wattora reale per ogni messaggio in DentroChat, la migliore chat IA UE. Per farlo, chi esegue i modelli dovrebbe darci l’energia di ogni richiesta, e la maggior parte non lo fa ancora.
Finché non succede, questa è la nostra migliore approssimazione. Su modelli grandi come GPT 4o, un prompt normale usa circa 0,3 wattora e un documento lungo circa 2,5. Un prompt mediano DentroChat sui nostri modelli più piccoli usa circa 0,2–1,3 wattora. Sulla rete media UE è al massimo circa 0,3 grammi di CO2.