¿Está cifrado tu chat de IA? ChatGPT, Lumo y DentroChat
Hace un tiempo, un usuario de DentroChat nos escribió:
Lumo afirma que cifra todas las conversaciones. ¿DentroChat hace lo mismo o tiene un enfoque diferente?
La pregunta me picó un poco, porque en su día escribí mi tesis de licenciatura sobre criptografía, y por una vez quería poner mis ideas por escrito como es debido. Mi respuesta acabó siendo bastante larga y técnica, así que si alguna parte se te hace demasiado densa, quizá lo mejor sea pegar este artículo en Lumo o en DentroChat y dejar que una IA te lo explique con palabras más sencillas :-)
Para dar una respuesta completa sobre cómo funciona el chat de IA cifrado, veamos primero cómo funciona el cifrado de Proton, luego Lumo y después cómo lo hacen DentroChat y ChatGPT.
Cómo funciona el cifrado zero-knowledge de Proton
Somos grandes fans del ecosistema de Proton y lo usamos activamente desde hace años para la VPN, el correo electrónico, las videollamadas y mucho más.
Lo que más atrae de Proton es su esquema zero-knowledge. Los pares de claves pública-privada se derivan de la contraseña de tu cuenta y son únicos para cada usuario. Esa clave privada se usa para cifrar nuestros correos, los archivos de Drive, etc. Solo el usuario, es decir, nosotros, puede descifrar sus propios datos en su dispositivo local. Los empleados de Proton no pueden descifrar nuestros datos porque nunca tienen acceso a nuestra clave privada.
La ventaja es que, aunque la NSA esté “sentada” dentro de un servidor de Proton, no podrá acceder a nuestros datos (al menos mientras se cumplan el resto de supuestos de seguridad). La desventaja es que, si alguna vez perdemos la contraseña de Proton y los códigos de respaldo, y no tenemos configurado ningún método de recuperación, Proton no podrá restaurar nuestros datos.
Si quieres entender desde cero cómo funciona el cifrado de clave pública y privada, este vídeo de YouTube sobre criptografía de clave pública es excelente. Cuando lo vi durante mi primer año de universidad, ¡me voló la cabeza!
Lumo: por qué un LLM cambia el panorama
Lumo es fundamentalmente distinto de otros servicios de Proton por cómo funcionan los modelos de lenguaje de gran tamaño (LLM). Para obtener una respuesta de un modelo de IA o LLM, hay que introducir la entrada en el modelo en texto plano, es decir, descifrado. (Existen enfoques para hacerlo de forma más cifrada, sobre los que volveremos más abajo).
Si ejecutaras un LLM en local, en tu propio ordenador, el enfoque clásico de Proton que acabamos de describir seguiría funcionando: descifras los datos en tu máquina, los pasas a tu LLM local, obtienes una respuesta y vuelves a cifrar los datos localmente. Así es como funciona cuando usas modelos locales con herramientas como Ollama.
El problema es que los mejores LLM necesitan equipos muy potentes, algo que simplemente no es viable en un ordenador de consumo medio. Por eso el LLM tiene que ejecutarse en un servidor de Proton, y tus datos tienen que descifrarse antes de pasar al LLM de Proton.
Qué ocurre cuando envías un mensaje a Lumo
Cuando usas Lumo, el proceso es el siguiente (tal y como se documenta en el modelo de seguridad de Lumo de Proton):
- Descifras el historial de tus chats localmente, en tu dispositivo.
- Añades un nuevo mensaje del usuario.
- Todo el historial de mensajes, junto con tu nuevo mensaje, se cifra con la clave pública del servidor de Proton donde se ejecuta el LLM.
- Tus datos cifrados llegan al servidor de Proton y se descifran con la clave privada de ese servidor. Los datos descifrados se pasan al LLM, que genera una respuesta.
- La respuesta generada se vuelve a cifrar y se te envía.
- La descifras en tu dispositivo y lees la respuesta.
Dadas las limitaciones, es un enfoque muy sólido.
Lo único es que el enfoque ya no es zero-knowledge durante la inferencia. Si la policía suiza, la NSA o un empleado malintencionado de Proton escuchan dentro del servidor donde tus datos se descifran antes de pasar al LLM, pueden leerlos. Lumo no usa cifrado de extremo a extremo (E2EE) como el resto de servicios de Proton, sino algo que la empresa llama cifrado de usuario a Lumo (User-to-Lumo Encryption, U2L). Donde Lumo sigue brillando es en que tu historial de chats guardado se cifra con tu clave en reposo, así que nadie en Proton puede leer después tus conversaciones antiguas.
Cómo lo hace DentroChat
Intentamos diseñar un verdadero cifrado de extremo a extremo para DentroChat y llegamos a una arquitectura muy parecida. Pero, por desgracia, no era viable económicamente para nosotros construirla (todavía).
Nuestro enfoque actual es el cifrado clásico que usan la mayoría de las aplicaciones modernas: cifrado en tránsito y cifrado en reposo:
- Cuando te enviamos tus datos, o cuando tú nos envías tus datos a DentroChat, ese tráfico se cifra en tránsito con TLS (que usa pares de claves pública-privada para establecer la conexión cifrada).
- Cuando tus datos se almacenan en nuestros servidores en Alemania, se cifran en reposo (algo que configuramos y gestionamos nosotros mismos, porque los proveedores de hosting estándar no cifran los discos en reposo por defecto). Si un atacante copia el disco duro de nuestros servidores, solo obtiene datos cifrados.
Elegimos este enfoque porque, en el momento en que la IA responde a tu consulta, mantiene el mismo supuesto de confianza básico que Lumo: tienes que confiar en que no leemos tus datos mientras los procesamos. Nuestro enfoque actual era mucho más sencillo de implementar, mientras que el de Proton es más sofisticado y pone más obstáculos a los atacantes que intentan acceder al historial guardado. Quizá también sigamos ese camino en algún momento si vemos un beneficio claro. De momento, el enfoque de DentroChat es seguro, sólido y lleva años probado en batalla por muchas aplicaciones.
Cómo cifra ChatGPT tus conversaciones (y dónde está la trampa)
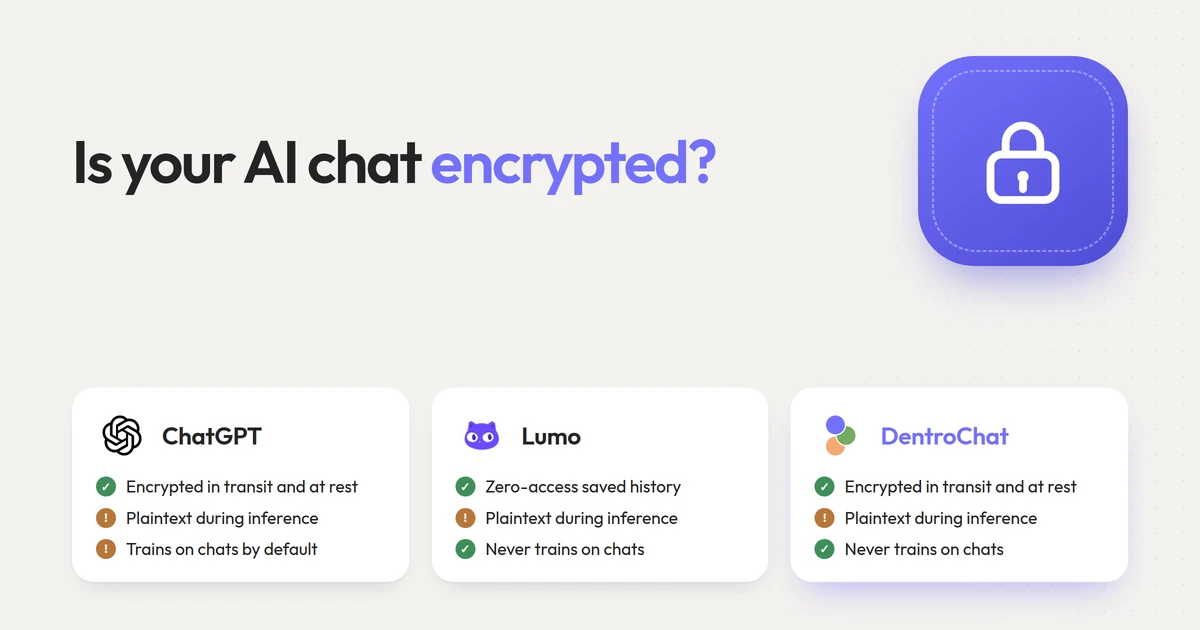
En teoría, ChatGPT usa exactamente los mismos bloques criptográficos que DentroChat y la mayoría del software en la nube: cifrado en tránsito (TLS) entre tu navegador y los servidores de OpenAI, y cifrado en reposo (AES-256) en sus discos. ChatGPT tampoco usa cifrado de extremo a extremo, porque las GPU de OpenAI también necesitan tu consulta en texto plano para generar una respuesta.
La diferencia con ChatGPT está en quién tiene las claves y qué puede hacer OpenAI con tus datos cuando los descifra:
- Entrenamiento de modelos y revisión humana: En ChatGPT Free y Plus, tus conversaciones descifradas se usan por defecto para entrenar futuros modelos de OpenAI, y los revisores humanos pueden leer chats seleccionados al azar, a menos que te desactives manualmente en los ajustes. Ni Lumo ni DentroChat entrenan nunca con tus chats.
- Conservación tras el borrado: Aunque borres un chat o uses el modo “Chat temporal” de ChatGPT, OpenAI conserva una copia en sus servidores durante hasta 30 días (aquí explicamos todos los detalles).
- Exposición a la CLOUD Act de EE. UU.: Como OpenAI tiene las claves de descifrado de tus chats guardados y es una empresa estadounidense, las autoridades de EE. UU. pueden exigir el acceso en virtud de la US CLOUD Act. ¡Incluso si tu espacio de trabajo está configurado con residencia de datos en la UE!
| ChatGPT | Proton Lumo | DentroChat | |
|---|---|---|---|
| Cifrado en tránsito (TLS) | Sí | Sí | Sí |
| Cifrado en reposo | Sí (OpenAI tiene las claves) | Sí (Zero-access, tú tienes las claves) | Sí (DentroChat tiene las claves) |
| Cifrado de extremo a extremo durante la inferencia de IA | No (texto plano en el servidor) | No (texto plano en el servidor, U2L) | No (texto plano en el servidor) |
| Entrena modelos de IA con tus chats | Sí por defecto (desactivable) | Nunca | Nunca |
| Sujeto a la US CLOUD Act | Sí | No para los chats (EE. UU. para facturación y soporte) | No (pila 100 % UE / Suiza) |
Dos formas de conseguir un cifrado de extremo a extremo (casi) real para la IA
¿Se puede ejecutar un LLM en la nube sin que el operador del servidor vea tu consulta en texto plano? Hay dos enfoques para un E2EE real.
1. Cifrado homomórfico
El cifrado homomórfico es un campo de investigación fascinante. Permite realizar cálculos directamente sobre datos cifrados.
Por ejemplo: tú cifras el número 12, y otro usuario cifra el número 17. Ambos números cifrados se suman mediante un cálculo de suma cifrado. El resultado es el número cifrado 29, y solo tú y el otro usuario podéis descifrarlo y saber que el resultado es 29. El servidor que hizo la operación nunca supo que los números eran 12, 17 o 29.
Este ejemplo es sencillo, pero también puede aplicarse a los LLM. En ese caso, introduces datos cifrados en el LLM, el LLM devuelve una respuesta cifrada y solo el usuario puede descifrarla. Hay investigación académica importante en este campo, como este artículo reciente sobre inferencia de LLM cifrada (Cachemir).
El problema del cifrado homomórfico es que es muy costoso computacionalmente y, por tanto, muy lento. Incluso con las mejoras recientes, hablamos de unos 100 segundos de tiempo de GPU por cada token generado, lo que significa que tendrías que esperar 30 minutos para obtener una respuesta sencilla a “¿Cuál es la capital de España?”.
2. GPU NVIDIA H100/H200 de computación confidencial (TEE)
El segundo enfoque consiste en usar GPU NVIDIA H100/H200 de computación confidencial con un entorno de ejecución de confianza (TEE, Trusted Execution Environment).
Funciona así: la GPU tiene su propio par de claves privada-pública integrado directamente en su hardware. Se genera una sola vez, cuando se fabrica la GPU, y una vez creada, la clave privada no puede extraerse desde fuera, ni siquiera por la persona que es dueña del rack del servidor.
Esto es genial, porque ahora puedes cifrar tus datos con la clave pública de la GPU y enviarlos al servidor. La GPU los descifra dentro de su propio enclave de hardware usando su clave privada, los pasa al LLM que se ejecuta dentro de la GPU, vuelve a cifrar la respuesta y te la envía.
De este modo, logramos un E2EE casi real. El único vector de ataque de hardware que queda está en el paso de fabricación: si la NSA registró todas las claves privadas mientras se creaban estas GPU de NVIDIA en la fábrica, teóricamente podría interceptar y descifrar el tráfico más adelante, cuando la GPU esté desplegada. Sin embargo, una GPU NVIDIA con TEE es una suposición de seguridad muy fuerte.
Para DentroChat teníamos dos opciones: comprar nosotros mismos esas GPU o encontrar un proveedor europeo que las ofreciera. La primera era demasiado cara para nosotros: una sola H100 cuesta unos 40.000 €, y para ejecutar grandes modelos de pesos abiertos como los que usamos en DentroChat, necesitaríamos 8. Como empresa autofinanciada, en ese momento no era posible. Encontrar un proveedor europeo con GPU de computación confidencial tampoco era posible hace medio año. Sin embargo, este es el camino más realista hacia el futuro, y buscamos constantemente proveedores europeos de infraestructura de IA que lo soporten.
Por qué creemos que DentroChat es una gran opción junto a Lumo
Incluso sin cifrado zero-access para el historial guardado, hay varias razones por las que muchos usuarios eligen DentroChat en lugar de Lumo:
- Mejores modelos de IA: la última vez que probamos Lumo, la calidad de las respuestas fue bastante pobre y lenta. Con DentroChat tienes acceso a los mejores modelos de código abierto y a un entorno de agentes a medida por debajo.
- Cero subencargados estadounidenses en toda la pila: tanto Lumo como DentroChat ejecutan su inferencia de IA en servidores europeos y suizos. Sin embargo, Lumo sigue enrutando la facturación y el soporte al cliente a través de empresas estadounidenses (como Stripe y Zendesk). En DentroChat no usamos subencargados estadounidenses en ningún punto. Puedes verificar toda nuestra pila en nuestra página de subencargados.
Si quieres comparar ambas opciones con más detalle, consulta nuestra prueba completa de alternativas a Lumo, nuestra guía sobre chat de IA privado o cómo se comparan las alternativas europeas a ChatGPT. Y si tienes una pregunta técnica como esta, ¡no dudes en escribirnos desde el botón de comentarios de DentroChat!
Preguntas frecuentes
¿ChatGPT está cifrado de extremo a extremo?
No. OpenAI cifra tus conversaciones en tránsito (TLS) y en reposo en sus servidores, que es el estándar básico de las aplicaciones en la nube. Como el LLM necesita texto plano para generar una respuesta, los servidores de OpenAI descifran tu consulta para procesarla. Salvo que tengas un plan de empresa o te desactives de forma explícita, las conversaciones de usuarios particulares también pueden usarse para entrenar modelos.
¿Proton Lumo está cifrado de extremo a extremo?
No de extremo a extremo. Lumo usa lo que Proton llama cifrado de usuario a Lumo (User-to-Lumo, U2L): tu historial guardado está protegido con cifrado zero-access, así que Proton no puede leer tus chats antiguos, y tu consulta se cifra hasta llegar al servidor de inferencia. Sin embargo, el servidor de GPU de Proton tiene que descifrar tu mensaje en memoria para pasarlo al LLM.
¿Cómo cifra DentroChat mis conversaciones?
DentroChat cifra todo el tráfico en tránsito con TLS y guarda tus conversaciones y archivos con cifrado en reposo gestionado por nosotros mismos, en servidores europeos en Alemania y Francia. Al igual que en Lumo y ChatGPT, las consultas deben descifrarse en la memoria del servidor durante la inferencia para que el modelo de IA pueda responderlas, y nunca entrenamos con tus datos.
¿Puede un chat de IA estar alguna vez realmente cifrado de extremo a extremo?
Sí, ejecutando un modelo pequeño en tu propio ordenador o en la nube mediante cifrado homomórfico o GPU NVIDIA de computación confidencial (TEE). Hoy en día, el cifrado homomórfico sigue siendo demasiado lento para un chat interactivo, mientras que las GPU de computación confidencial son el camino más prometedor una vez que los proveedores de hosting europeos las ofrezcan de forma amplia.