La tua chat IA è cifrata? ChatGPT, Lumo e DentroChat
Qualche tempo fa, un utente di DentroChat ci ha scritto:
Lumo dichiara di cifrare tutte le conversazioni. DentroChat fa lo stesso o ha un approccio diverso?
Quella domanda mi ha un po’ punto sul vivo, perché ai tempi ho scritto la mia tesi di laurea triennale sulla crittografia, e per una volta volevo mettere per iscritto le mie riflessioni come si deve. La mia risposta è diventata piuttosto lunga e tecnica, quindi se qualche passaggio ti sembra troppo denso, forse la cosa migliore è incollare questo articolo in Lumo o in DentroChat e farti spiegare tutto in termini più semplici da un’IA :-)
Per rispondere in modo completo a come funziona una chat IA cifrata, partiamo dalla cifratura di Proton, poi passiamo a Lumo, e infine vediamo come fanno DentroChat e ChatGPT.
Come funziona la cifratura zero-knowledge di Proton
Siamo grandi fan dell’ecosistema Proton e lo usiamo attivamente da anni per VPN, email, videochiamate e molto altro.
Il grande punto di forza di Proton è la sua architettura zero-knowledge. Le coppie di chiavi pubblica e privata vengono derivate dalla password del tuo account e sono uniche per ogni utente. Questa chiave privata serve a cifrare le nostre email, i contenuti di Drive e così via. Solo l’utente, quindi noi, può decifrare i propri dati sul dispositivo locale. I dipendenti di Proton non possono decifrare i nostri dati, perché non accedono mai alla nostra chiave privata.
Il vantaggio è che, anche se la NSA fosse “appostata” dentro un server di Proton, non riuscirebbe a ottenere i nostri dati (almeno finché tutte le altre ipotesi di sicurezza reggono). Lo svantaggio è che, se un giorno perdessimo la password di Proton e i codici di backup, senza un metodo di recupero configurato, Proton non sarebbe in grado di ripristinare i nostri dati.
Se vuoi capire da zero come funziona la cifratura a chiave pubblica e privata, questo video su YouTube sulla crittografia a chiave pubblica è fantastico. Quando l’ho guardato durante il primo anno di università, mi ha davvero fatto saltare sulla sedia!
Lumo: perché un LLM cambia le carte in tavola
Lumo è sostanzialmente diverso dagli altri servizi di Proton per via del modo in cui funzionano i Large Language Model (LLM). Per ottenere una risposta da un modello IA o LLM, devi fornire l’input al modello in chiaro, cioè decifrato. (Esistono approcci per farlo in modo più cifrato, ne parleremo più avanti.)
Se facessi girare un LLM in locale, sul tuo computer, l’approccio classico di Proton descritto sopra continuerebbe a funzionare: decifri i dati in locale sulla tua macchina, li passi al tuo LLM locale, ottieni una risposta e cifri di nuovo i dati in locale. È così che funziona quando usi modelli locali con strumenti come Ollama.
Il problema è che i migliori LLM richiedono macchine molto potenti, cosa che sul computer di un utente medio semplicemente non è fattibile. Quindi l’LLM deve girare su un server di Proton, e i tuoi dati devono essere decifrati prima di essere passati all’LLM di Proton.
Cosa succede quando invii un messaggio a Lumo
Quando usi Lumo, il funzionamento è questo (come documentato nel modello di sicurezza di Lumo di Proton):
- Decifri la cronologia delle tue chat in locale, sul tuo dispositivo.
- Aggiungi un nuovo messaggio utente.
- L’intera cronologia dei messaggi, insieme al tuo nuovo messaggio, viene cifrata con la chiave pubblica del server Proton su cui gira l’LLM.
- I tuoi dati cifrati arrivano al server Proton e vengono decifrati con la chiave privata di quel server. I dati decifrati vengono passati all’LLM, che genera una risposta.
- La risposta generata viene cifrata di nuovo e inviata a te.
- La decifri sul tuo dispositivo e leggi la risposta.
Visti i vincoli, è un approccio molto solido.
L’unica cosa è questa: durante l’inferenza, l’approccio non è più zero-knowledge. Se la polizia svizzera, la NSA o un dipendente di Proton senza scrupoli ascolta dentro il server dove i tuoi dati vengono decifrati prima di essere passati all’LLM, può leggerli. Lumo non usa la cifratura end-to-end (E2EE) come gli altri servizi di Proton, ma quella che l’azienda chiama User-to-Lumo Encryption (U2L). Dove Lumo continua a brillare è nel fatto che la cronologia delle tue chat salvate è cifrata a riposo con la tua chiave, quindi nessuno in Proton può leggere in seguito le tue vecchie conversazioni.
Come fa DentroChat
Abbiamo cercato di trovare un modo per garantire una vera cifratura end-to-end per DentroChat, e siamo arrivati a un’architettura molto vicina a quell’obiettivo. Purtroppo, però, non era economicamente sostenibile per noi costruirla (per ora).
Il nostro approccio attuale è la cifratura classica usata dalla maggior parte delle app moderne: cifratura in transito e cifratura a riposo:
- Quando ti inviamo i tuoi dati, o quando tu invii a DentroChat i tuoi dati, questo traffico viene cifrato in transito con TLS (che usa coppie di chiavi pubblica e privata per stabilire la connessione cifrata).
- Quando i tuoi dati sono memorizzati sui nostri server in Germania, vengono cifrati a riposo (una configurazione che gestiamo e controlliamo direttamente, perché i normali provider di hosting non cifrano i dischi a riposo per impostazione predefinita). Se un attaccante copiasse il disco rigido dei nostri server, otterrebbe solo dati cifrati.
Abbiamo scelto questo approccio perché, nel momento in cui l’IA risponde al tuo prompt, vale la stessa ipotesi di fiducia di base che vale per Lumo: devi fidarti del fatto che non leggiamo i tuoi dati mentre li elaboriamo. Il nostro approccio attuale era molto più semplice da implementare, mentre quello di Proton è più sofisticato e frappone più ostacoli ai potenziali attaccanti che puntano alla cronologia salvata. Potremmo anche seguire la loro strada in futuro, se vedessimo un vantaggio chiaro. Per ora, l’approccio di DentroChat è sicuro, solido e collaudato sul campo da molte applicazioni nel corso degli anni.
Come ChatGPT cifra le tue conversazioni (e dove sta il trucco)
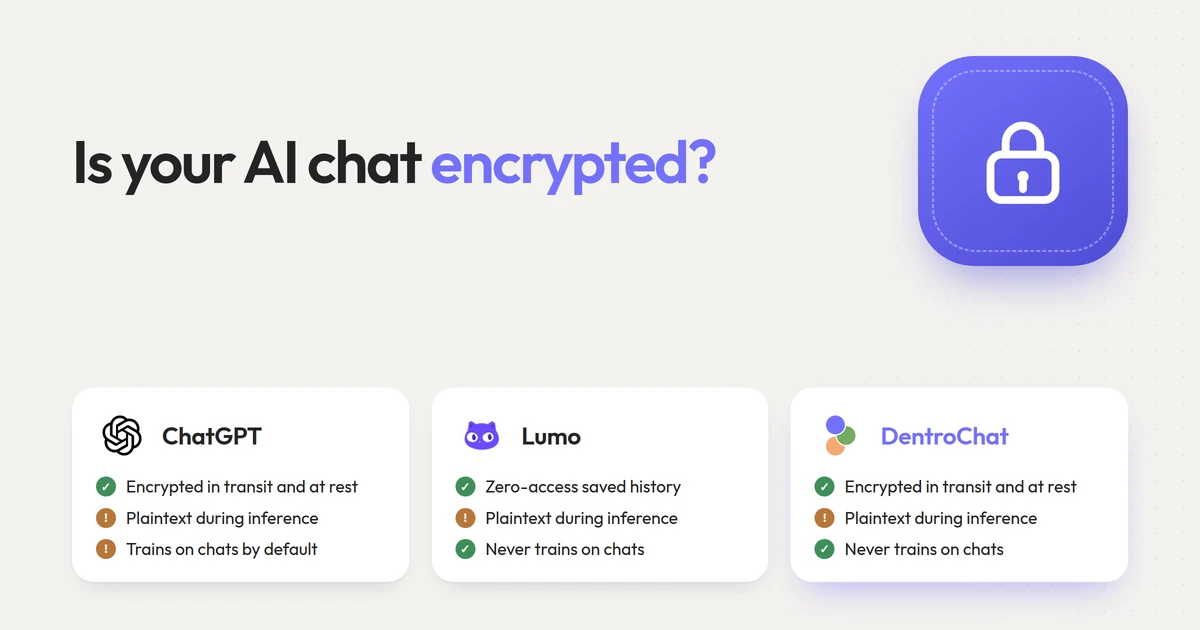
Sulla carta, ChatGPT usa esattamente gli stessi elementi crittografici di DentroChat e della maggior parte del software cloud: cifratura in transito (TLS) tra il tuo browser e i server di OpenAI, e cifratura a riposo (AES-256) sui loro dischi. Nemmeno ChatGPT usa la cifratura end-to-end, perché anche le GPU di OpenAI hanno bisogno del tuo prompt in chiaro per generare una risposta.
La differenza con ChatGPT sta in chi detiene le chiavi e cosa OpenAI può fare con i tuoi dati una volta decifrati:
- Addestramento dei modelli e revisione umana: Con ChatGPT Free e Plus, le tue conversazioni decifrate vengono usate per impostazione predefinita per addestrare i futuri modelli di OpenAI, e le chat campionate possono essere lette da revisori umani, a meno che tu non ti disattivi manualmente nelle impostazioni. Né Lumo né DentroChat si addestrano mai sulle tue chat.
- Conservazione dopo l’eliminazione: Anche se elimini una chat o usi la modalità “Chat temporanea” di ChatGPT, OpenAI conserva una copia sui suoi server per un massimo di 30 giorni (qui abbiamo spiegato tutti i dettagli).
- Esposizione al US CLOUD Act: Poiché OpenAI detiene le chiavi di decifratura delle tue chat salvate ed è un’azienda statunitense, le autorità USA possono esigere l’accesso in base allo US CLOUD Act. Anche se il tuo workspace è impostato con la residenza dei dati nell’UE!
| ChatGPT | Proton Lumo | DentroChat | |
|---|---|---|---|
| Cifrata in transito (TLS) | Sì | Sì | Sì |
| Cifrata a riposo | Sì (OpenAI detiene le chiavi) | Sì (Zero-access, le chiavi le hai tu) | Sì (DentroChat detiene le chiavi) |
| Cifrata end-to-end durante l’inferenza IA | No (in chiaro sul server) | No (in chiaro sul server, U2L) | No (in chiaro sul server) |
| Addestra i modelli IA sulle tue chat | Sì per impostazione predefinita (disattivabile) | Mai | Mai |
| Soggetta al US CLOUD Act | Sì | No per le chat (USA per fatturazione e supporto) | No (stack 100% UE / Svizzera) |
Due strade per ottenere una cifratura end-to-end (quasi) reale per l’IA
Quindi è possibile far girare un LLM nel cloud senza che l’operatore del server veda il tuo prompt in chiaro? Esistono due approcci per un vero E2EE.
1. Crittografia omomorfa
La crittografia omomorfa è un campo di ricerca affascinante. Permette di eseguire calcoli direttamente su dati cifrati.
Ad esempio: tu cifri il numero 12, e un altro utente cifra il numero 17. I due numeri cifrati vengono sommati tramite un calcolo di addizione cifrato. Il risultato è il numero cifrato 29, e solo tu e l’altro utente potete decifrarlo e scoprire che il risultato è 29. Il server che ha fatto il calcolo non ha mai saputo che i numeri erano 12, 17 o 29.
Questo esempio è semplice, ma può funzionare anche per gli LLM. In quel caso, inserisci dati cifrati nell’LLM, l’LLM restituisce una risposta cifrata, e solo l’utente può decifrarla. Su questo fronte c’è una ricerca accademica molto importante, come questo recente articolo sull’inferenza di LLM cifrata (Cachemir).
Il problema della crittografia omomorfa è che è computazionalmente molto costosa, quindi molto lenta. Anche con le recenti accelerazioni, si parla di circa 100 secondi di tempo GPU per ogni token generato, il che significa che dovresti aspettare 30 minuti per una risposta semplice a “Qual è la capitale della Spagna?”.
2. GPU NVIDIA H100/H200 Confidential Computing (TEE)
Il secondo approccio consiste nell’usare GPU NVIDIA H100/H200 Confidential Computing con un Trusted Execution Environment (TEE).
Funziona così: la GPU ha una propria coppia di chiavi privata e pubblica integrata direttamente nell’hardware. Viene creata una sola volta, durante la produzione della GPU, e una volta creata la chiave privata non può essere estratta dall’esterno, nemmeno dalla persona che possiede il rack del server.
Questo è fantastico, perché ora puoi cifrare i tuoi dati con la chiave pubblica della GPU e inviarli al server. La GPU li decifra all’interno del proprio enclave hardware usando la chiave privata, li passa all’LLM che gira dentro la GPU, cifra di nuovo la risposta e te la rimanda.
In questo modo otteniamo un E2EE quasi reale. L’unico vettore di attacco hardware rimasto è nella fase di produzione: se la NSA avesse registrato tutte le chiavi private mentre queste GPU NVIDIA venivano create in fabbrica, teoricamente potrebbe intercettare e decifrare il traffico più avanti, quando la GPU è in funzione. Tuttavia, una GPU NVIDIA con TEE è un’ipotesi di sicurezza molto forte.
Per DentroChat avevamo due opzioni: comprare noi stessi queste GPU oppure trovare un provider europeo che le offrisse. La prima era troppo costosa per noi: una sola H100 costa circa 40.000 €, e per far girare grandi modelli a pesi aperti come quelli che usiamo in DentroChat ne servirebbero 8. Come azienda autofinanziata, in quel momento non era possibile. Trovare un provider europeo con GPU per il Confidential Computing non era possibile nemmeno sei mesi fa. Tuttavia, questa è la strada più realistica per il futuro, e stiamo cercando costantemente provider europei di infrastruttura IA che la supportino.
Perché pensiamo che DentroChat sia un’ottima scelta accanto a Lumo
Anche senza una cifratura zero-access per la cronologia salvata, ci sono diversi motivi per cui molti utenti scelgono DentroChat al posto di Lumo:
- Modelli IA migliori: l’ultima volta che abbiamo testato Lumo, la qualità delle risposte era piuttosto deludente e lenta. Con DentroChat ottieni accesso ai migliori modelli open source e a un agent harness su misura sotto il cofano.
- Zero subprocessori statunitensi in tutto lo stack: sia Lumo che DentroChat eseguono l’inferenza IA su server europei e svizzeri. Tuttavia, Lumo instrada ancora fatturazione e assistenza clienti attraverso aziende statunitensi (come Stripe e Zendesk). In DentroChat non usiamo subprocessori statunitensi in nessun punto. Puoi verificare l’intero stack nella nostra pagina dei subprocessori.
Se vuoi confrontare i due servizi più nel dettaglio, dai un’occhiata al nostro test completo delle alternative a Lumo, alla nostra guida sulla chat IA privata o a come si posizionano le alternative europee a ChatGPT. E se hai una domanda tecnica come questa, non esitare a scriverci tramite il pulsante di feedback in DentroChat!
Domande frequenti
ChatGPT è cifrata end-to-end?
No. OpenAI cifra le tue conversazioni in transito (TLS) e a riposo sui suoi server, che è lo standard minimo per le app cloud. Poiché l’LLM ha bisogno del testo in chiaro per generare una risposta, i server di OpenAI decifrano il tuo prompt per elaborarlo. A meno che tu non abbia un piano business o non ti disattivi esplicitamente, le conversazioni degli utenti consumer possono anche essere usate per addestrare i modelli.
Proton Lumo è cifrata end-to-end?
Non end-to-end. Lumo usa quella che Proton chiama cifratura User-to-Lumo (U2L): la tua cronologia salvata è protetta con cifratura zero-access, quindi Proton non può leggere le tue vecchie chat, e il tuo prompt viene cifrato fino al server di inferenza. Tuttavia, il server GPU di Proton deve comunque decifrare il tuo messaggio in memoria per passarlo all’LLM.
Come cifra DentroChat le mie conversazioni?
DentroChat cifra tutto il traffico in transito con TLS e memorizza le tue conversazioni e i tuoi file con una cifratura a riposo gestita da noi, su server europei in Germania e Francia. Come con Lumo e ChatGPT, durante l’inferenza i prompt devono essere decifrati nella memoria del server affinché il modello IA possa rispondere, e non addestriamo mai i modelli sui tuoi dati.
Una chat IA può mai essere davvero cifrata end-to-end?
Sì, facendo girare un modello piccolo in locale sul tuo computer, oppure nel cloud usando la crittografia omomorfa o GPU NVIDIA Confidential Computing (TEE). Oggi la crittografia omomorfa è ancora troppo lenta per una chat interattiva, mentre le GPU Confidential Computing rappresentano la strada più promettente, una volta che i provider di hosting europei le renderanno ampiamente disponibili.